故障注入实测AI自动修复流水线
作者在预发布环境故意引入搜索异常,系统在42秒后生成修复请求,31分钟后产出含修复和测试的待审PR。流程中由人工完成两次决策,展示了从错误发现到补丁审查的修复链路。
AI 深度解读
故意把预发布环境弄坏,再看 AI 能不能发现、定位并修复,这是作者检验自动维护流水线的方法。一次植入真实缺陷的演练中,系统在首个错误出现后 42 秒生成修复请求,31 分钟交出可供审查的 PR,消耗 $2.45 的 agent 额度。
这个案例值得读,不是因为它证明了 AI 可以接管维护,而是它暴露了自动修复最容易被忽略的环节:读错分支、误判恢复、重复构建,以及告警耗尽。能生成补丁,只是其中一步。
两个人工关口,怎样串起自动修复
作者把工作拆给两个服务。Night Watch 监控日志和检查结果,创建事件,请 AI 做初步诊断,再通过 email、Telegram 和 Slack 通知人。Day Shift 接收修复请求,编写规格,在独立工作区实现修改,运行项目检查,让第二个 agent 审查,最后部署到 staging。
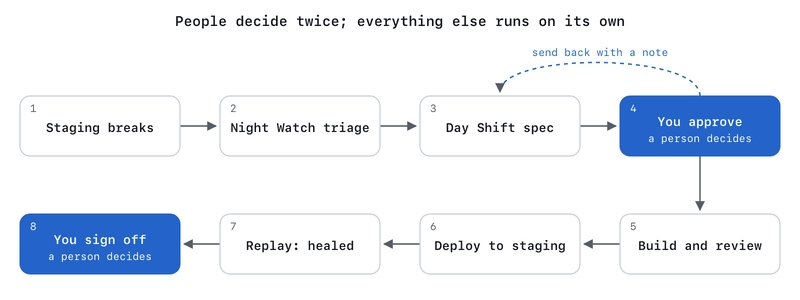
人保留两个关口:先判断修复规格是否正确,再判断结果是否达到交付要求。这里的规格,就是动代码前写清楚「坏在哪里、准备怎样修」。
流程由普通代码控制;每个 agent 步骤都由自身之外的机制检查,执行过程也会记录下来,支持中断后恢复。作者没有展开这些检查的具体实现,因此不能把「有检查」直接理解成「检查足够可靠」。
作者的理由很直接:既然 AI 已经编写了他们的大部分代码,就需要一套机制接住它的错误。但允许 AI 自行工作,仍然要靠明确的边界和验证。
为什么要真的埋一个 bug
他们先给 UseHourly 的 staging 加了演练开关。一条命令可以让健康检查返回 503、延迟响应,或让一次数据调用失败,持续最多 15 分钟。开关仅在 staging 构建中生效,需要长 token,启动和停止都会写日志。原文没有给出具体命令。
这能检查单元测试覆盖不到的链路:错误有没有进入日志,告警能不能送达,人能不能据此行动。但开关造成的故障,正确处理往往只是关闭开关,无法证明系统会修代码。
于是作者在临时分支植入真实缺陷,并提前写好标准答案。
2026 年 10 月 24 日 17:45,搜索框开始崩溃。一次数据库读取跳过了已归档客户,搜索结果却仍可能包含他们的条目,随后读取客户名称时触发:
Cannot read properties of undefined (reading 'name')
系统没有收到人工提示,42 秒后提交修复请求,31 分钟后产出一个包含单行修复和验证测试的 PR。最终补丁与预先写好的答案逐行一致。期间,人退回过一次规格并指出原因,随后作出批准。
这证明该流水线完成过一次真实缺陷修复,还不能证明它能稳定处理不同类型的故障。
最难的不是修代码,而是证明修好了
这次演练最有价值的发现,是恢复判定出了问题。
Day Shift 等待 Night Watch 确认事件恢复;Night Watch 则要观察错误停止。可 staging 没有流量,没有新错误既可能代表恢复,也可能只是没人触发。15 分钟后,Day Shift 判定「未恢复」,把同一个修复又构建了一遍。
最后,他们引用失败请求的重放结果,手动关闭事件,第二次构建才通过。
自动修复需要重放原先失败的请求,不能只靠日志安静来证明成功。
另一个问题发生得更早:编写规格的 agent 读取了 main,而非带缺陷的分支。它找对了位置,却猜错原因,需要人工纠正。诊断能力再强,输入代码版本不对,结论也可能偏离现场。
周边工具同样出了岔子。每天 20 封邮件的预算,被一次异常启动用掉 16 封,因此演练与真实事件应分开计算额度。通过 git 列举文件的测试,在 git hook 中运行时找不到文件;一个密钥被保存成粘贴的命令,直到邮件发送失败才暴露。
本次实测是 31 分钟、$2.45。作者估算,去掉两段等待后约需 12 分钟,但这个数字不是优化后的复测结果。
他们还做了独立的容量验证:staging 装入 10,000 个真实感账户,共 257 万条记录、66,881 张发票,占用 1.74 GB。最重账户各页面的数据耗时低于 0.2 秒;一个仅所有者可用的报表,通过两个小索引从 2.9 秒降到 0.27 秒。这里衡量的是数据耗时,不能直接当成前端完整加载时间。
我的判断
我认可作者把重点放在演练和恢复证据上。对自动维护而言,「补丁看起来合理」与「原来的问题确实消失」是两项检查。第二个 agent 审查有帮助,但失败请求重放更直接地检验了目标行为。
不过,两个人工关口是否足够,仍取决于项目风险、测试覆盖和部署范围。文中完成的是 staging 演练,没有提供生产环境长期运行结果,也没有与人工修复或普通 CI 流程比较。速度和成本目前都是单次案例数据。
相比直接让 agent 根据报错改代码,这套方案补上了监控、规格、隔离工作区和恢复确认,流程更完整;代价是这些环节本身也要维护。本次重复构建就说明,编排逻辑出错也会增加成本。
作者计划增加合成用户旅程、预埋缺陷库和夜间评分,每晚让一个 bug 跑完整个循环,记录诊断、规格、隐藏检查和费用。「10 个修好 7 个、中位数 14 分钟、每个 $3」只是目标指标的示例,并非已有成绩。Day Shift 和 Night Watch 也尚未开源,作者准备等数据足够有说服力后再公布。
能拿来做什么
- 给搜索等关键链路保存可重放的失败请求。前端报错关联到 Node 接口时,修复后应验证同样的请求和数据条件,不能只检查新日志里有没有异常。
- 在 AI 编写修复规格前,明确提供故障对应的分支或提交,并检查它实际读取的版本。先让它解释原因,再审阅改动方向。
- 在 staging 设置有时间上限的故障演练,并为演练单独分配告警预算。除了测试接口失败,也要确认通知是否送达、恢复是否能被正确识别。
- 为自动修复保存每次运行的结果,包括人工退回、重复执行、耗时和费用。等积累多类缺陷的数据后,再决定是否减少人工关口。