litmus-lite 把故障注入带到开发环境
litmus-lite 以单个静态二进制提供故障注入和断言检查,无需集群或控制平面。开发者可通过 MCP 客户端让代理生成故障配置,测试服务在延迟等异常下的表现与恢复速度。
AI 深度解读
重试、超时、降级都写好了,依赖真的变慢或挂掉时,服务还能撑住吗?LitmusChaos 的两位联合创始人推出了 litmus-lite:把故障注入搬到开发者本机,让开发者和 AI Agent 在合并代码前,验证服务能否承受故障、多久恢复。
它最有用的设计,是把自然语言要求变成可提交的测试文件,再用明确条件判定成败。对经常让 AI 补重试逻辑、写接口兜底的程序员,这提供了一种检查生成结果的办法。
AI 负责写场景,文件才是测试
作者此前参与创建的 LitmusChaos 已成为 CNCF 孵化项目,主要服务于 Kubernetes 上的 SRE 和平台团队。litmus-lite 切入的是更早的一步:开发者准备提交 PR,想验证一次依赖故障,却不想为此准备集群或协调平台团队。
它以单个静态二进制运行,不需要集群、控制平面或账号。
在 Cursor 或其他 MCP 客户端里,开发者可以要求:给 checkout API 增加 800 ms 延迟,持续 12 秒,检查它能否承受以及恢复需要多久。Agent 随后在服务旁生成 *.chaos.yaml,验证并执行场景,再按其中的假设汇报结果。
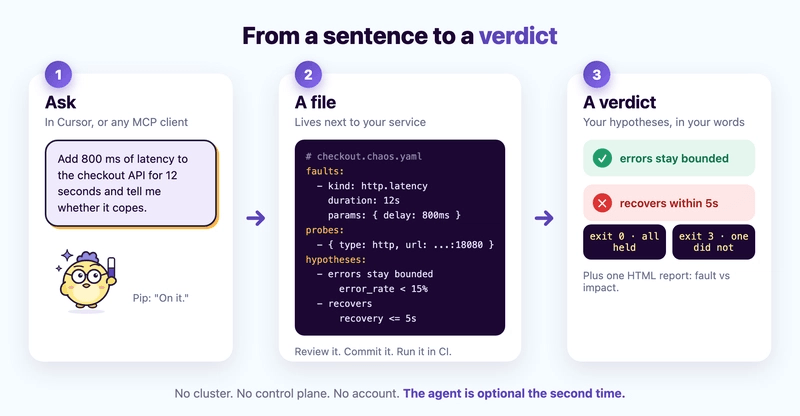
可复用的成果是场景文件。
这个文件可以提交、评审、修改参数,也能脱离 Agent 再次运行。作者强调,每个 MCP 工具都对应一条可手动执行的 CLI 命令。AI 降低了编写门槛,测试过程仍然可以检查和复现。
接入入口是 litmus-lite init,它会为 Cursor 配置 MCP server 和规则,其他 MCP 客户端也能使用。原文称可以在五分钟内尝试,但没有给出不同环境下的安装耗时实测。
先写清什么算通过,再制造故障
litmus-lite 不给服务打一个「韧性 73 分」的综合分数。开发者需要先提出可检验的条件,例如 error_rate < 15%,或者 recovery <= 5s。
这相当于把「应该没问题」改成「错误率必须低于多少、恢复必须快于多少」。阈值可以讨论,结果也有明确含义。
工具还约定了两个容易被忽略的失败情况:没有观测数据算失败;服务一直没回来,会判为 not recovered。否则,探测没采到数据就可能被误读成没有错误。
快速入门包含示例服务的一次通过和一次失败。下面这条输出说明,场景要求错误率低于 5%,实际却达到了 100.00%:
Hypothesis charge survives its own outage failed: error_rate < 5% (observed 100.00%).
要看的是 observed 100.00%:它说明断言为何失败。不过,原文没有交代错误率的具体采样窗口和计算细节,团队采用前仍需确认这些口径。
每次执行还会生成一份自包含 HTML 报告,将故障发生过程与服务受到的影响放在一起展示。作者展示的失败案例中,示例服务没有 fallback,报告也反映了这一点。
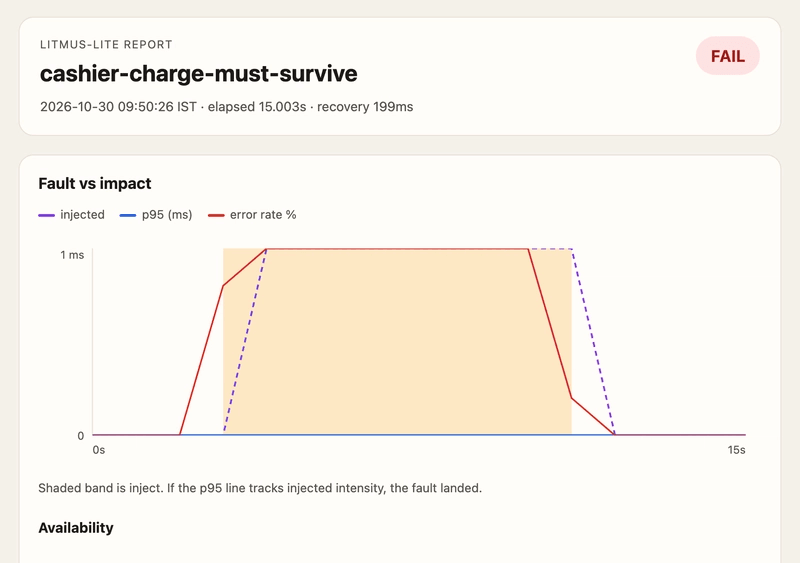
能进 CI,但生成工作流不等于跑完故障测试
场景文件随代码进入仓库,也能在终端或 CI 中执行。-junit 用于对接测试报告;退出码 0 表示所有假设成立,3 表示执行完成但至少一个假设失败。后者是服务行为的发现,不能直接当作工具自身报错。
litmus-lite ci github 可以生成工作流。这里有个范围要分清:原文明确承诺的是每次 push 都验证场景,没有说生成的工作流会自动启动服务、准备流量并完整执行所有故障实验。
目前列出的故障包括:通过内置代理制造 HTTP 延迟、错误和超时,使用 failpoint,以及进程暂停或终止、docker pause、CPU 和内存压力、磁盘填满。
其中 Go 服务可以引入一个小型 failpoint 包,在业务代码内放置默认不生效的钩子,由场景激活。这样就能精准让「扣款步骤」失败。原文没有提供 Node 的同类包,不能据此认为不同语言都有相同接入方式。
若要观察请求流量受到什么影响,还需要配合 VegaLoad、k6 或自定义压测命令。故障注入和流量生成是两项工作。
作者也说明了执行边界:目标限于 loopback,PID 需要明确指定,不可逆操作要求 -yes,Agent 不能自行授予破坏性权限;工具退出或收到 Ctrl-C 时会回滚故障。不过,回滚故障不能让已经终止的进程恢复原有内存状态。工具默认没有遥测,数据默认不离开本机。
我的判断
我认同它把故障测试放到 PR 之前,也认同用明确断言替代模糊评分。尤其在 AI 编程场景中,「生成了重试代码」和「重试确实有效」之间,需要可重复的验证。
相比一次性脚本,它的价值在于统一场景文件、判定和报告;相比面向集群的 LitmusChaos,它更贴近本地开发。但本机测试能证明的范围有限,无法直接覆盖生产环境的网络拓扑、资源争抢和真实请求分布。
作者给出的是工具能力与示例演示,没有给出减少线上事故的对照数据。
请求头和请求体探测、JSON 断言、TCP 探测、按探针分别设置假设和报告、发布容器镜像以运行集群内 Job,以及触达 VM 应用和衔接更大规模 Kubernetes 实验,都还是方向。作者明确说了,这是想法,不是承诺。
能拿来做什么
- 给 Node 服务新增重试、超时或 fallback 后,可以先针对依赖的 HTTP 延迟、错误和超时分别设计场景,检查最终响应是否符合预期;涉及代码内部精确注入时,先确认语言支持。
- 让 AI 编写场景时,把错误率和恢复时限一并写进要求,评审生成的假设是否对应业务目标,再将
*.chaos.yaml随 PR 提交。 - 接入 CI 时,区分场景验证与完整故障执行,检查服务启动、测试流量、报告收集和退出码
3的处理是否齐全。