用 BMAD 把模糊需求落成完整应用
作者以 Angular 与 Firebase 构建的 MemoIt 为例,展示从需求梳理到项目复盘的 BMAD 工作流。全过程使用 Claude Code 执行命令,代码及过程文档均提供仓库供查阅。
AI 深度解读
一个只有笔记、待办和愿望清单的小应用,值得安排产品经理、架构师、开发和三名审查员吗?作者用 MemoIt 跑了一遍 BMAD:从一句模糊需求出发,完成 7 个 epic、22 个 story,最后得到可运行的应用,也付出了约两天时间和多次等待用量恢复的成本。
这次实践最有用的发现,是先用可点击原型确认产品,再让代理按文档开发。流程确实抓出了并发、加载状态和极端日期问题,但没有消除人工判断,也没有包办视觉验收。
为什么文件比聊天记录更适合交接
MemoIt 使用 Angular,后端只有 Firebase Auth、Firestore 和 Hosting。它优先适配手机,也支持平板和桌面。账号由人在 Firebase 控制台手动创建,没有注册和共享,每个用户的数据彼此隔离。
作者使用 Claude Code 执行 slash commands,但 BMAD 的方法并不绑定它,也可以配合 GitHub Copilot 等工具。支撑流程的是 skills 和落盘文档:分析师澄清需求,产品经理维护 PRD,UX 定义交互,架构师固定约束,再拆任务、开发、审查和回顾。
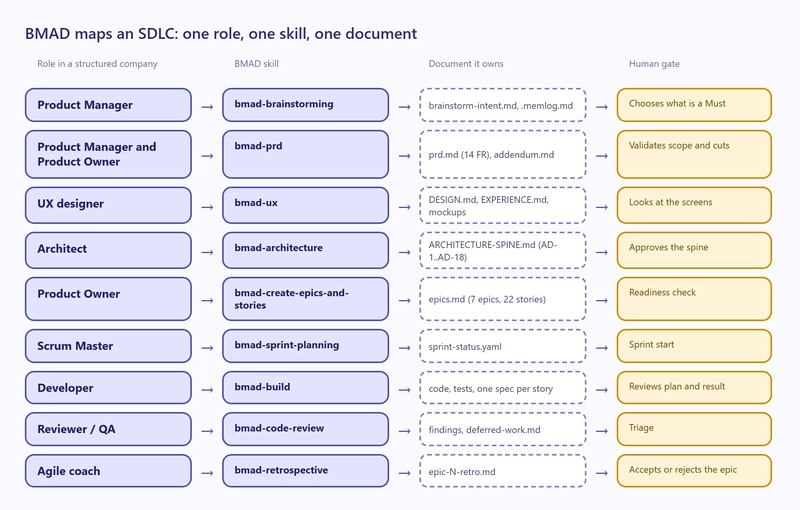
这里最关键的规则是:下游发现需求缺口,要回到上游文档修正,再重新生成派生文档。作者每个规划步骤都先执行 /clear,开新聊天,让文件承担记忆。
一个具体误会说明了它的价值。头脑风暴最初把「家庭共享」列为 Must,追问后才发现,作者要的是家人各自登录、数据隔离。若不及时纠正,后续权限模型就可能走偏。
/bmad-prd 最终整理出 FR-1 到 FR-14,以及 9 项非功能需求。作者再用 /bmad-prd remove push, put push and offline as deferred nice-to-have 延后推送和离线,架构也因此无需支持推送的服务端。
UX 阶段通过 /bmad-ux 生成描述外观的 DESIGN.md、描述行为的 EXPERIENCE.md,并补充 HTML mockup 和导航说明,采用可配置多色的 Material 3。作者看到页面后,才提出每屏都要能退出登录等要求。
随后,/bmad-architecture 把关键约束整理成 18 条 AD-n。AD-3 限定只用 Auth、Firestore 和 Hosting,项目检查发现 functions/ 目录就会失败。约束由此变成可检查的规则。
版本也需要核验。按作者当次查询包注册表的结果,TypeScript 7 已存在,但 Angular 22 只接受 6.0,因此锁定到 6.0.3。这是原文记录的兼容性结论,不能直接当作其他项目的升级依据。
为什么要在拆出 22 个 story 前做原型
作者在 UX、架构完成后,拆 epic 和 story 之前,额外插入了一步:生成单文件原型。这并非 BMAD 的标准路径。
下面这条命令解决的是行为验证,让人能真正走一遍产品流程:
/bmad-build create a clickable prototype of MemoIt in one HTML file, using the
mockups of the UX section, with login, categories, items, report and settings.
Data in memory only, no backend.
要看最后一行:数据只放内存,不接后端,刷新即可恢复初始状态。原型位于 doc/,无需先创建 Firebase 项目。
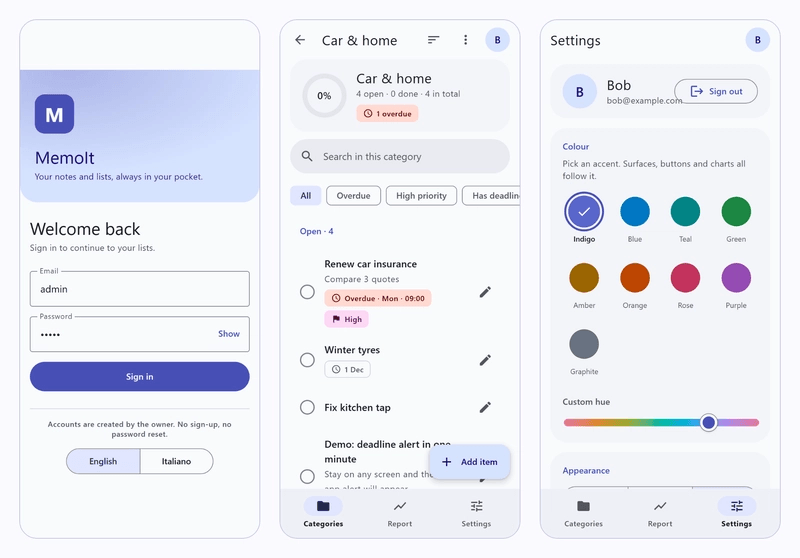
静态稿能确认布局,却很难验证点击完成、撤销、筛选、排序、截止日期和应用内提醒是否符合预期。作者在浏览器里还发现了手机字段越界、按钮没有按条件隐藏、示例数据不一致等问题。
原型的价值在于让产品负责人提前判断「这是不是我要的」。架构师也能看到自己需要支持的实际行为。发现问题后,先改原型和文档,再生成任务,避免错误假设进入 22 个 story。
让人先确认可操作的行为,再扩大自动实现的范围。
作者没有把项目重做一遍,因此无法给出节省工时的数据。「提前修正更便宜」有合理的工程解释,但这次实践没有量化它便宜多少。
三名审查员抓到了什么,又漏掉了什么
/bmad-create-epics-and-stories 生成了按依赖排序的 7 个 epic、22 个 story,每项功能需求至少由一个 story 覆盖。Story 1.1 就包括脚手架和 Firestore emulator 规则测试,作为 Could 的 PWA 排在最后,可以跳过。
作者依次执行 /bmad-sprint-planning check implementation readiness 和 /bmad-sprint-planning run sprint planning。检查返回 PASS,随后生成 sprint-status.yaml,登记任务和 7 次回顾。
实现阶段按 story 重复调用,例如 /bmad-build 3-3-mark-done-with-undo。它先写规格、实现,再启动三个独立上下文的审查员:一个只看 diff,一个寻找边界情况,一个检查验证缺口。发现的问题经过分诊,决定修复、记入 deferred-work.md,或判为无效。
Story 3.3 的乐观更新和 Undo 就暴露了并发问题:只有条目仍保持刚才写入的值时,撤销才应生效;条目若在别处被删除,本地列表也要移除。两项都得到修复,但「snackbar 按钮无法点击」属于误报。
每个 epic 完成后,还有一轮整体检查:
/bmad-code-review   (on the diff of the whole epic)
/bmad-build         (once, with the findings as intent)
/bmad-retrospective
注意第二行:作者只在审查发现待修问题时,才带着发现再执行 /bmad-build。
整体审查找到了单 story 不容易暴露的问题:分类尚未加载时,汇总错误显示为 0;截止年份设为 9999 时,图表生成数十万个时间桶。第一次回顾还指出,审查员面对 3000 行 diff 时,往往只认真读前面三分之一,因此大 diff 应拆开审。
最终记录是 365 个单元测试、68 个 Firestore emulator 规则测试、12 个 Playwright 端到端测试;每屏在明暗主题下运行 axe,9 种强调色的对比度都超过 AA 门槛。
这些数字证明作者留下了验证记录,却不能证明覆盖完整。开发过程中通过了 ng build 和测试,但端到端套件到最后才加入,中间的视觉检查主要依赖原型。功能审查仍漏过了一些外观和易用性问题。
我的判断
我最认可的是把决策、约束和延期事项写进仓库。新聊天可以接续工作,团队也能追溯「为什么这样做」。但文档状态写成 final,可能只代表已经决定并对齐,并不代表经过独立审查,这个区别必须保留。
原型也值得借鉴,但不能把内存原型的顺畅体验当作线上验收。它能验证操作路径,却不能验证真实网络、Firestore 权限和多客户端冲突。MemoIt 的审查恰好说明,这些问题仍要靠实现后的检查发现。
成本方面,作者认为 BMAD 的开发阶段比 GitHub Spec Kit 更重,主要消耗来自每个 story 后的三次独立审查,再加 7 次 epic 审查。不过原文没有同项目对照,也没有具体 token 账单,这仍是经验判断。
作者约两天完成项目,期间多次触及 Claude 订阅的 5 小时用量窗口,需要停下来等待。这个时间包含等待,不能据此推算纯开发效率。对 MemoIt 这样的小应用,全套流程也超过了单纯交付所必需的程度,作者接受它是为了学习方法。
流程应按改动规模选择,审查强度也应有明确理由。
作者最后修正设置页、分类密度、退出位置,以及退出后保留语言和强调色时,只用 /bmad-build。原文提到约 500 行的一次会话可走这种轻量路径,但没有证明它是普适阈值,更不能仅凭代码行数判断风险。
能拿来做什么
- 给 AI 开发新功能前,先把用户边界和数据归属写清楚。尤其涉及账号隔离时,要像 MemoIt 一样尽早用 emulator 测试 Firestore 规则。
- 对撤销、筛选、排序和设置联动较多的前端页面,先做内存数据原型,在手机和桌面浏览器里实际点击,再拆开发任务。
- 把审查重点写得具体:乐观更新要查并发撤销,汇总要查加载状态,图表要查极端日期;跨模块行为再用整个 epic 的 diff 检查。
- 小修复采用短流程,并保留必要的浏览器验收;大功能再补齐需求、架构和任务文档,同时记录误报与延期项,避免审查结论直接变成修改指令。