真实失败请求测评揭示编程智能体短板
阿里巴巴的 Co-Design Bench 使用曾让智能体失手的真实用户请求进行评测,表现最好的 GPT-6 Astra 完整解决率为 26.4%。报道指出,同批模型在旧基准上可超过 99%,但这一困难任务集不能直接代表日常任务分布。
AI 深度解读
AI 能把页面改得八九不离十,为什么交付前还得逐项检查?The Decoder 报道的 Co-Design Bench 把真实用户的改站需求拿来测试:表现最好的 GPT-6 Astra 平均满足约 70% 的要求,但只有 26.4% 的任务全部做对。
这组数字的价值,在于区分了「完成大部分工作」和「可以直接交付」。不过,研究者专门挑选了曾让 AI 遇到困难的任务,因此不能直接推成所有 AI 编程任务的失败率。
做完七成需求,为什么仍然交不了差
Co-Design Bench 由 Alibaba 和多所亚洲高校的研究者构建,要求智能体根据用户请求修改已有 Web 应用。输入不只有文字,还可能包含图片、录音、视频或文档。
任务跨度很大:小到从收据提取金额、更新所有依赖它的合计,大到整体改造项目。难点往往不是某个组件写不出来,而是同一次修改涉及的页面、数据和交互必须保持一致。
例如,金额识别正确、主页面也改对了,但另一个统计视图仍显示旧值,这项需求就没有完整落地。
平均满足多少要求,与有多少任务完全正确,是两种不同的交付指标。
报道给出的结果是,十个受测模型中,GPT-6 Astra 平均满足约 70% 的任务要求,完全正确率却只有 26.4%。分赛道看,它完整解决了 41% 的多模态任务,仓库任务则不到 18%。
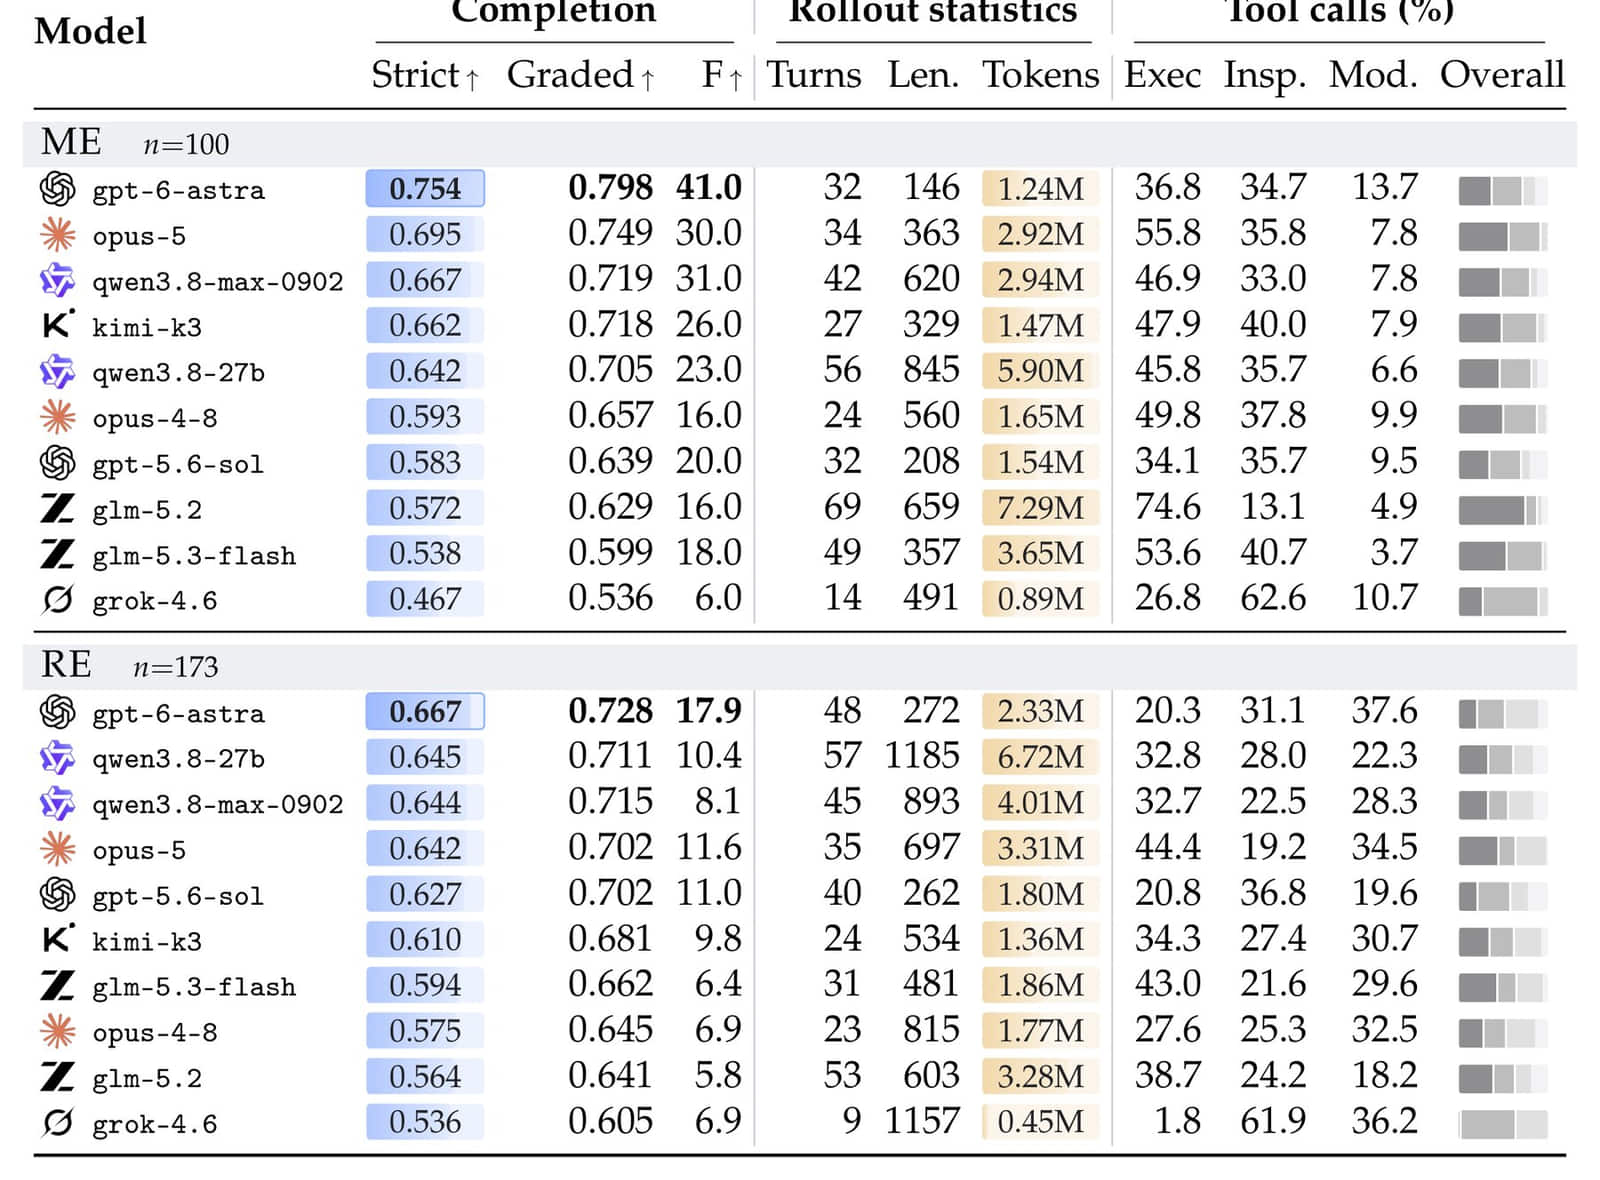
这里的「接近四分之三需要收尾」,对应的是未能全部做对的任务比例。它没有告诉我们,每项任务还需要人工修改多久,也不能据此判断 AI 究竟节省了多少开发时间。
旧榜单接近满分,真实改站难在哪里
研究者提出新基准,是因为旧测试已经出现分数饱和:当模型可以执行、检查并修复自己的代码时,部分测试成绩超过 99%,很难继续拉开差距。报道提到,在 WebCompass-edit 等旧基准与 Co-Design Bench 之间,成绩差距超过 35 个百分点。
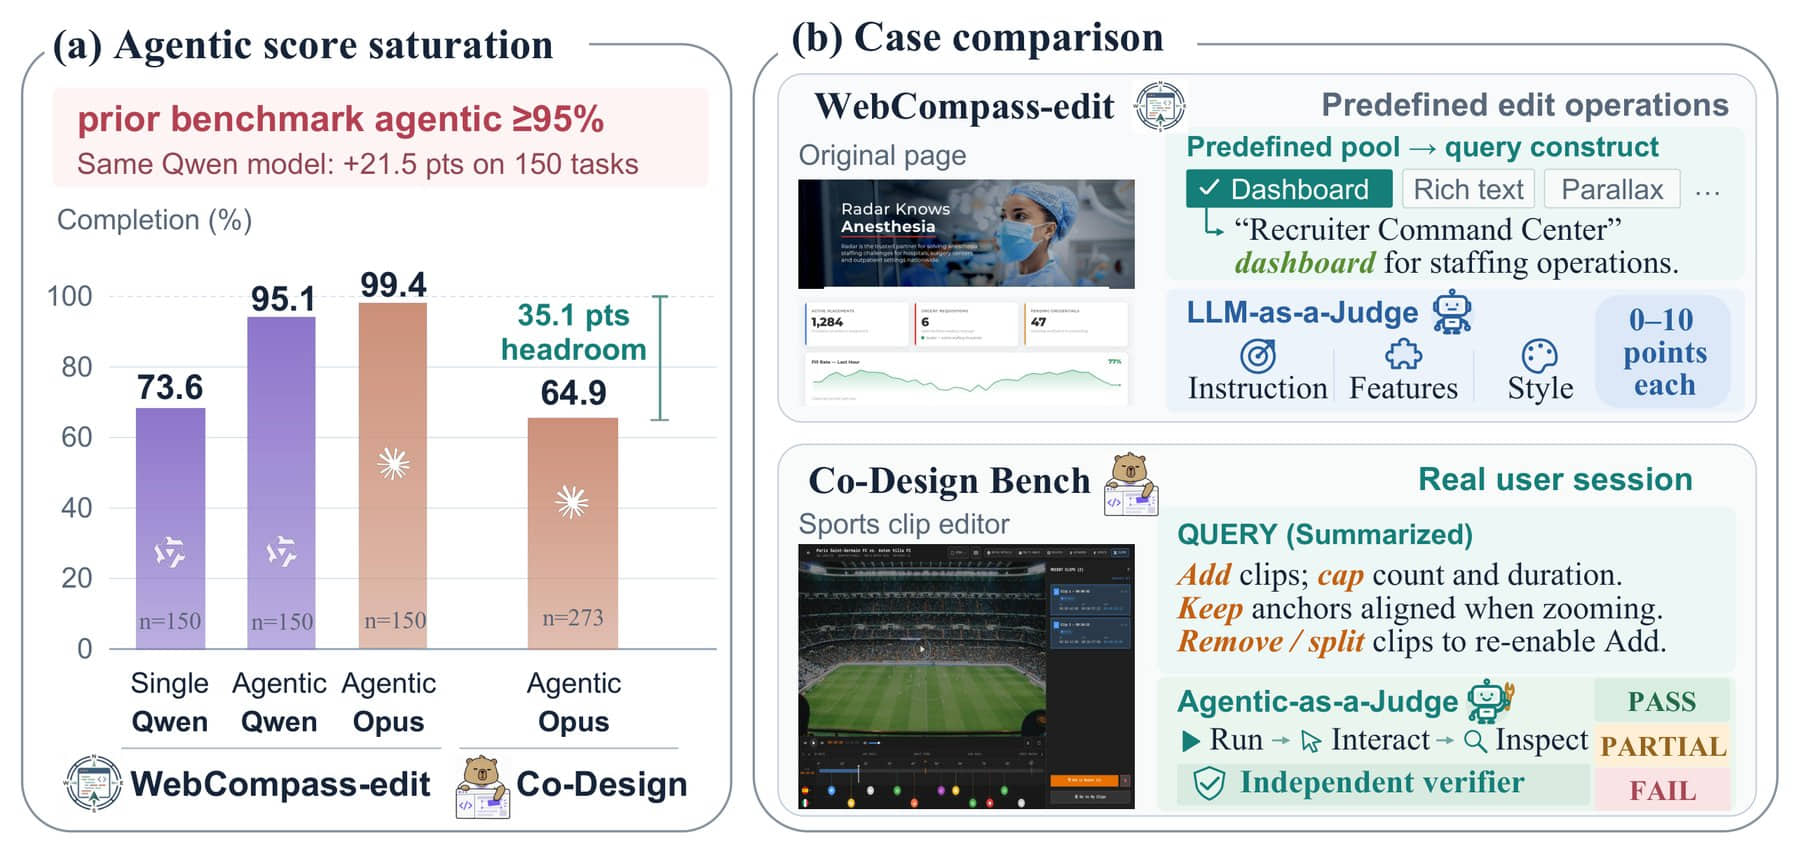
新测试没有随机抽取日常需求。研究者优先选择了用户多次改写请求、或者回滚过修改的真实会话。这让题目更贴近实际困难,也让它成为一套偏向难例的测试集。
评分同样严格。第一位 AI 评审在浏览器里测试完成的应用,第二位复核所有通过判定,并检查是否存在假界面或硬编码结果。只有在应用里真正可用的功能才得分。
模型最明显的短板,是同时处理多类修改。布局、设计、交互和内容单独看都不陌生,但一项任务要求同时改变三到四类内容时,十个模型的成绩全部下降。
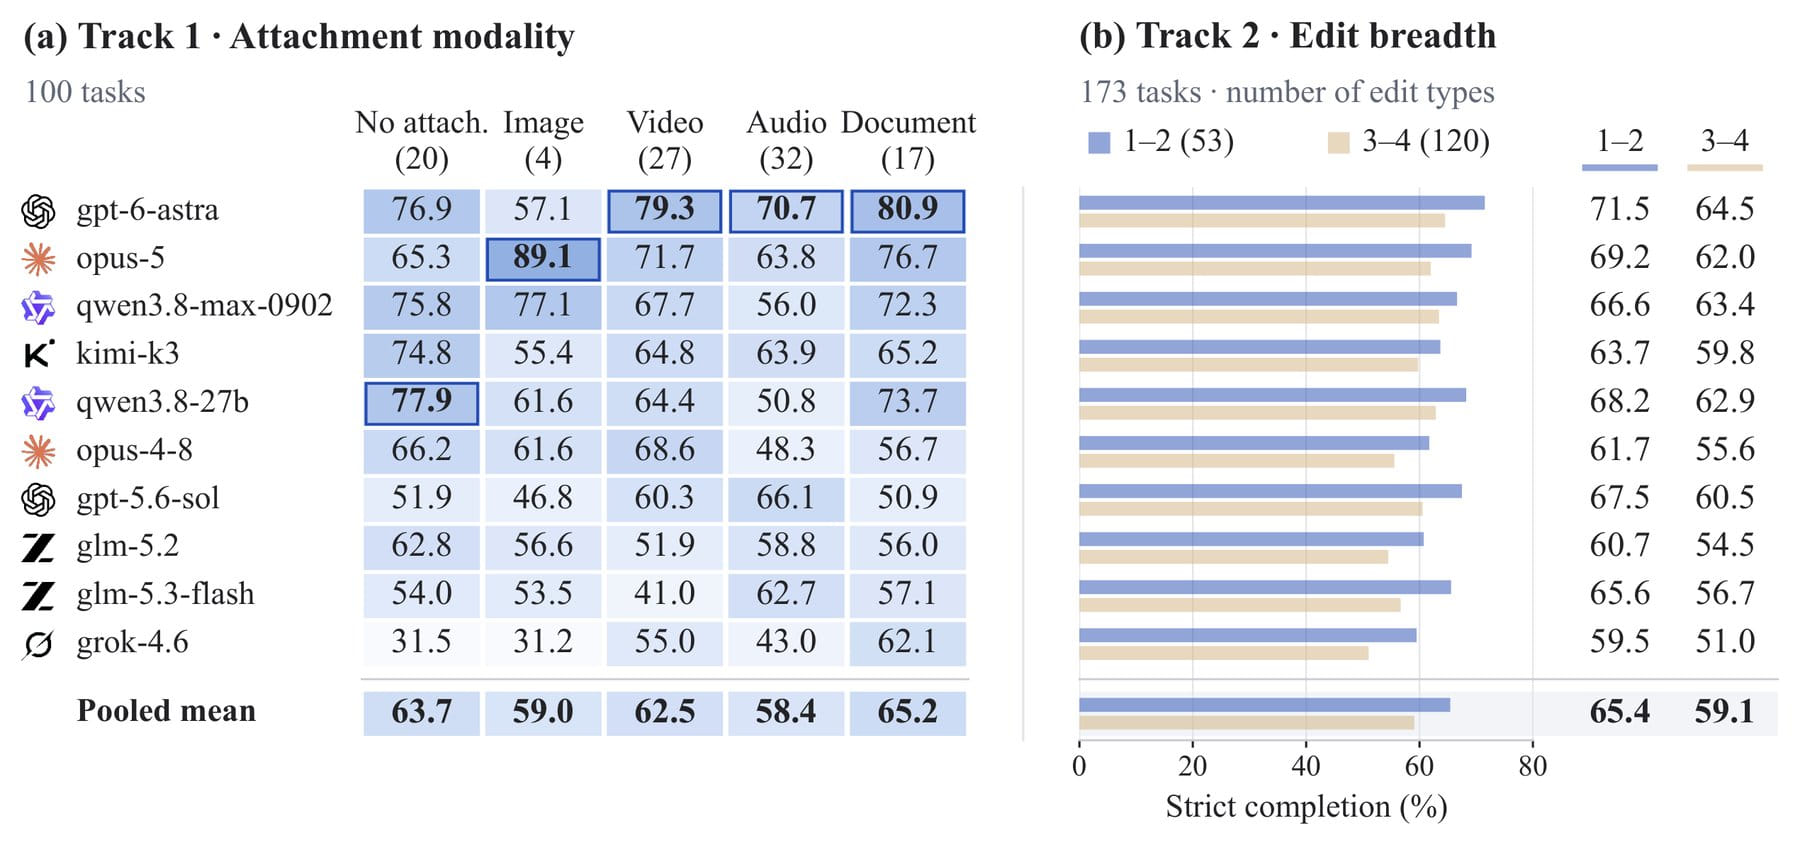
这与前端需求的形态很接近:用户希望重新设计页面,通常也会调整内容层级、操作入口和状态反馈。改动彼此牵连,局部完成并不保证整体成立。
排名也提醒我们别只记第一名。Claude Opus 5、Qwen3.8-Max 排在 GPT-6 Astra 之后,Grok 4.6 位列最后;较小的 Qwen3.8-27B 在大型改造中升至第二,但研究者没有据此认定它具有普遍优势。
增加消耗也没有自动补上差距。小改动任务中,GLM-5.2 使用的 token 接近 GPT-6 Astra 的六倍,成绩仍明显更低。这只能说明该次比较中消耗与结果不成正比,不能推广成更多推理计算一定无效。
选编程智能体,为什么不能只看模型名
研究还比较了同一模型在不同 harness 中的表现。harness 可以理解为智能体工作的程序环境,负责让它读取文件、写代码和执行命令。
在大型改造任务中,Qwen3.8-27B 随环境不同,得分分别为 75% 和 56%,相差 19 个百分点。两个模型之间谁领先,也会随环境改变。
因此,榜单若只写模型名,信息并不完整。团队真正使用的是模型与工具环境的组合,研究者建议将两者一起报告、一起测试。
但环境越复杂,也未必越有效。报道引用的另一项研究发现,更复杂的 harness 消耗最高三倍 token,却几乎没有可测量的收益。两项结果合起来支持的是「环境需要实测」,而不是「工具堆得越多越好」。
报道还引用 METR 的研究:项目负责人对 AI 生成代码的实际接受率,比 SWE-bench Verified 的分数低约 24 个百分点。这再次提示,测试通过与项目愿意接收之间存在距离,不过它和 Co-Design Bench 不是同一套实验,数字不能直接拼在一起比较。
我的判断
这项研究最有用的地方,是把验收从「生成了代码」推进到「应用里的需求是否全部成立」。对已有 Web 项目的修改,这比只看页面截图或运行成功更接近交付要求。
但标题里的比例需要带着前提读。测试刻意收集难例,也只给每个任务一个固定请求,不允许用户中途补充说明或纠偏。一般团队会不会得到相同结果,原文没有给出证据;AI 评审本身也可能判断错误。
把混合需求拆成几轮修改、先列验收项再编码,是可以尝试的工程做法,但报道没有提供它们与一次性执行的对照数据,不能说已经证明有效。同样,完整完成率偏低,也不足以说明智能体不值得用:人工收尾成本和整体节省时间仍然缺数据。
更稳妥的结论是:生成进度可以很快,交付质量仍要单独验收。
能拿来做什么
- 给前端智能体布置改站任务时,把布局、设计、交互、内容分别写成可检查的要求,并标出共享数据影响哪些页面和合计,方便最后逐项核对。
- 验收涉及收据、表格或视频的修改时,同时检查提取值和依赖结果,再更换输入操作一次,确认页面确实会更新。
- 选择 AI 编程工具时,用团队已有项目中的同一组需求测试「模型+工作环境」,同时记录完整完成率、人工收尾时间与 token 消耗。
- 遇到大型混合改造,可以尝试分轮执行并在每轮检查关联功能;把它作为团队自己的验证方案,不预设拆分后一定更好。