AskDB 将 SQL 生成与数据查询分开
开源 TypeScript 工具 AskDB 发布 1.0 候选版,模型根据数据库结构和业务备注生成 SQL,校验后交给应用执行,模型无需读取实际数据。业务备注可补充金额单位、销售统计口径等表结构难以表达的信息。
AI 深度解读
AskDB 让模型把自然语言写成 SQL,再由应用用自己的数据库账号执行。作者发布的 AskDB 1.0 候选版 1.0.0-rc.3,把表结构和团队写下的业务口径交给模型,查询结果留在应用里。
这套设计最值得看的地方,是作者亲手跑出了一条查错账的 SQL。它通过了所有检查,却把 38 美元的月度经常性收入算成了 20 美元。对想在 Node 应用里加一个「用自然语言查报表」入口的团队,这个例子比跑通演示更能说明问题。
表结构有了,模型为什么还会把销售额算错
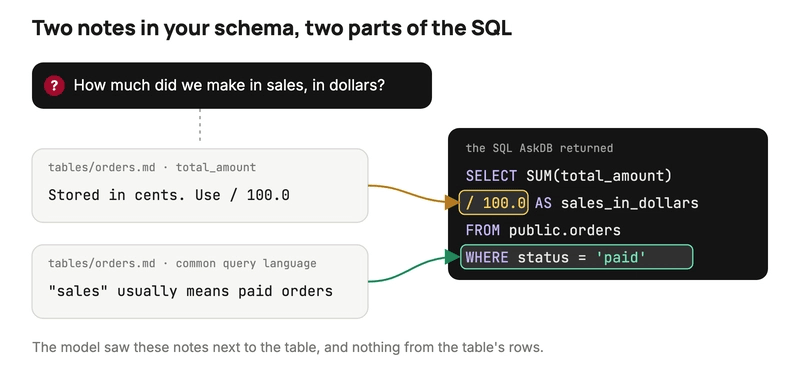
orders.total_amount 是整数。光看这个字段,模型无法知道金额按美分存储,也无法知道财务说的「销售额」通常只统计 status = 'paid' 的订单。两条规则各漏一条,SQL 照样能跑,结果却可能把未付款订单算进去,或者直接把美分当成美元。
AskDB 把这两类信息存在同一个目录。askdb introspect 在构建时读取数据库目录,生成 schema.json,记录表、列、类型、键和关系。这个过程不采集样本值,也不向模型发请求。人负责维护另一层 Markdown,例如在 tables/orders.md 里写字段别名、金额单位和付款口径,在 concepts.md 里记录可能涉及多张表的业务概念。口径有变化,数据团队可以在 PR 里逐行审查。
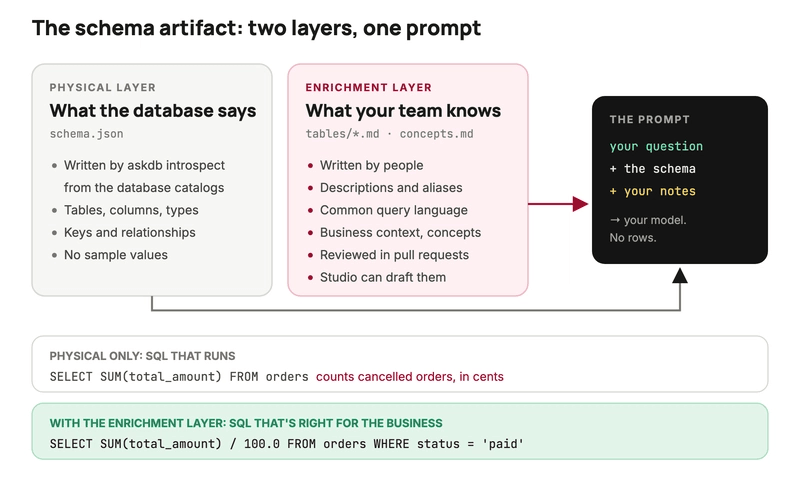
下面这段调用把问题和本地 schema 目录交给 @askdb/core,让模型生成 PostgreSQL 查询。
import { ask, loadSchema } from "@askdb/core";
import { openai } from "@ai-sdk/openai";

const result = await ask({
  question: "How much did we make in sales, in dollars?",
  schema: loadSchema("./schema"), // the schema artifact directory
  dialect: "postgres",
  model: openai("gpt-4o-mini"), // any Vercel AI SDK model object
});
留意 schema: loadSchema("./schema") 这一行。模型收到的是从目录整理出的提示文本,ask() 本身不接数据库连接。在作者用 @askdb/core 1.0.0-rc.3 和 gpt-4o-mini 跑的示例里,查询用 SUM(total_amount) / 100.0 换算美元,再用 status = 'paid' 筛订单。返回的 verdict.outcome 是 allow,sensitiveGuardrail.passed 是 true。应用还可以用 unboundSql 和 params 执行同一条查询,此时 SQL 里的条件是 status = $1,参数是 ["paid"]。
少给模型几张表,为什么能让 38 美元变成 20 美元
作者建议,表数量超过约 22 张,或者每次渲染的 schema 经常超过 8K tokens,可以考虑启用 @askdb/rag。它给同一份 schema 目录建向量索引,每次只取和问题相关的片段。这个门槛是作者的使用建议。@askdb/rag 在 AskDB 1.0 时仍处于 0.x,API 还可能变动。
作者用一份虚构的 63 表 SaaS schema 问活跃订阅的月度经常性收入(MRR)。当时只有 subscriptions 写了业务说明。检索的前 8 个片段来自订阅和用量相关的表,漏掉了存价格的 plans。模型于是数了活跃订阅,再乘以自己填的 10,得出 20 美元。正确值是 38 美元。因为查询形式合法而且是只读的,所有检查都通过了。
作者随后在 tables/plans.md 里写明 MRR 用 plans.monthly_price 计算,又在 concepts.md 里把 MRR 同时关联到 subscriptions 和 plans。检索一旦命中这个概念,AskDB 会把它关联的表都带进提示词。重建索引后,concept:mrr 和 plans#biz 以 0.593、0.576 排在前两位,3 次运行都关联了 plans,返回 38 美元。这个实验复现了漏表,也验证了这份 schema 的修法。其他问题能否找齐所需的表,仍得拿实际问题测。
模型看不到查询行,应用还要管什么
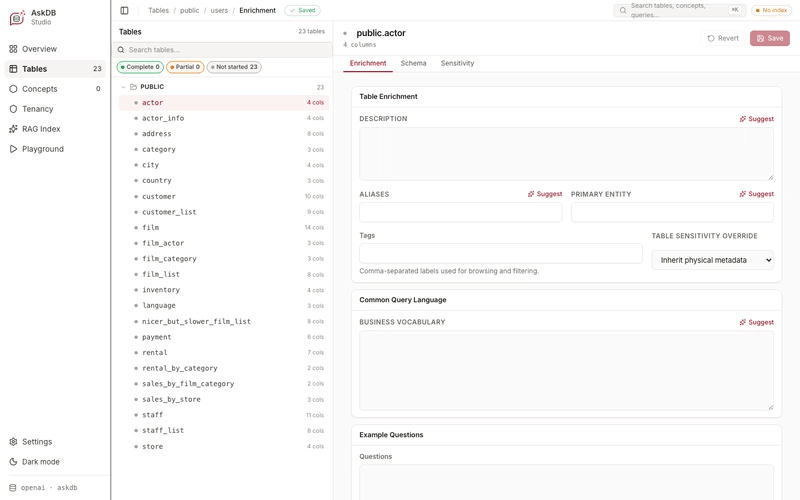
库、CLI 和 HTTP API 都把 SQL 交回应用执行。npx askdb studio 打开本地 Studio,可以改表注释,在 Playground 里提问并查看 SQL 和检查结果。Playground 的 Execute 默认关闭,开启时需要给 Studio 配置只读角色。Studio 也能让模型起草描述和别名,起草时会发送表的列定义和最多 4 张关联表的名称。Studio 在 1.0 时仍处于 0.x。
RC 提供三类检查。内置方言都启用只读检查。schema 有 tenant-policy.md 且调用范围不是全局时,会检查租户条件,已有的租户条件通过后,租户 ID 会作为驱动参数放进 tenantParams。被标为敏感的字段也会检查,常规模式可以返回 warn,严格模式会抛出 SensitiveReferenceError。作者用预设 SQL 验证过拒绝和告警确实会触发。--explain 也说明了检查的实现方式,使用词法和模式匹配,罕见写法可能漏过。真正约束权限的是数据库角色。租户隔离、查询超时和读取行数上限,都要由应用和数据库负责。
查询行有自己的边界,提示词也有。用户写进问题里的值、Markdown 里写入且被纳入提示词的内容,以及 tenantScope.context 里的客户名,都可能发给模型。开启检索后,嵌入模型在建索引时还会收到 schema 片段,每次调用也会收到问题。实验性的 @askdb/client/charts 沿用了这套分工。planChart() 根据问题、已掩码 SQL、结果列名和类型、行数及截断标志返回图表规格,应用用自己的数据画图。这个接口在 1.0 的 API 冻结范围之外。
我的判断
AskDB 最有说服力的做法,是把财务或运营确认过的口径放进版本控制。相比在一段通用提示词里维护整库术语,按表和概念维护更容易查到一条定义何时改过、由谁审核。前提是团队能就「销售」「活跃」「收入」达成一致,并在业务变更时更新说明。像示例里「通常只算已付款」这样的定义,遇到不同部门有不同口径时,还得说明各自适用的报表。
如果产品只提供几张固定报表,手写参数化 SQL 更容易逐项核对指标,也省掉检索漏表这一层。当用户会围绕同一批已定义指标反复换问法,AskDB 才有更明确的用处。作者只给了一个销售额示例和一次漏表案例的 3 次复跑,没有给出与全量 schema、手写提示词或固定 SQL 的对照数据。关于何时开检索、注释能把准确率提高多少,目前只能当作经验来用。
能拿来做什么
- 用小型 SQLite 库试跑一条已有报表。准备 Node.js
22.23.4或更新版本,执行npm install --save-dev askdb和npx askdb init --yes --database sqlite --sqlite-file ./shop.db。原文发布时 RC 在 npm 的latest标签上,项目若锁在 0.x,需要改package.json的版本范围才能装到1.0.0-rc.3。 - 从团队真的会问的问题里,挑一条涉及金额单位、一条涉及状态过滤、再挑一条需要跨表的问题。用现有报表结果核对生成 SQL,打开检索后,把相关表是否进入提示词也纳入验收。
- 在 Node 服务端执行参数化查询,用只读、最小权限的账号,限制查询时间和返回行数。用 PostgreSQL 做多租户时,把行级安全策略(RLS)设在数据库里,并用跨租户用例核对结果。
- 给前端加图表时,让后端用
planChart()拿图表规格,再用应用已拿到的结果渲染。使用敏感字段排除设置时,同时传入 schema 目录对应的制品,并检查图表规划收到的列名。