训练任务选 B300:先算显存与成本
B300 单卡显存从 B200 的 180GB 增至 288GB,但 BF16、FP8 吞吐与显存带宽未提升。按文中租价计算,B300 需达到约 1.26 倍执行速度才更省钱,其价值主要取决于能否减少节点、避免 CPU 卸载或利用 NVFP4。
AI 深度解读
B300 比 B200 贵,训练却未必更快。原文的结论很明确:Blackwell Ultra 的主要增量是显存,BF16、FP8 的常规训练算力没有提高。选卡要算完成一次任务的成本,不能只看型号新旧。
作者用 Nodus 的报价和 NVIDIA 的规格划出两条线:同样数量的 GPU,B300 要快约 26% 才划算;如果大显存能把双节点任务塞进单节点,则要重新计算。对需要租卡微调、自建模型服务的团队,这比峰值算力更有参考价值。
贵了 26%,训练速度靠什么追回来
B300 单卡显存从 B200 的 180 GB 增至 288 GB,FP4 吞吐、注意力计算和节点网络也有提升。但密集 BF16、FP8 算力、显存带宽和 NVLink 没变。两种 HGX 板卡的稀疏 BF16 都是 36 PFLOPS,密集算力取其一半;单卡显存带宽都是 8 TB/s。
这里的 B200 按实际八卡系统的 180 GB 计算:DGX B200 总显存是 1,440 GB。技术博客里的 192 GB 是 Blackwell 的最大容量,不能直接拿来估算租到的机器。
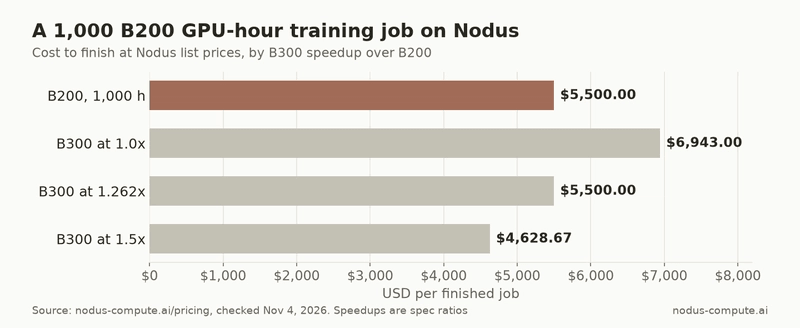
原文采用 2026 年 11 月 4 日核对的 Nodus 报价:B200 每 GPU 小时 $5.50,B300 为 $6.943。两者相除是 1.262,所以同等卡数下,B300 必须把吞吐提高约 26%,才能抵消溢价。
假设任务在 B200 上需要 1,000 GPU-hours,例如 8 张卡跑 125 小时,总价是 $5,500。换成同速 B300,成本变成 $6,943,多出 $1,443;达到 1.262 倍速度才持平,达到 1.5 倍则约为 $4,628.67。
规格上限不等于整次训练的加速比。
作者明确说明,这些加速比来自规格推算,并非他们的实测。1.5 倍假设任务全部时间都花在 NVFP4 张量计算上,真实训练还包含 BF16 层、通信和数据加载。注意力相关提升覆盖每步中的 softmax 部分,也不能直接外推到整个任务。
B300 仍使用 TSMC 4NP 工艺和 208 billion,也就是 2080 亿晶体管,属于同架构刷新;原文提到的下一代是 Rubin。型号更新并不能证明现有训练会提速。
288 GB 显存,什么时候真能省钱
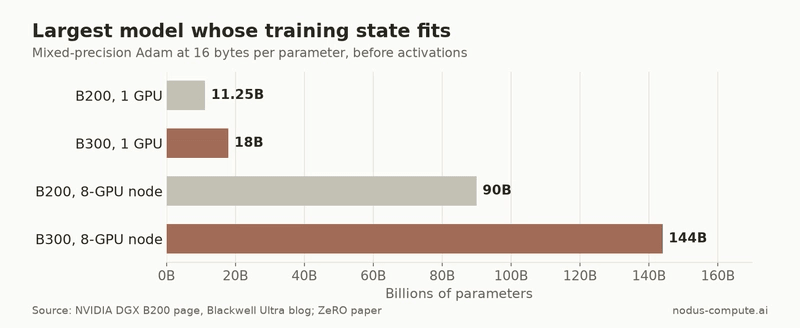
作者借用 ZeRO 论文的经验估算:混合精度 Adam 训练,每个参数约需 16 字节。其中 BF16 权重占 2 字节,梯度占 2 字节,FP32 主权重和两个 Adam 状态合计占 12 字节。激活值还要另算,随批大小和序列长度变化。
只计算训练状态,单张 B200 的容量上限是 180 ÷ 16 = 11.25B 参数,B300 是 288 ÷ 16 = 18B。八卡节点通过 FSDP 或 ZeRO-3 完整分片后,分别约为 90B 和 144B,相差 54B。
这里的「分片」,就是让多张卡分别保存一部分训练状态。
但显存能装下,不代表预算就能减半。14B 全量微调的状态约占 224 GB:一张 B300 可以容纳,还剩 64 GB 放激活值;B200 则需要两张卡,每张分担 112 GB。两张 B200 同时提供更多算力,理想情况下耗时也会缩短,因此 GPU-hours 和账单未必下降。
真正关键的是跨越节点边界。100B 稠密模型的状态约占 1,600 GB,超过一个 B200 节点的 1,440 GB,却能放进理论总显存为 2,304 GB 的 B300 节点,还剩 704 GB,平均每卡 88 GB。
这里有个规格口径差异:NVIDIA 的 HGX 页面把 B300 整板显存列为 2.1 TB,低于 8 × 288 GB。按这一容量估算,训练状态上限约为 131B。100B 示例仍能容纳,但实际激活值余量必须按供应商交付的容量重算。
一节点 B300 和两节点 B200,谁更划算
一个八卡 B300 节点每小时约 $55.54,两个八卡 B200 节点是 $88.00。后者贵约 1.58 倍,因此吞吐也至少要达到前者的 1.584 倍,才能打平。
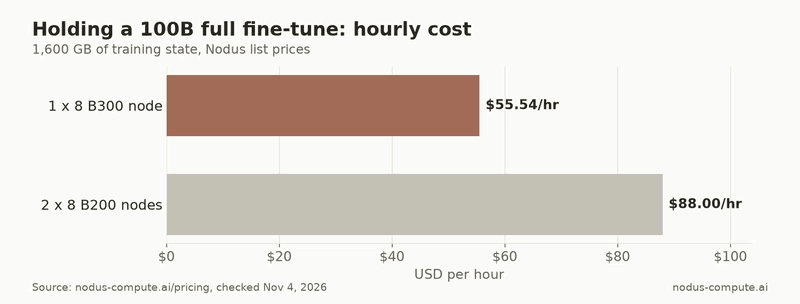
16 张 B200 的 BF16 总算力是 8 张 B300 的两倍。把 1.584 除以理想的 2 倍扩展,得到约 79% 的效率门槛。按照作者的模型,双节点 B200 的扩展效率低于这个水平,单节点 B300 更便宜;高于它,B200 可能更快、更省。
跨节点通信是关键变量。原文给出的板内 NVLink 总带宽是 14.4 TB/s,HGX B200 每板网络带宽是 0.8 TB/s。这不是完整的通信性能测试,但能解释为何增加一倍 GPU,吞吐不一定翻倍。Nodus 的多节点训练仍处于 Beta,支持最多 8 个节点的 gang 调度,也就是把同一任务所需节点成组分配。
额外显存还可能允许更大的 micro-batch,或减少激活重计算。作者没有测量这些收益,建议用短任务试跑定价,不能直接算成确定的加速。
我的判断
这篇最有用的地方,是把「卡贵不贵」改成了「任务完成一次贵不贵」。不过,1.262 和 79% 都依赖特定报价与比较方式,换平台、换网络配置,就要重新计算。
79% 尤其适合作为初筛线。它隐含了单卡有效性能接近、并行方案可比较等前提。原文没有给出同一模型在两种配置上的端到端对照测试,因此它是成本模型,不能当作通用跑分结论。
作者推荐 B200 承担能装下的大多数训练,这个方向合理。例如 70B 全量微调的训练状态约占 1,120 GB,在八卡 B200 上平均每卡还剩 40 GB。但这部分余量是否够放激活值,仍取决于训练配置。
NVFP4 也不是为了让 B300「值回票价」就该启用的选项。训练配方需要支持它,还要验证模型质量。至于 FP64,原文列出的整板性能是 B200 的 296 TFLOPS 对 B300 的 10 TFLOPS;BF16 功耗效率方面,B300 最大 TGP 更高,也是选型成本。
如果主要用途是长上下文推理,显存和注意力提升更切题,但本文没有推理实测。原文另列 H200 SXM:141 GB、$3.593/hr;B300 显存约为其两倍,价格约为 1.93 倍。这只能作为容量与报价参照。
能拿来做什么
- 租卡前先估算训练状态,再给激活值留空间。沿用混合精度 Adam 时,可以先按每参数 16 字节粗算,并核对机器实际报告的显存。
- 用短跑记录吞吐、峰值显存和预计总费用。若任务跨节点,再实测扩展效率;如果尝试 NVFP4,还要比较训练质量。
- 在 Nodus 上先用
nodus get gpus查看供给,再用下面的配置按显存筛选,让调度器在符合条件的卡中按预计完成成本选择。
spec:
  resources:
    gpu: {minMemory: 160Gi, count: 8}
要留意 minMemory: 160Gi 的单位:B200 的 180 GB 约为 167.6 GiB,因此它和 B300 都符合条件,141 GB 的 H200 会被排除。需要固定 B200 时,可使用原文给出的别名 type: B200。
- 正式启动前查看调度与费用估算,避免只凭每小时单价决定资源。
$ nodus apply -f job.yaml --dry-run=server -o estimate
重点是 --dry-run=server -o estimate:原文称它会显示拟选用的资源,以及 p50、p90 的预计费用;估算结果仍需结合试跑判断。