内容审核实战:异步分流与人工兜底
文章拆解文本与视听内容两条异步审核管线,分别使用NestJS、BullMQ、OpenAI Moderation及AWS消息与识别服务。两条管线共享审核状态、保存模型证据,并将模糊案例交给人工处理。
AI 深度解读
上传成功,不代表内容可以立刻进入信息流。作者团队把 AI 内容审核设计成一套独立流程:文本和媒体分别异步处理,明确安全的放行,明确违规的拒绝,模糊地带交给人工,公开列表只接收审核通过的内容。
这套方案值得看的地方,是它把模型分数接到了队列、数据库状态、人工后台和线上监控上。但文中的阈值不能直接照搬,父子内容的状态聚合也有一处需要核实的矛盾。
先把「上传成功」和「允许展示」拆开
所有受审内容从 pending 开始,后台处理后进入 approved、under_review 或 rejected。只有 approved 可以公开展示;under_review 必须等待人工决定,拒绝内容则保持隐藏并通知作者。
异步处理可以缩短提交请求的等待时间,公开展示仍然必须等待审核结果。
原有的 active、trash、uploaded 继续表达业务状态,安全状态另存到源记录的 content_moderation_status。账号或帖子处于活跃状态,并不能证明内容适合展示,混用字段会让查询条件和业务判断越来越难维护。
作者还用通用 content 记录串起审核对象,在 moderation_results 保存供应商、risk_score、标签、ai_decision、final_decision,人工处理时记录 reviewed_by。保留机器判断和最终判断,才能知道审核员改了什么。
公开列表在服务端查询时限定 content_moderation_status = approved,不能先返回全部内容再由前端隐藏。否则页面看似过滤了,数据已经离开服务端。
两条异步管线,分别适应文本和媒体
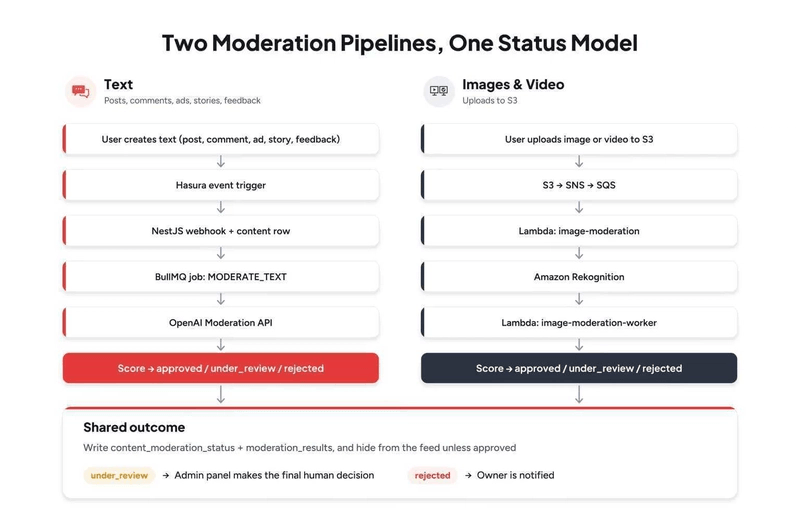
文本已经写进 PostgreSQL,适合从数据库事件启动。Hasura 调用 POST /v1/event/content-moderation,NestJS 创建审核记录,向 BullMQ 投递 MODERATE_TEXT,worker 再请求 OpenAI /v1/moderations。
HTTP 请求不等模型返回。处理器设置并发和速率限制,空文本直接通过,失败任务进入死信队列。Hasura webhook 配置为尝试 3 次、间隔 10 秒、超时 60 秒,用于吸收 NestJS 短暂不可用的情况。
媒体从 S3 的 users/uploads/ 进入,经 SNS、SQS 和 Lambda 调用 Amazon Rekognition。作者将其拆成接收队列和结果队列,分别由评分 Lambda、结果 worker 消费,避免两个函数争抢同一队列后再自行过滤消息。
这里的设计方向合理,但原文把 SQS 描述成每条消息恰好交给一个消费者,表述过强,不能据此省掉重复消息处理。
图片支持 .jpg、.jpeg、.png、.bmp、.webp,调用 DetectModerationLabels 和 RecognizeCelebrities。视频支持 .mp4、.mov,通过 StartContentModeration 启动作业,完成通知进入结果队列,worker 分页调用 GetContentModeration 取全标签。
S3 通知可能早于媒体记录落库,因此 worker 查询媒体记录时重试 3 次、间隔 3 秒。广告缩略图也要审核,未知扩展名则跳过,不能顺手当成安全内容。
部署流程体现了两个函数的职责差异,原文保留如下:
Push to develop
↓
OIDC to AWS
↓
npm ci --omit=dev
↓
Zip the function
↓
Create or update Lambda
↓
Wait + verify
其中要留意 npm ci --omit=dev:部署包安装的是生产依赖。两个 workflow 分别是 deploy-image-moderation.yml、deploy-image-moderation-worker.yml,监听 lambda/image-moderation/**、lambda/image-moderation-worker/**。运行时为 Node.js 22,评分函数约 60 秒、256 MB,结果 worker 约 5 分钟、512 MB。
分数怎样变成决定,才是审核策略的核心
文本没有直接采用 OpenAI 的布尔标记,而是取 category_scores 最大值,转换成 0–100 的风险分数:
OpenAI category_scores
→
Take the maximum score
→
riskScore = round(max × 100)
→
Compare to thresholds
→
approved / under_review / rejected
要看清 riskScore = round(max × 100):这是作者定义的决策输入,不能自动解释为内容违规的概率。
文本低于 40 自动通过,40 至不足 75 进入人工队列,75 及以上拒绝。配置项为 MODERATION_APPROVED_THRESHOLD、MODERATION_REJECTED_THRESHOLD,只保存达到通过边界的类别标签,减少后台噪声。
图片取 Rekognition 标签的最高置信度并四舍五入:低于 75 通过,75 至不足 90 人工审核,90 及以上拒绝,对应 MODERATION_REVIEW_THRESHOLD = 75、MODERATION_REJECT_THRESHOLD = 90。图片保留全部标签及其置信度。
视频还增加时间维度:标签置信度至少 75% 的帧算违规帧;达到 5 帧,或形成持续至少 3 秒的聚集,就满足帧策略。任何标签达到 90% 都拒绝;只有审核区间命中时,满足帧策略也拒绝,否则交给人工;没有符合条件的标签才通过。
这些数字来自作者声称做过的标注样本校准:收集明确安全、模糊、明确违规三类内容,遍历候选阈值,比较误放、误拒和人工工作量。文本样本中,约 40 以下几乎没有人工确认的违规,约 75 以上几乎都有,中间区间集中了多数人工改判。
但原文没有给样本量、具体错误率、队列规模或对照结果。「几乎」究竟是多少,没有说清。视频的采样间隔、重复标签是否重复计帧、3 秒聚集如何计算,也缺少定义。
人工后台因此是必要组成:显示原文或媒体、供应商、分数、标签、人脸名称和视频帧摘要,提供通过与拒绝操作。拒绝后由 POST /v1/event/content-rejected-notify 触发 SendGrid 邮件及 Firebase 站内或推送通知。
上线后还要分别观察文本、图片、视频的 p50/p95 审核延迟、人工队列年龄与 SLA、供应商错误和限流、重试与死信量,以及改判、申诉和误放举报。作者建议每周或每两周检查漂移,必要时重新校准。
我的判断
我认同这套方案把审核做成产品生命周期。与同步等待模型相比,异步方案改善提交体验;与单一阈值直接二选一相比,三段式决策给人工留下了处理歧义的空间。代价是必须维护队列、后台和运营能力,不能只估算 API 调用费。
40/75 和 75/90 是他们团队的配置结果,不是通用安全标准。
OpenAI 类别分数与 Rekognition 置信度并非同一把尺子,不能因为媒体的数字更高,就直接证明策略更严格。原文虽描述了校准过程,但没有提供足够数据让外部团队复核效果,仍需把结论视为该团队的经验。
更需要核实的是父状态聚合。作者要求任一子项仍在 pending 时,父内容不能通过;随后却给出 pending < approved < under_review < rejected,并按最严重状态聚合。照此取最大值,pending + approved 会得到 approved,与前述要求冲突。数据库函数 apply_aggregate_moderation_status 的实际实现没有展示,不能认定它已经处理好了。
另外,「已有结果只允许升级到更严重状态」可以防止迟到消息覆盖结论,却还不足以说明完整幂等性。内容修改后的重新审核、旧结果与新版本的关系、重复拒绝通知如何避免,原文都没有讲清。接入现有产品时,这些比直接复制 Lambda 配置更值得先查。
能拿来做什么
- 给现有 UGC 产品增加独立审核字段,让公开列表在数据库查询阶段只返回
approved;前端分别展示上传完成、审核中和审核拒绝。 - 在 NestJS 或其他 Node 服务中,把模型调用移到队列 worker,并保存原始证据、机器决定和人工决定,为后续调参留下依据。
- 用自己的安全、模糊、违规样本验证候选阈值,同时观察误放、误拒和人工等待时间,不直接继承作者的默认数字。
- 上线前重点核对多图帖子包含待审附件、内容修改后收到旧结果、消息重复投递三类情况,确保公开展示和通知行为符合预期。