让模型解析查询,让 Python 负责计算
示例将网球数据分析拆成两步:语言模型生成带类型约束的筛选计划,Python 校验后执行计算并生成图表。项目提供代码与样本数据,同时说明展示的计划为编辑示例,未实际调用付费模型。
AI 深度解读
让 AI 回答「哪些 WTA 球员在硬地上更常击败排名更高的对手」,最容易出问题的地方,是让它顺手算出胜率、排好名次。作者给出的做法很克制:模型只把问题转换成三个筛选条件,Python 负责校验、统计和排序,图表直接读取结果表。
这套小工具值得程序员关注的,是自然语言如何接入一段可以复查的业务逻辑。不过要先划清证据边界:文章展示的是保存下来的 233 场比赛数据,计算重新执行过,示例筛选条件却是明确指定的,没有实际调用付费模型来验证问句解析。
先定分母,才知道「更常赢」在算什么
作者只支持一个固定指标:球员以较低排名身份获胜的次数,除以他以较低排名身份参加的有效比赛次数。排名数字越大,实际排名越低,所以排名第 80 的球员击败第 20 的球员,才计入这里的爆冷获胜。
如果某人作为弱势方赢了 3 场、输了 7 场,结果就是 30%。只在胜者表里找到他的 3 场胜利,再算出 100%,是分母漏掉了失败记录。
缺失排名、排名相同,以及比分包含 RET、W/O、DEF 的退赛、弃权和判负比赛,都不进入统计。
指标的可信度,首先取决于分母和排除规则是否写清楚。
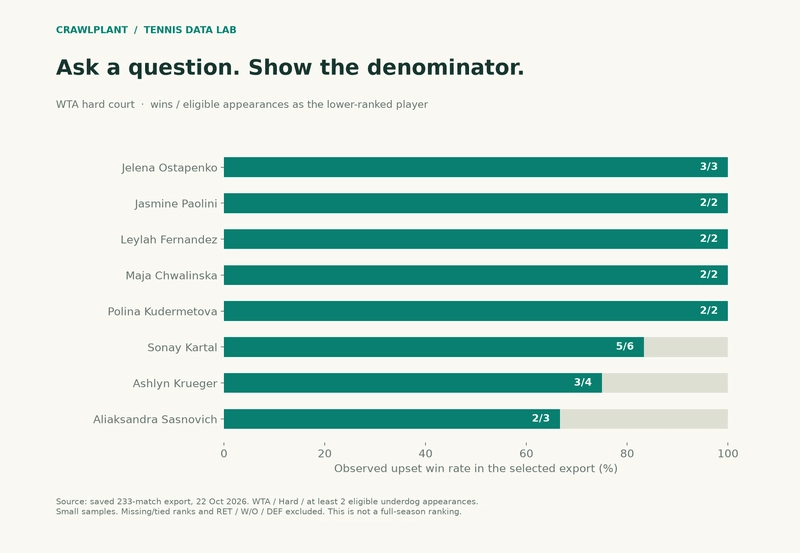
示例把最低有效场次设为 2,只是为了让小样本图表里有足够的球员可看。233 条输入记录算出的前四名分别是 Jelena Ostapenko,3/3;Jasmine Paolini、Leylah Fernandez 和 Maja Chwalinska,均为 2/2。胜率都是 100%,同胜率先按有效场次降序,再按姓名排序。
这些结果描述的是选中的导出数据。2/2 不能证明稳定能力,也不能被包装成赛季排行榜。
模型只选三个条件,程序守住计算边界
作者把自然语言接口压缩成一个查询计划(query plan)。它就是一份结构固定的参数对象:选择巡回赛、场地和最低场次,不能自由增加统计指标。
下面这段代码限定了模型可以返回什么:
def question_to_plan(question):
    schema = {"type": "object", "properties": {
        "tour": {"type": "string", "enum": ["atp", "wta"]},
        "surface": {"type": "string", "enum": ["Hard", "Clay", "Grass", "Carpet", "all"]},
        "minimum_matches": {"type": "integer", "minimum": 1, "maximum": 100}},
        "required": ["tour", "surface", "minimum_matches"], "additionalProperties": False}
    return ai_json({"question": question}, "Translate a question into filters for the fixed metric: "
                   "wins as the lower-ranked player divided by eligible appearances as the lower-ranked player. "
                   "Use minimum_matches=2 when not specified. No code, SQL or new metrics.", schema)
重点看 additionalProperties: False 和枚举范围:模型只能填写既定表单。minimum_matches 限制为 1 到 100,未指定时使用 2。
请求通过 https://api.openai.com/v1/responses,使用 Responses Structured Outputs:text.format.type 为 json_schema,并设置 strict: True。辅助函数还指定了 store: False、max_output_tokens: 1600 和 timeout=90,检查响应是否为 completed,遇到拒绝或没有 JSON 文本就报错。
模型拿到的是问题,不接触采集用的 API token,也没有文件系统访问权限。应用不会把返回值送进 eval、Python 解释器或 SQL 数据库。可选在线调用需要 OPENAI_API_KEY 和 OPENAI_MODEL;示例代码仅在 RUN_AI=1 时调用模型,否则直接采用明确写出的计划。项目说明另有可选 --ai 入口。
但结构正确,不代表理解正确。
用户问「谁最近进步最快」,模型也可能返回合法的三个字段,却完全答非所问。作者因此要求界面展示解析后的条件;生产环境遇到超出固定指标的问题,应明确提示不支持,不能悄悄套入现有筛选器。
答案能复查,要靠执行器和数据记录
真正计算时,Python 再校验一次字段、取值和类型,按 match_id 去重,过滤比赛,然后累计分子与分母。
这段执行器把规则固定在程序里:
def execute_query_plan(rows, plan):
    if set(plan) != {"tour", "surface", "minimum_matches"}:
        raise ValueError("Unknown query-plan fields")
    if plan["tour"] not in ("atp", "wta") or plan["surface"] not in ("Hard", "Clay", "Grass", "Carpet", "all"):
        raise ValueError("Unsupported tour or surface")
    minimum = plan["minimum_matches"]
    if type(minimum) is not int or not 1 <= minimum <= 100:
        raise ValueError("minimum_matches must be between 1 and 100")
    grouped, seen = {}, set()
    for row in rows:
        if row["match_id"] in seen:
            continue
        seen.add(row["match_id"])
        if row["tour"] != plan["tour"] or (plan["surface"] != "all" and row.get("surface") != plan["surface"]):
            continue
        if any(c in (row.get("score") or "") for c in ("RET", "W/O", "DEF")):
            continue
        wr, lr = row.get("winner_rank"), row.get("loser_rank")
        if wr is None or lr is None or wr == lr:
            continue
        for role, rank, other in (("winner", wr, lr), ("loser", lr, wr)):
            player = grouped.setdefault(row[f"{role}_id"], {"player": row[f"{role}_name"], "eligible": 0, "upsets": 0, "match_ids": []})
            if rank > other:
                player["eligible"] += 1
                player["upsets"] += role == "winner"
                player["match_ids"].append(row["match_id"])
    result = [{**r, "rate": r["upsets"] / r["eligible"]} for r in grouped.values() if r["eligible"] >= minimum]
    return sorted(result, key=lambda r: (-r["rate"], -r["eligible"], r["player"]))
这里尤其要看 type(minimum) is not int:Python 的布尔值与整数有继承关系,这个写法会明确拒绝布尔值。作者展示了实际执行检查,未知字段和布尔类型的最低场次都被拒绝。
每个结果还保留 match_ids,让读者能追到支撑结论的比赛。图表和文字答案都由计算结果生成,避免再让模型凭空补数字。
数据获取同样有边界。安装 apify-client、配置 APIFY_TOKEN 后,call_actor 通过 ApifyClient 调用 crawlplant/{slug},要求运行状态为 SUCCEEDED,再用 iterate_items() 读取所有数据页。返回量达到 maxItems 就报错,提醒用户缩小范围或提高上限,避免把可能截断的数据当成全集。
实时示例调用 tennis-match-dataset,参数包括 years: []、dateFrom: "2026-10-12"、dateTo: "2026-10-18"、tours: ["atp", "wta"] 和 maxItems: 2000。采集可能收费,需要配置单次费用上限;同一张下载表可以反复查询。
但配图使用另一批增量选择的数据,重新抓取这个固定周,不保证得到相同计数。
如果要继续研究某位球员,作者建议调用 tennis-match-history,再把选中的比赛 ID 交给 Point-by-Point。示例的 playerUrls 暂时传入姓名,生产环境则应从稳定球员 ID 解析出准确 URL。后续查询只是建议,演示没有执行。
我的判断
我认同这种职责划分。对规则明确的统计产品,让模型负责参数提取、程序负责计算,比开放生成 Python 或 SQL 更容易审查,也更容易复现。前端可以直接展示解析条件、样本数和来源记录,用户知道自己看到的结果是怎么来的。
但它成立的前提,是问题空间足够小。这里只支持一个指标、三个筛选项,距离通用 AI 分析师还有明显距离。作者没有提供自然语言解析准确率、延迟、成本或与普通筛选表单的对照数据,因此不能据此认定 AI 入口更好用。对于熟悉业务的用户,三个下拉框加数字输入框可能已经够用。
文章验证了计算链路,没有验证模型理解问题的可靠程度。
作者也披露自己维护 CrawlPlant tennis Actors。文章展示了相关数据产品的组合方式,但没有提供独立的数据质量评估。即使公式正确,选样范围、排名字段和身份匹配仍会影响结论。
能拿来做什么
- 给现有前端报表增加自然语言入口时,先把它映射到已有筛选条件。展示解析结果,并对不支持的指标明确报错。
- 在 Node 或 Python 后端保留字段、枚举、类型和范围校验,把统计公式写在业务代码里;结果同时返回分子、分母和来源 ID。
- 为 AI 编程任务准备固定数据与确定性执行函数,让助手生成调用参数,再由程序产出表格和图表,方便复查每次修改是否改变结果。
- 复现原例时,可在离线配套包中依次运行
python -m pip install -r requirements.txt和python render.py,无需 token 或付费调用。输出位于assets/和reports/,包括assets/09-ai-query-upsets.png、对应.svg、reports/query-answer.md,以及计划和完整结果表 JSON。