国产模型API价格对比:区分涨价与代际溢价
文章汇总五家中国厂商24款模型的API标价,并加入美国模型与转售渠道作参照,分别比较输入、缓存输入和输出费用。研究明确仅DeepSeek包含历史价格,其余主要比较同日不同代模型的价格,避免将代际溢价直接视为涨价。
AI 深度解读
国产 AI API 还便宜吗?按这份价格调查,答案已经变成「看模型、看时段、看购买地区」。DeepSeek 有明确的历史调价记录,Kimi、GLM 的新旧旗舰存在明显价差,但 Qwen 和 MiniMax 没有沿着同一条涨价曲线走。
对程序员更有用的结论是:模型国别已经不足以判断成本。一次 Agent 任务要花多少钱,还取决于输出长度、缓存命中、调用时段和重试次数。原文整理了价格,却没有测这些模型完成同一任务的实际账单,读价格表时必须把这层边界留出来。
先分清:同一模型涨价,还是新一代卖得更贵
作者统计了截至 2026 年 10 月 29 日的官方 API 标价,覆盖五家中国厂商的 24 个模型,另加六个美国参考模型和两个阿里云转售的 DeepSeek 型号,共 34 行数据。统一采用标准档、最低上下文区间,Qwen 默认取阿里云新加坡国际区价格。
这里有两个不同的问题。
DeepSeek 有 8 月 1 日存档、8 月 13 日公告及 9 月 10 日公告,可以追踪价格变化。其他厂商只是比较同一天挂在官网上的不同代际型号,旧型号价格并不等于它当年的首发价。
新一代比旧一代贵,不足以证明旧模型已经涨价。
作者用「代际溢价」描述这种横向差距,并假设输入与输出 token 比例为 3∶1。混合单价就是「输入价×3+输出价」再除以 4,单位均为美元/百万 token,缓存输入不计入这个指标。
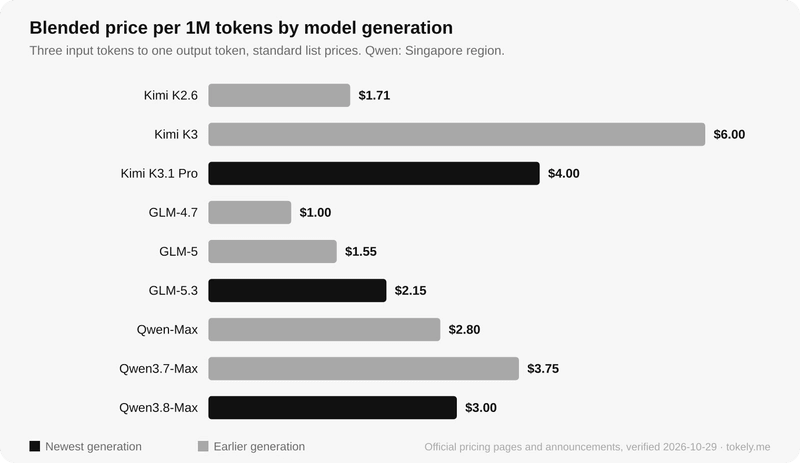
按这个口径,Kimi K2.6 的混合价约为 $1.71,K3 为 $6.00,K3.1 Pro 为 $4.00。最新旗舰相对 K2.6 是 2.34 倍,但比 K3 便宜。GLM-4.5、GLM-4.6、GLM-4.7 都是 $1.00;GLM-5 升到 $1.55,GLM-5.1、GLM-5.2、GLM-5.3 都是 $2.15。
这能支持「部分新旗舰更贵」,支持不了「所有国产模型持续涨价」。
DeepSeek 的变化,为什么要按时段算
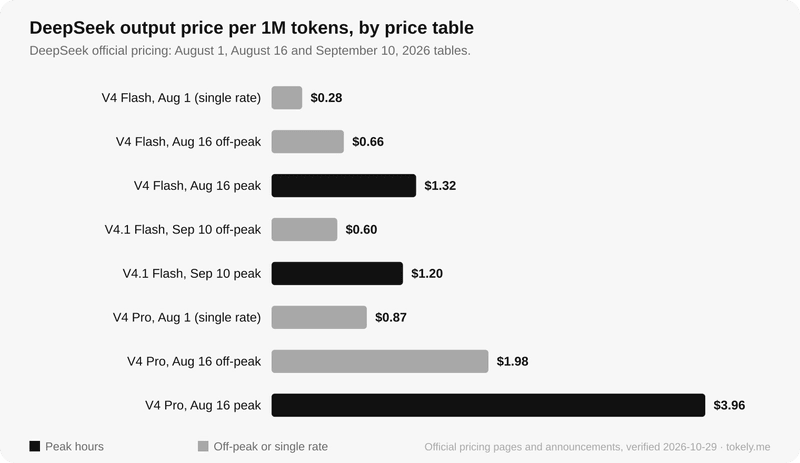
8 月 1 日,DeepSeek V4 Flash 每百万 token 的未命中缓存输入价为 $0.14,缓存命中价 $0.0028,输出价 $0.28;V4 Pro 对应为 $0.435、$0.003625、$0.87。当时页面已经预告将实行峰谷定价,高峰价格为低峰的两倍。
8 月 13 日公告确定,新价格从 8 月 16 日 16:00 UTC 生效:
| 模型 | 低峰输入/输出 | 高峰输入/输出 |
|---|---|---|
| V4 Flash | $0.22/$0.66 | $0.44/$1.32 |
| V4 Pro | $0.66/$1.98 | $1.32/$3.96 |
因此,V4 Flash 高峰输出价是此前的约 4.7 倍,低峰也有约 2.4 倍;V4 Pro 输出分别约为 4.6 倍和 2.3 倍,高峰输入约为 3.0 倍。不能把这次变化仅理解成「忙时多收一倍」,基础价格也变了。
9 月 10 日发布的 V4.1 Flash 又调整了价格:低峰输入、缓存命中、输出分别为 $0.15、$0.003、$0.60,高峰分别为 $0.30、$0.006、$1.20。它比 V4 Flash 的 8 月新价便宜,但输出相对 8 月 1 日仍为约 2.1 倍和 4.3 倍。
高峰窗口是 UTC 01:00—04:00、06:00—10:00,对应北京时间 09:00—12:00、14:00—18:00。V4.1 Flash 的公告还明确,高峰只适用于工作日,周末和中国法定节假日按低峰计算。
购买渠道也会改变账单。阿里云新加坡的 deepseek-v4-flash-0731 忙时仍是 $0.44 输入、$1.32 输出;其 V4 Pro 则为固定 $2.40 输入、$4.80 输出,仅输入就约为官方高峰的 1.8 倍、低峰的 3.6 倍。
国别不再是价格捷径,地区和缓存更关键
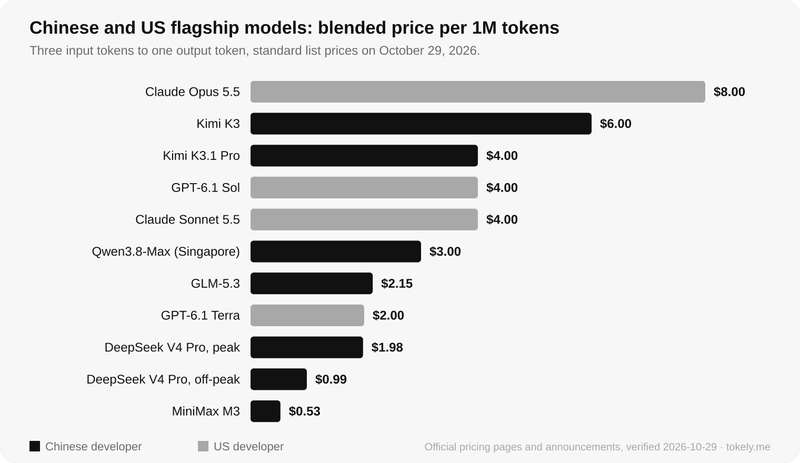
Kimi K3.1 Pro、GPT-6.1 Sol、Claude Sonnet 5.5 的普通输入与输出标价完全相同,都是 $2 和 $10,混合价 $4.00。但缓存输入不同:Kimi 为 $0.20,另外两个为 $0.10。
其他旗舰仍有明显价差。Claude Opus 5.5 为 $4 输入、$20 输出,混合价 $8.00;Qwen3.8-Max 为 $3.00,GLM-5.3 为 $2.15,GPT-6.1 Terra 为 $2.00,DeepSeek V4 Pro 高峰和低峰分别为 $1.98、$0.99,MiniMax M3 约为 $0.53。
Qwen 尤其不能脱离地区讨论。新加坡区 Qwen-Max 输入/输出为 $1.60/$6.40,Qwen3.7-Max 为 $2.50/$7.50,Qwen3.8-Max 为 $2/$6;混合价依次是 $2.80、$3.75、$3.00,最新版本相对 Qwen-Max 仅为 1.07 倍。
北京区同一组首尾型号却是 $0.345/$1.377 与 $1.65/$4.951,混合价差达到约 4.1 倍。
Plus 系列也有起伏:Qwen-plus 非思考模式输入/输出为 $0.40/$1.20,思考模式输出为 $4;Qwen3.5-Plus 为 $0.40/$2.40,Qwen3.6-Plus 为 $0.50/$3,Qwen3.7-Plus 回到 $0.40/$1.60。后者混合价 $0.70,是基准的 1.17 倍,作者没有计入限时 20% 折扣。
MiniMax M3 在输入不超过 512K token 时,价格由 $0.60/$2.40 降至 $0.30/$1.20。页面将其标为永久五折,因此调查采用折后价;M3.1 Flash 则为 $0.15/$0.60。
小模型的排序又不同。GPT-6 Luna、Claude Haiku 5.5 都是 $0.10 输入、$0.50 输出,混合价 $0.200,其中 Haiku 的这个档位适用于不超过 100K token 的提示。Qwen3.8-Flash 为 $0.230,GLM-5.3-Flash 约为 $0.237,DeepSeek V4.1 Flash 低峰和 MiniMax M3.1 Flash 都约为 $0.263,前者高峰为 $0.525。
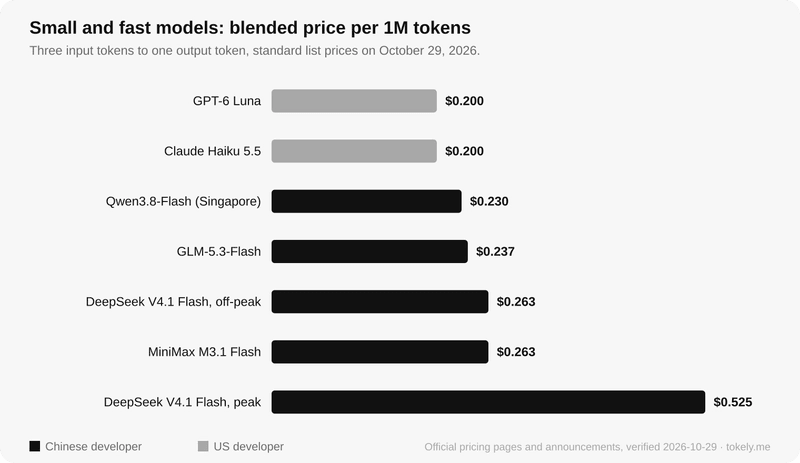
但 DeepSeek V4.1 Flash 低峰缓存命中价只有 $0.003,GPT-6 Luna 和 Haiku 5.5 为 $0.01,MiniMax M3.1 Flash 为 $0.015。重复发送长系统提示的 Agent,不能直接套用上面的普通输入排名。
我的判断
这份调查最有价值的地方,是把历史调价、代际价差、地区差价分开了。价格数字可以支持这些具体结论,却解释不了厂商为什么这样定价,更不能证明贵的模型更强。
API 单价是预算起点,成功完成一次任务的成本才是选型指标。
作者没有测质量、速度、每项任务消耗的 token,也没有提供同一代码任务的对照实验。因此,错峰和复用前缀有价格表依据,但实际能省多少仍需测量;缓存更便宜,也要先确认真实命中率。
3∶1 配比对输出很长的代码生成任务未必合适。批量折扣、缓存写入费用、企业合同、免费额度和税费也被排除。与直接选一个便宜型号相比,多模型切换还会增加评测和维护工作,原文没有计算这部分成本。
另外,作者 Tokely 在文末推荐了自家的统一 API 服务。这不直接否定价格数据,但购买建议带有商业立场。原文提到可下载 chinese-ai-model-api-prices-2026.csv 和 deepseek-api-price-history-2026.csv,本文输入没有附上文件内容,无法逐行复核。
能拿来做什么
- 给现有 Node 或 Agent 调用记录补上模型版本、地区、渠道、输入与输出 token、缓存命中量和实际费用,再按成功任务统计成本,别只比较官网单价。
- 把允许延迟的 DeepSeek 批处理安排到低峰,按具体型号的规则计算时段。使用北京时间调度时,核对 09:00—12:00、14:00—18:00 这两个窗口及节假日条件。
- 用同一批真实编程任务比较候选模型,同时记录正确率、重试次数和输出长度。固定系统提示适合尝试缓存,但要用账单验证收益。
- 仍依赖 Kimi K2 系列的团队应提前验证迁移。按原文所引公告,K2 系列将在 2026 年 10 月 31 日停止向新用户开放,并于 12 月底退役,旧型号低价不能作为长期预算前提。