同模型两次构建差距大,跑分该怎么读
作者让 32 个模型各自独立构建同一应用两次,发现部分模型的两次评分差距明显。分析认为评分惩罚项贡献了大部分波动,且每个模型仅两次实验,无法据此判断其稳定性。
AI 深度解读
同一个模型、同一个应用,独立做两遍,成绩能差多少?作者用 Forge 2.0 测了 32 个模型:Gemini 4 Argon 两次得分是 0.79 和 0.29,Claude Sonnet 5.5 则是 0.59 和 0.55。差距并不都来自模型能力,也可能来自评分方式、测试环境,甚至评测工具自身。
这篇最有用的提醒是:长任务榜单上的一个分数,混合了模型能力、执行偶然性和评测机制。选 AI 编程工具时,既要看它做成过什么,也要看失败怎样发生,以及失败有没有被测试发现。
两次差了很多,就能认定模型不稳定吗
Forge 2.0 要求模型把一个基于 v1 契约的 Jira 应用升级到 v2,包括数据迁移、逐人权限检查、限流和仪表盘。模型在 goose local edition 中以单 agent 工作,预算为 300 次模型调用;支持时请求「medium」推理,否则开启供应商默认推理。大多数模型经 OpenRouter 调用。
这是需要连续决策的长任务。一次早期存储选择、一次漏传参数,都可能改变后面的结果。
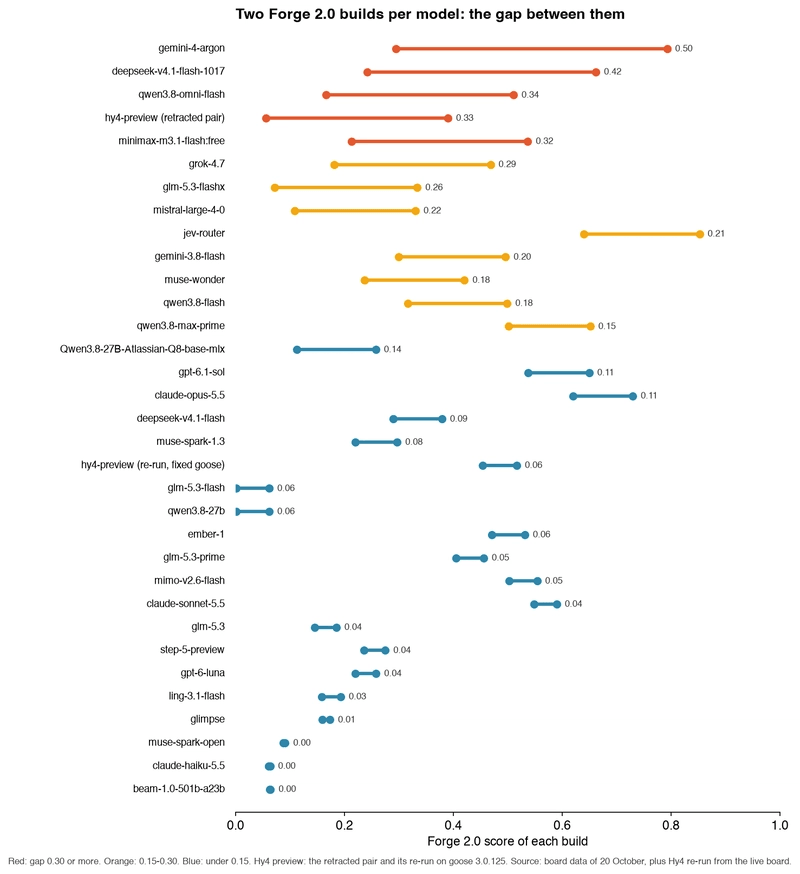
作者筛出两次平均分在 0.15 至 0.65 之间的 24 个模型,排除受评分下限限制的模型和运行环境不同的本地微调模型,算出合并的组内标准差为 0.153。
这个数字支持「单次成绩可能有较大波动」,却不能证明某个模型特别容易失常。作者假设这些模型共享同一噪声水平,再检查观察到的差距是否异常:Argon 的 0.50 差距,对单个配对约有 2% 的发生概率;但同时观察 24 对,某处出现这么大差距的概率约为四成。
看过很多模型后挑出最夸张的一对,不能直接拿它证明该模型特别不可靠。
替换 Hy4 的重跑结果后,合并标准差降为 0.146,上述概率约为三成,结论没有改变。不过,0.153 不是每个模型各自测出的标准差,也不是所有 AI 编程任务通用的「±0.15」误差保证。
作者建议公布两次结果的中位数和范围。范围能让读者看见波动,但两次样本依然很少;要区分模型各自的稳定性,作者认为需要每个模型跑数十次,他们也没有承担这个成本。
分数差一倍,应用未必差一倍
Forge 2.0 把应用部署到模拟器,在三个预置 Jira 站点运行 105 项检查,分为 20 个层级。最终分数是三项相乘:
- 完成度:应用有多少功能正常,取值为 0 至 1。
- 可靠性因子:19 组检查分别取最差项,每组最多造成 10% 扣分,因子最低为 0.25。
- 严重缺陷惩罚:迁移损坏、webtrigger 接受非法输入、管理员权限漏洞、权限泄露、重复写入,共五类;每命中一类,乘一次 0.6。
大多数检查还会取三个站点中的最差结果,少数效率检查取平均值。各项最差结果可以来自不同站点,因此合成分数甚至可能低于每个站点单独的得分:有站点明细的 60 次构建中,52 次如此,另有 2 次持平。
这套规则强调交付风险。四组可靠性检查各扣 10%,剩余比例就是 0.9⁴ ≈ 0.66;再碰上一项严重缺陷,还要乘 0.6。同一个根因如果影响多个检查组,也会在这些组分别扣分。
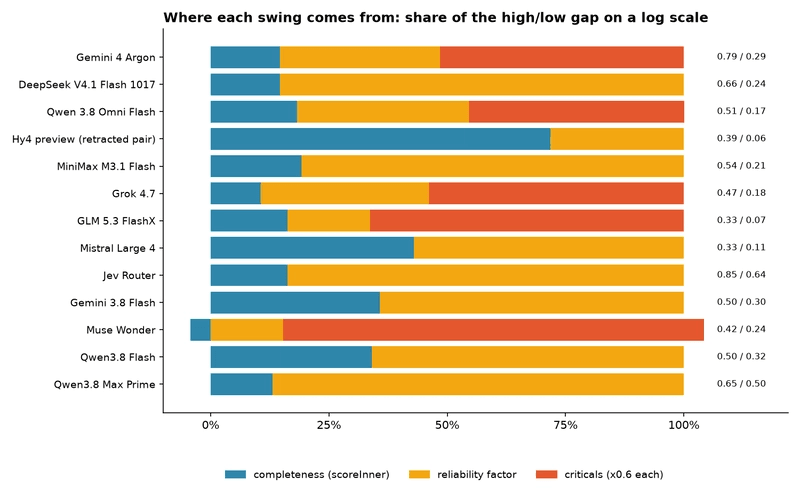
在 20 October 数据中,13 组最大分差的来源分别是:完成度占 28%,可靠性因子占 46%,严重缺陷占 26%。也就是 72% 来自惩罚;排除 Hy4 已撤回的配对后,比例为 80%。
作者还比较了检查项差异与最终分差。在两次都产出应用的 30 对结果中,相关系数只有 r = +0.17,95% 区间为 −0.20 至 +0.50;替换 Hy4 重跑后为 +0.09,均不显著。Argon 两次有 88/105 项成绩相同,却差了 0.50;Haiku 5.5 有 27 项不同,最终分数却一样。
因此,榜单分数更接近这套规则下的发布风险指标,不能直接当作代码质量或功能差异的等比例刻度。
真正拉开差距的,常常是测试没覆盖的一步
Argon 的弱版本把写操作放进了管理页的读取路径:打开页面会调用 getMigrationProgress,再调用 ensureMigrationCatalog 保存迁移记录。其中决定迁移是否完成的是:
complete: v1Keys.length === 0,
要盯住的是「没有找到 v1 keys」被当成「迁移完成」。首次迁移前打开管理页,就可能提前写入完成状态。模型自己的测试先 reset、再执行 scheduled reconcile,最后才打开管理页,没有走到出错顺序。
它声称验证了 88/88 条旧记录迁移成功,在开发站点上确实如此;评分站点却发现来源属性损坏。强版本在没有状态时只返回未完成状态,不写数据。不过作者没有在轨迹中找到模型主动分析这种访问顺序的证据,因此认为强版本的安全性可能带有偶然性。
Qwen 3.8 Omni Flash 的问题则是权限身份。它的请求辅助函数用下面这一行决定调用身份:
const who = opts.who === 'user' ? api.asUser() : api.asApp();
要检查的是默认分支:漏传 who: 'user' 就会走 api.asApp()。弱版本在个人视图中漏了参数,导致隐藏 issue 数据泄露,触发乘 0.6 的惩罚。开发站点中所有用户都能浏览全部内容,正确与错误实现都显示「hidden 0」,测试无法区分它们。
作者追踪的 12 组波动中,约 7 组的决定性缺陷没有在开发站点测试中暴露。除了权限和操作顺序,还有数据规模:开发站点有 88 条 v1 记录,每个 sprint 最多 28 条;最大评分站点有 100 条。Jev Router 把每个 sprint 存成不断增长的单个值,在更大站点遇到了 47 次存储大小错误。
限流也暴露了类似问题。任务规定每小时 2,400 points,后台工作占 1,680,这是任务自定义配额。Qwen3.8 Flash 的弱版本用 sleepUpTo(wait, wait),把应等待的秒数当成毫秒,在 30 秒的 Retry-After 窗口内重试 58 次;强版本用了 sleep(retryAfter * 1000 + 60)。
开发环境测试通过,只能证明它覆盖过的条件成立。
评测系统自身也可能破坏条件。Hy4 preview 的一次弱构建中,301 次调用有 268 次只看到了约 5,000 至 9,000 tokens,而实际会话已从 95,000 增至 905,000 tokens。它反复重读任务,直到接近第 296 次调用才发现 manifest 仍是 v1。该次得分为 0.0555,比未修改的起始应用 0.0617 还低。
作者将其中大部分问题归因于运行框架截断了会话,并称已修复、重跑,重跑两次仅差 0.06。但提供的原文在架构讨论中途截断,没有给出后续框架修复细节,无法据此检查完整修复过程。
我的判断
这篇最扎实的部分是把分数拆回故障:权限身份、迁移顺序、容量边界和等待单位,都是程序员能检查、能复现的问题。相比只给排行榜,它更能帮助团队设计验收。
但它没有证明所有模型一样稳定,也没有证明所有榜单都不可靠。每个模型只有两次构建,调用路线也不完全统一:Argon 直连 Google,部分模型运行机器不同,OpenRouter 还可能切换供应商。少量计时检查使用机器时钟,作者也尚未测量重复评分的波动。
作者赞成严重缺陷重罚,我基本认同;但总分最好与缺陷清单一起看。一次权限泄露足以阻止上线,却不代表整个应用所有部分都同样差。两次中位数加范围比单分数提供更多信息,仍不足以完成精确排名。
架构解释也应保持克制。原文发现混合注意力、稀疏注意力都同时出现在稳定和波动模型中,且多数模型是 MoE;部分架构还是从基础模型推断的。当前证据只能说没有看到明确区分,不能据此认定架构与可靠性无关。
能拿来做什么
- 给前端管理页和 Node 迁移任务补一条首次访问测试:先打开页面,再启动后台任务,检查读取路径是否意外写入状态,旧数据来源是否保留。
- 验收权限功能时,准备确实存在隐藏数据的普通用户,用同一接口比较用户身份与应用身份的结果,并检查返回对象是否夹带敏感字段。
- 让 AI 验证限流和容量边界,明确
Retry-After的单位、数据最大规模及存储限制;交付说明必须列出未测试条件,不能只写「全部通过」。 - 选编程模型时,对自己的代表任务做独立重复运行,同时记录成绩范围、严重缺陷和调用环境;出现异常后先查看会话与工具日志,再判断是否归因于模型。