按需加载上下文,单 Agent 可简化架构
Anthropic建议团队评估能否将多个子Agent合并为按需加载上下文的单Agent,一项架构对比中后者速度约为前者两倍。公司同时发布了GitHub迁移工具包。
AI 深度解读
给 AI 编程流程配上需求、开发、测试、审查四个子代理,看起来分工明确,实际可能把时间花在交接上。Anthropic 给出的建议是:先评估能否收敛成一个主代理,让它按需读取技能和资料。
这不是要求所有团队撤掉多代理。原文真正有用的地方,是指出哪些分工已经可以交给模型自己完成,以及怎样避免合并之后速度快了,业务流程却坏了。
为什么多一个子代理,反而可能多一道损耗
Anthropic 的 Applied AI 团队在多个企业部署中发现,使用技能(skills)的单代理,在质量上经常胜过堆叠指令的单体提示词和子代理架构。一次对比中,单代理架构的运行速度约为多代理的两倍。
问题出在交接。
开发代理知道某个实现为什么这样写,测试代理收到的可能只有结果摘要;审查代理再接手时,又要重新理解需求与取舍。每次交接都可能丢失上下文,同时增加调用成本和等待时间。
原文举了一个面向客户的代理案例:内部有 12 个专用子代理,结果品牌表达难以保持一致,高延迟也影响了使用体验。
对应到编程任务,Anthropic 展示的方案是让同一个代理编写功能和测试,再由独立验证者运行测试、返回结果。写测试时直接复用需求与实现上下文,减少重复理解。
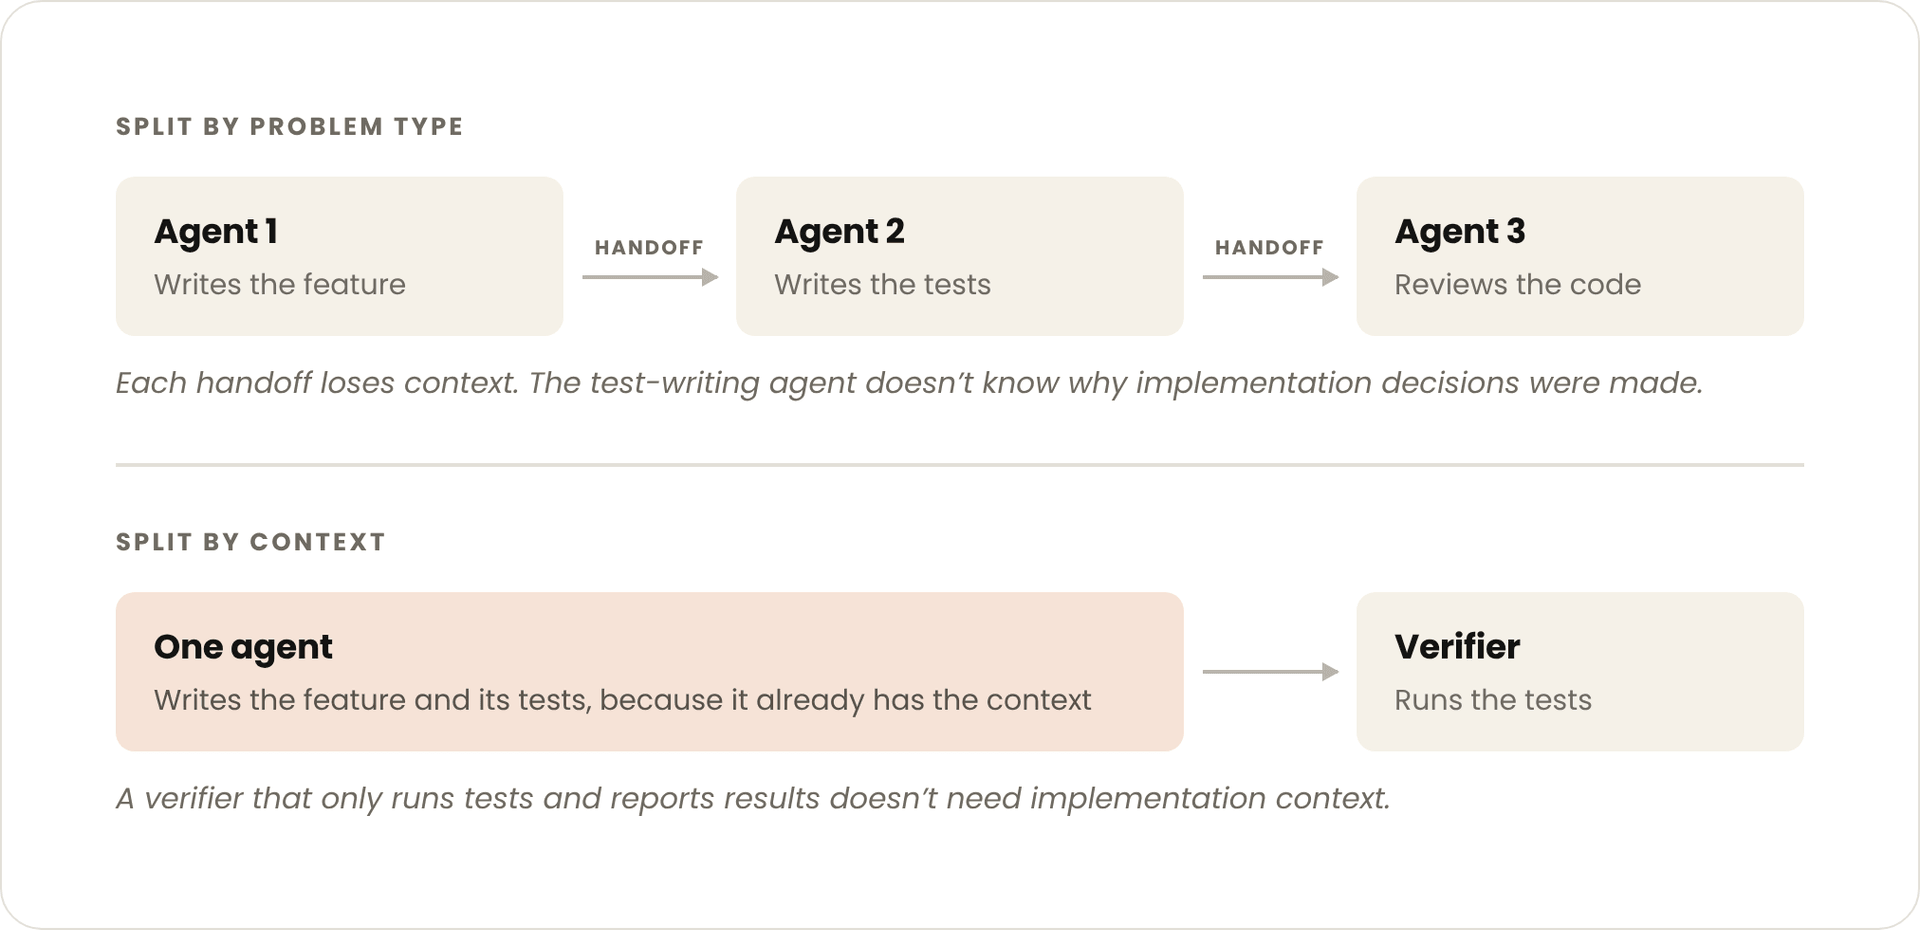
这里的独立验证者仍然承担检查职责。所以,单代理方案的重点是减少上下文交接,而不是取消验证。
一个主代理,怎样避免变成一份巨型提示词
原文把这种调整与模型能力提升联系起来:从 Opus 4.5 开始,以及文中提到的 Opus 5.5、Fable 5.1,新模型已经能在一个循环里处理复杂计划,承担更多编排工作。这些是原文列出的型号,文中没有提供逐个型号的对照结果。
过去常见的架构,会把意图识别、固定处理流水线、用户分群、推荐分支分别拆开,再加一个总调度器。Anthropic 认为,其中不少工作现在可以由模型直接完成。
他们把另一类问题称为代理版「康威定律」:组织里每个团队都交付自己的子代理,最后积累出数百个职责重叠、缺少共同标准的代理。与此同时,各团队继续向系统提示词追加规则,最终形成相互冲突的「Frankenprompt」。
解决方法并不是把所有子代理的提示词拼起来,而是分开管理不同信息:
- 系统提示词保留清晰的共同规则,由一个小型中央团队负责整体质量。
- 工作流程封装为技能,执行到相关任务时再加载。
- 工具通过工具搜索按需发现,避免一开始全部塞进上下文。
- 指南、产品规格、指标定义放进知识库,或作为技能中的参考文件,需要时检索。
Anthropic 称,针对相应场景,一份干净的系统提示词、4 到 5 个精简的数据工具和固定的输出约束,就能覆盖不少需求。Claude Code 面向新模型的系统提示词也缩减了超过 80%,部分原因正是技能和工具改为按需加载。
原文还给出一个具体边界:工具定义超过 30 到 50 个时,模型选择工具的表现往往会下降。因此,技能库仍需要各团队指定负责人维护,不能把代理数量压下去了,又让技能和工具无限膨胀。
对于参考资料,Anthropic 不建议通过代码取回上下文后直接注入提示词,而是建议让代理按需搜索。原文没有展开这个建议适用的全部边界,不能据此推导出所有程序化上下文注入都有问题。
哪些情况仍然值得保留子代理
Anthropic 明确保留了三类理由:单代理的上下文窗口已经出现可测量的性能退化;多个任务需要使用独立上下文并行执行;单代理在工具选择上表现吃力。
判断依据应当是实际失败,而不是角色名称听起来是否专业。
合并同样有风险。原文提到一次支持代理测试:折叠一个子代理后,延迟降低了,但原来正常的流程被破坏。主代理开始自行回答,没有咨询应该调用的专家。
这说明,响应更快与业务行为正确是两回事。Anthropic 已在 GitHub 发布迁移工具包,用来识别现有架构模式、评估替代方案并验证结果;原文没有列出具体命令或完整测试配置。
旁证也需要分开看。Vals 的研究发现,代理团队可以比单代理更快,但质量没有更高;代理规模从 10 个扩展到 30 个或 100 个,也未带来质量收益,成本却显著增加。这支持「多加代理未必提高质量」,同时也提醒我们:速度优势取决于任务是否适合并行,不能一概而论。
我的判断
我赞成先检查交接成本,尤其是需求、实现和测试高度相关的编程任务。把这些步骤拆给多个代理,确实需要付出重新传递约束和解释决策的代价。让掌握上下文的代理连续完成工作,是合理的简化方向。
但原文不足以证明单代理普遍优于多代理。约两倍速度、超过 80% 的提示词缩减,都有具体部署和模型前提;文章没有给出完整任务集、质量评分、成本明细和重复实验结果。企业部署经验有参考价值,推广到普通团队仍属于经验判断。
与固定流水线相比,模型自主编排能减少人为配置;对于必须咨询专家、必须经过某项检查的步骤,固定路由仍有明确价值。那个支持代理的失败案例,恰好说明合并时不能顺手丢掉流程约束。
该合并的是重复理解与无效交接,该保留的是有证据支持的隔离、并行和验证。
能拿来做什么
- 检查现有 AI 编程流程中的每次交接,记录下游代理是否需要重新阅读需求、实现和约束;优先试验合并反复读取相同材料的步骤。
- 对关联紧密的功能与测试,让同一个代理完成编写,再由独立验证者运行测试、报告结果,并检查测试是否真正覆盖需求。
- 将前端规范、Node 项目约定和常用工作流程整理成可按需读取的技能或参考资料,同时指定维护者,定期清理重叠规则与工具。
- 比较架构时同时记录质量、成本、延迟和关键流程是否执行;遇到必须调用专家的任务,加入明确的回归用例,避免只看到提速就宣布迁移成功。