Agent 记忆怎么存:精选经验比全量记录有效
Anthropic 的研究强调,跨会话记忆应保留计划、策略和验证过的规则,并通过空闲期复盘纠正失真。所述游戏实验中,限制记忆规模的新版模型取得更好进展,但模型版本也发生变化,不能将收益全部归因于记忆限制。
AI 深度解读
给 AI Agent 加上长期记忆,未必能让它更会做事。Anthropic 的这组实验指向一个更具体的结论:记忆需要筛选、核对和整理,否则 Agent 可能忙着管理笔记,甚至被错误笔记反复带进同一个坑。
The Decoder 在 2026 年 11 月 16 日报道了 Lance Martin 于 11 月 6 日发布的研究。它值得程序员读的地方,是把「让 Agent 记住更多」拆成了几个工程问题:该存什么、何时检查,以及哪些信息应该忘掉。
为什么存了几百份笔记,游戏还是没打好
这里的记忆,是 Agent 把经验写成文件,留到后续会话读取,不涉及修改模型权重。可以把它理解为一套可持续维护的工作笔记。
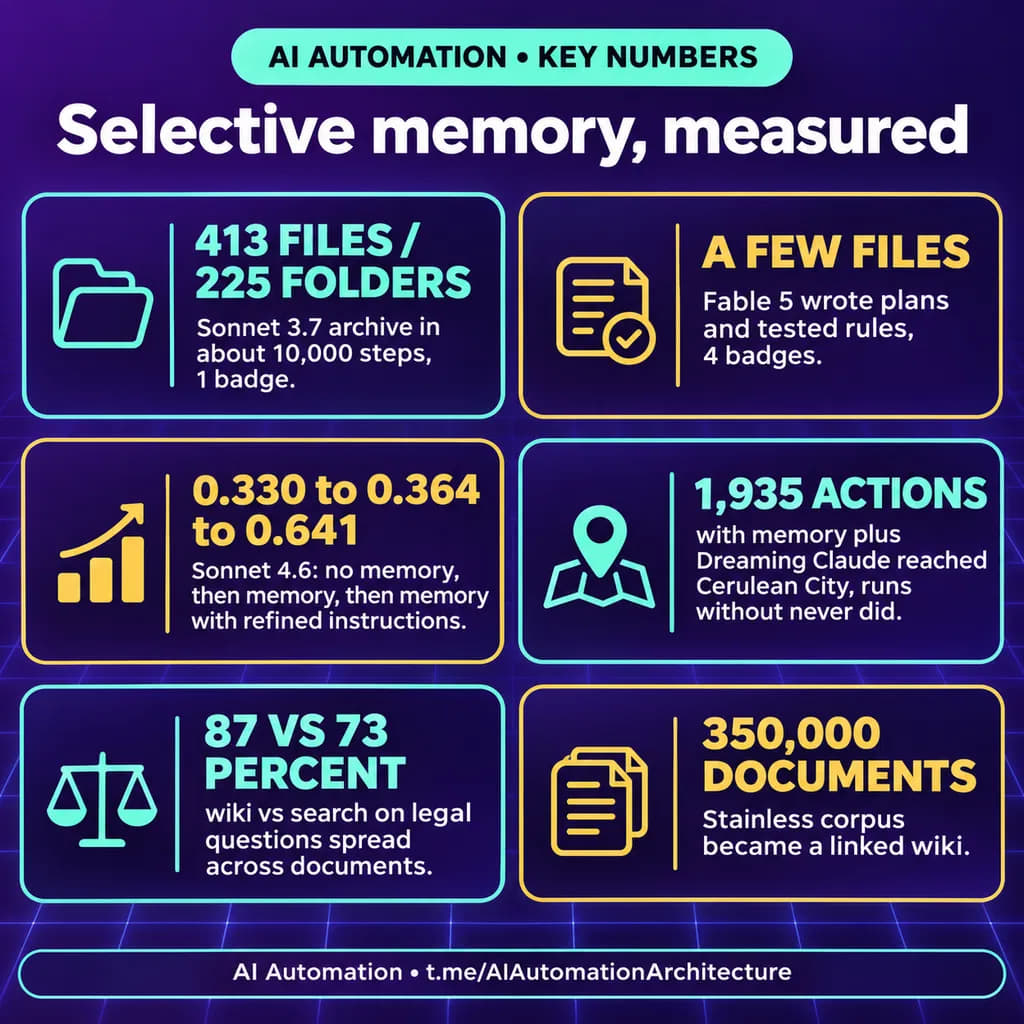
在 Pokemon Red 实验中,Claude Sonnet 3.7 使用不受限制的记忆,进行了约 10,000 个游戏步骤,留下 225 个文件夹、413 个文件,最终拿到 1 枚徽章。它有时会停下来整理笔记,挤占实际玩游戏的时间。
另一组使用 Claude Fable 5,把记忆限制为两个文件夹中的九个文件,另加一个仪表盘。记录内容也从屏幕上看到的现象,转向计划、策略和经过验证的规则,最终拿到 4 枚徽章。
有用的记忆,应该帮助下一次决策,而不只是证明过去发生过什么。
不过,这两组同时更换了模型和记忆方案,不能据此断言,减少文件就能把成绩从 1 枚提升到 4 枚。
指令也会改变效果。「只记录错误」这种僵硬规则,几乎抹掉了较强模型使用记忆的优势;较老模型却能从「每次回复前检查笔记」这样的明确指导中获益。原文列出的 Sonnet 4.6 得分分别是:无记忆 0.330、有记忆 0.364、记忆加优化指令 0.641,但没有讲清这里的评分定义。
Dreaming 怎样防止错误笔记越传越远
记忆还有一个麻烦:写下来之后,它可能逐渐偏离事实。
Dreaming 的做法,是让 Claude 在空闲时回看此前会话记录,再拿这些原始记录核对笔记。这项工作承接了 Letta 和 UC Berkeley 的相关研究。
原文举了一个游戏案例:错误笔记把 Claude 所在的位置记到了山的另一侧,导致它反复掉进同一个陷阱。经过一次 Dreaming,笔记被纠正,Agent 才找到正确路径。使用记忆加 Dreaming 的运行在 1,935 次动作后抵达 Cerulean City,没有它的运行则未能抵达。
这套思路也被用到知识库:约 350,000 份内部文档被组织成互相链接的 wiki,Dreaming 负责生成页面、补齐缺口、处理重复内容和断链。最佳效果来自 wiki 加搜索。法律测试中,涉及多份文档的回答,wiki 方案得分为 87%,仅搜索为 73%;简单查询则大致相当。
这提示了它的适用边界:需要跨文档拼接关系时,整理后的知识结构可能更有价值;查单个事实时,搜索已经能解决不少问题。
按原文描述,Dreaming 于 5 月作为 Claude Managed Agents 的研究预览推出,读取记忆存储及最多 100 次历史会话,去重后生成重新组织的存储,并保留原件。首发支持 Opus 4.7 和 Sonnet 4.6。
我的判断
我认同「把记忆当作需要维护的数据」这个方向。错误一旦进入长期记忆,后续会话就可能把它当作已验证事实。与持续追加笔记相比,保留原始记录、定期核对,更有利于发现这种偏差。
但这些成绩还不足以证明一套通用最优方案。游戏比较每个模型只有一次通关尝试,所有基准数字也都来自厂商测试。Dreaming 还要消耗额外计算,修正存在延迟,wiki 同样需要维护;自动加载过多笔记,则会占用上下文并传播错误。
原文还提到,OpenAI 在 6 月的 ChatGPT 记忆更新中也使用 Dreaming 这个名称,并报告时间准确率从 52.2% 升到 75.1%。名称相同,并不能证明两者实现一致,这项指标也不能直接与游戏成绩或法律测试比较。
目前更可靠的启发是改进记忆管理,而不是照搬某个文件数量。
能拿来做什么
- 给日常 AI 编程的项目笔记设定范围,优先保存已验证的约束、有效方案和未解决问题,避免把每次终端输出都塞进长期记忆。
- 让重要结论能追溯到会话记录或实际验证结果;发现 Agent 重复犯错时,检查它是否一直在读取同一条错误笔记。
- 在阶段性任务结束后整理记忆,保留原件再去重、纠错,减少 Agent 在执行任务途中频繁整理文件的干扰。
- 面对跨文档问题,可以比较「整理后的 wiki 加搜索」与直接搜索的效果,同时记录整理成本;简单查找无需默认增加一层 wiki。