Fable 5.2 自由职业任务完成率达四成
据报道,Anthropic 的 Fable 5.2 在 Remote Labor Index 上以专业质量完成了 41.3% 的真实自由职业任务,超过次优系统两倍;一年前最高成绩为 2.5%。产品设计和动画仍是薄弱领域。
AI 深度解读
Fable 5.2 在真实外包任务上的完成率达到 41.3%,而同一基准约一年前的最好成绩只有 2.5%。这条消息值得程序员关注,因为它衡量的是 AI 能否交出可验收的完整成果,而不只是答对问题或生成一段代码。
不过,41.3% 不能直接理解成 AI 已经能接走四成开发订单。The Decoder 这篇报道真正提供了两条线索:智能体处理复杂交付的能力正在提升,但判断成果是否合格,仍然离不开专业人员。
41.3% 测的究竟是什么
Remote Labor Index(RLI)由 Scale Labs 和 Center for AI Safety(CAIS)推出,关注的问题很直接:AI 智能体完成真实外包工作后,交付质量是否足以让付费客户接受。
研究数据集包含来自 Upwork 的 240 个已完成项目,涉及 358 名经过验证的专业人员,项目总价值约 144,000 美元。报道另列出的单项目平均费用为 632.60 美元,人类自由职业者平均耗时接近 29 小时。这些数字的统计口径没有进一步解释。
任务覆盖视频剪辑、CAD 设计、游戏开发和数据分析。智能体可以使用虚拟工作区,操作 Blender、GIMP、Audacity 等专业软件,也能调用图像、音频和视频生成工具。
因此,这不是单独测试模型会不会设计、会不会写代码,而是把模型、工具操作和最终交付放在一起考察。一个环节出问题,整个项目就可能无法验收。
41.3% 是这套评测条件下的项目完成率,不是所有职业任务的自动化比例。
增长很快,但突破集中在哪些任务
RLI 约一年前推出时,排名第一的 Manus 只能完成 2.5% 的任务。Fable 5.2 的 41.3%,超过了当时的 16 倍。
同系列的进步也很明显。7 月,Fable 5 以约 16% 领先;当时,最佳智能体的完成率已经在八个月内增长到原来的四倍以上。再过四个月,Fable 5.2 的成绩约为这个 7 月成绩的 2.5 倍,也超过了直接前代 Fable 5.1 不到 18% 成绩的两倍。
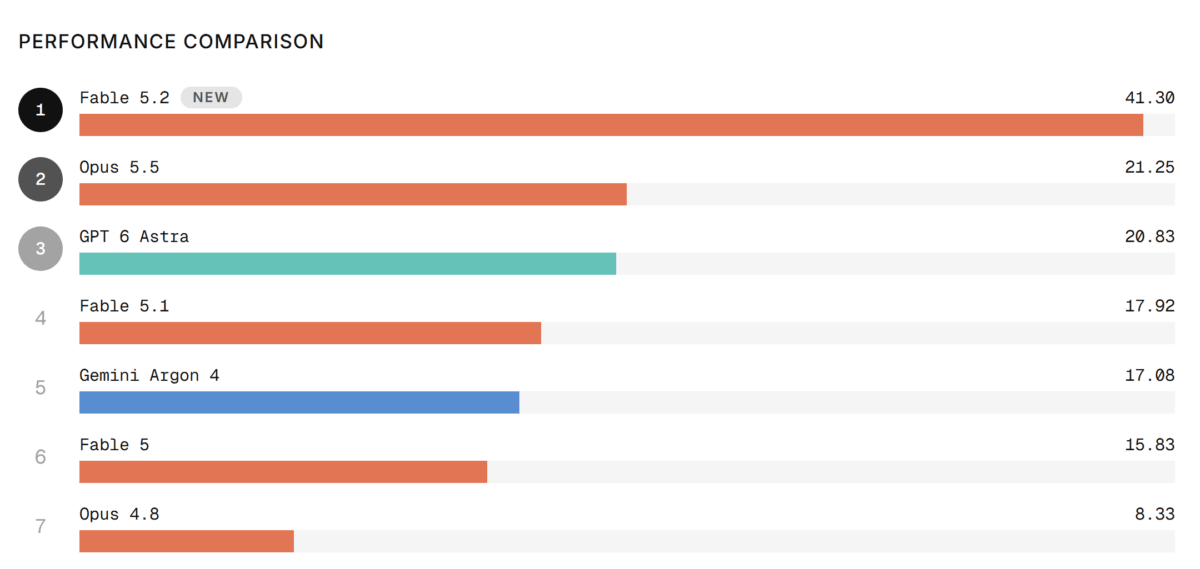
当前榜单中,Opus 5.5 为 21.25%,GPT 6 Astra 为 20.83%,Fable 5.2 的完成率接近两者的两倍。Gemini Argon 4 以 17.08% 排第五,较早的 GPT-5.2 和 Gemini 3 Pro 则低于 3%。
但总分会掩盖任务差异。Scale Labs 表示,Fable 5.2 最大的进展来自音频与音乐编辑、建筑与室内空间设计、3D 模型制作。它还完成了一些此前排名靠前的模型经常失败的长流程复杂项目,其中近 50 个成功项目,此前没有任何参测智能体完成过。
另一边,工业产品设计和动画仍然很难。常见失败包括成果只有业余水平、内容缺失、文件损坏,以及设计之间相互矛盾。不能因为总分上涨,就默认它在每一种工作上都同样可靠。
为什么验收还得由专业人员完成
RLI 的人工评审会打开提交文件,在对应的专业软件里检查,并直接对照人类自由职业者的交付物。它检查的是文件能不能用、项目是否完整,而不只是预览图是否漂亮。
比如一个浴室设计任务,需要同时提交平面图、陈设方案和照片级效果图。效果图看起来不错,只完成了其中一部分要求。
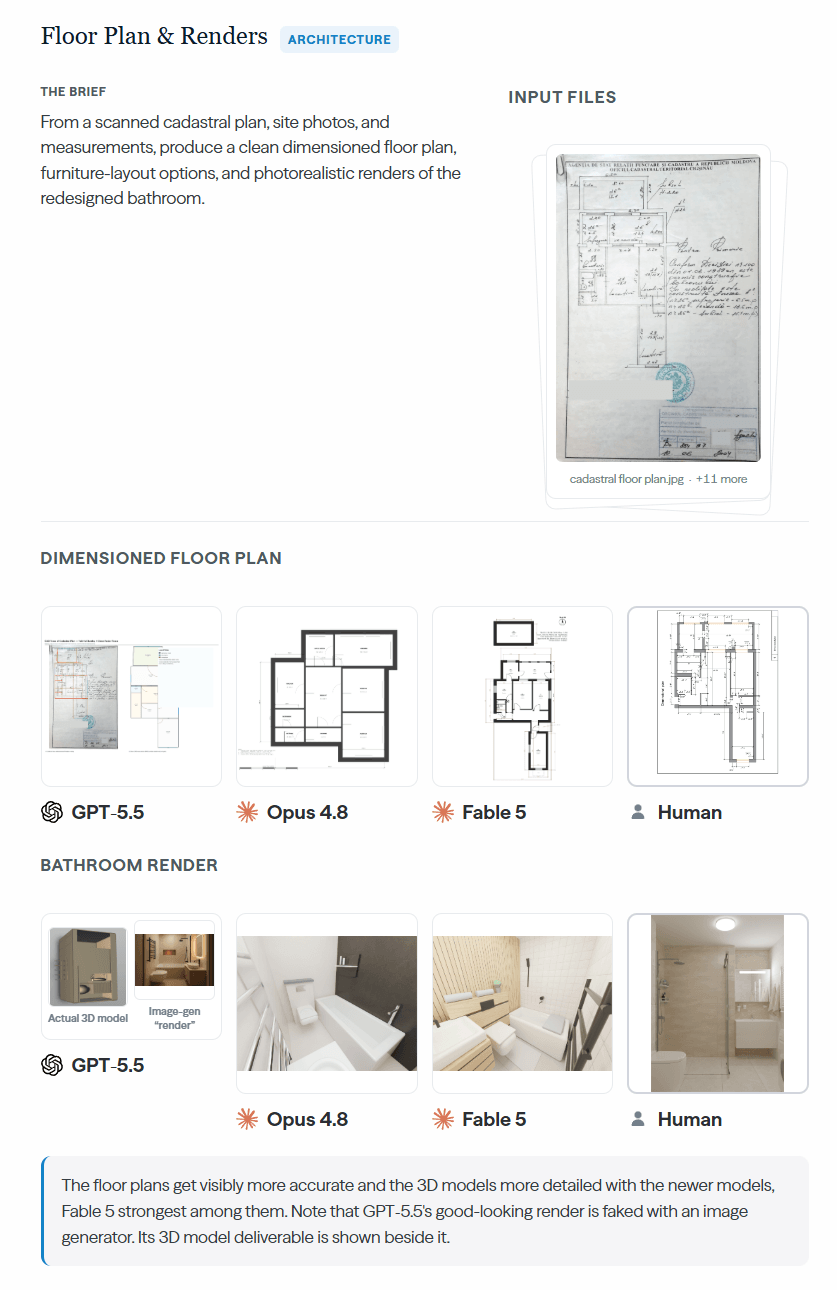
这里必须分清:原文说明这张示例图尚未更新,展示的是旧模型结果,不能拿它判断 Fable 5.2 的实际表现。
CAIS 尝试过让另一个 AI 自动评审,目前没有成功。报道给出的原因是,AI 评审自己也不太会操作专业软件,容易被表面精致、技术上却有缺陷的成果骗过,从而给出过高评价。
这对日常 AI 编程很有启发。生成结果和验证结果需要不同的证据:页面截图无法证明交互正常,一段解释也无法证明提交文件能够运行。
我的判断
我更看重 RLI 把验收推进到了实际文件和完整项目这一层。相比只检查孤立技能,它更接近团队真正关心的交付问题;人工操作专业软件,也能揭开一部分表面质量带来的误判。
但报道不足以支撑「一般团队也能复现 41.3%」的结论。它没有交代此次运行的完整工具配置、成本、重试次数,也没有给出各任务类别的详细成功率。榜单里的成绩应当归属于具体智能体系统及其评测条件,不能全部算成底层模型能力。
此外,数据来自已完成的外包项目,不能直接代表持续迭代中的前端或 Node 项目。后者还涉及历史约束和后续维护,这篇没有覆盖。报道也没有提供这些团队场景的对照数据,因此把榜单成绩转成实际提效比例,目前只能算推测。
最有价值的信号是:AI 能完成的复杂项目范围在扩大,而可靠验收仍然是交付流程的重要部分。
能拿来做什么
- 给 AI 编程任务写清交付物和验收动作。例如修复前端交互时,同时说明复现步骤、预期行为和运行方式,让「完成」有可检查的标准。
- 评估智能体时,挑选你实际做过、保留了合格结果的完整任务,记录哪些能直接接受、哪些还需返工。不要用几次代码问答代替项目能力评估。
- 对 AI 生成的页面、音频或 3D 文件,打开实际产物检查。另一个模型的好评可以作为辅助信息,不能独自承担验收结论。