用 PostgreSQL 构建分层语义检索
作者借鉴 RAPTOR,以 PostgreSQL、pgvector 和 Apache AGE 探索分层切块与检索,通过摘要层级、重叠语义分组和原文位置补足平面切块的上下文。方案支持多粒度检索,同时带来额外计算开销。
AI 深度解读
把文档切块、转成向量,再按相似度召回,能找到相关段落,却不一定能回答横跨多个章节的问题。作者为个人知识系统增加了语义聚类、分层摘要和图关系,让检索既能找到细节,也能找到更高层的概念,并沿着关系找回原文。
这套方案借鉴了 RAPTOR,但调整了建树顺序。它值得看的地方是如何把 PostgreSQL、pgvector 和 Apache AGE 串起来;需要保留疑问的地方也很明确:作者还没证明,增加这些计算和结构之后,检索效果究竟好了多少。
分块之上,为什么还要加一层语义分组
传统 RAG 的路径很直接:文档切块,生成嵌入向量,存进向量数据库,查询时召回相关块。
问题是,一个段落可能只讲清局部细节。回答跨章节的问题时,单个块缺少全局语境;多个块之间有什么关系,也没有被显式记录。
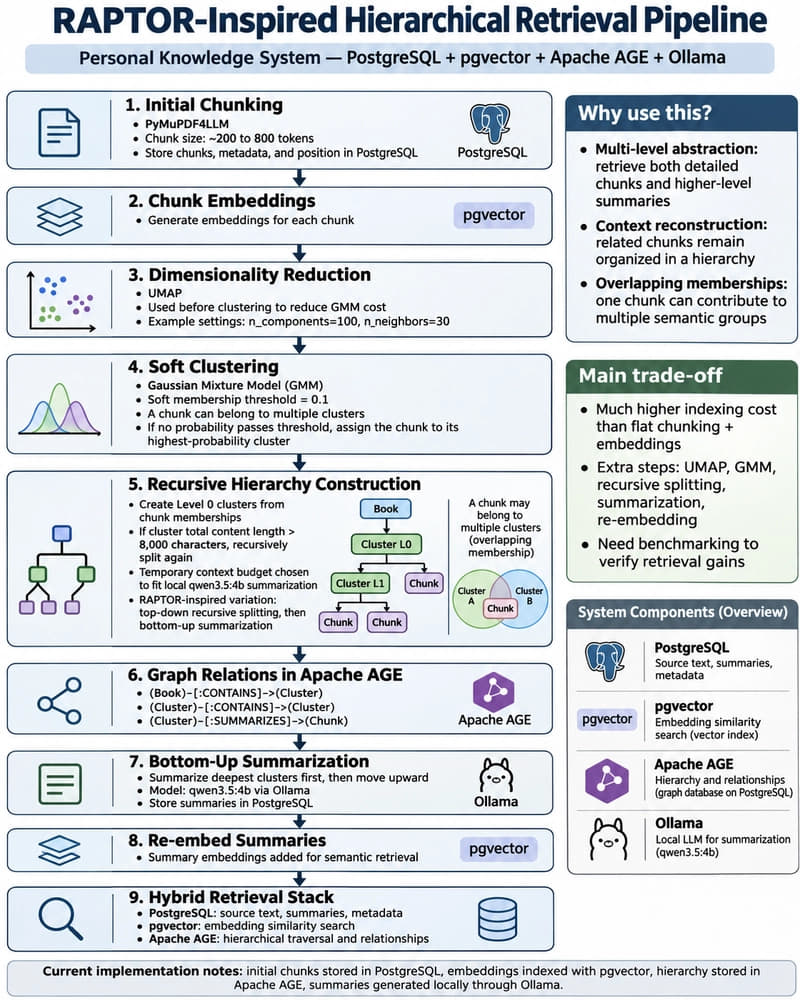
作者仍然保留基础切块,用 PyMuPDF4LLM 提取内容,将块大小控制在最少 200 tokens、最多 800 tokens,并把原文、元数据、原始位置和向量一起存入 PostgreSQL。原始位置很重要,因为语义上相关的段落未必相邻,而需要补充上下文时,又可能要找回前后段落。
在此之上,作者用高斯混合模型(GMM)做语义分组。与 K-Means 的硬分配相比,GMM 会给出一个块属于各个簇的概率。一个段落同时讨论多个概念时,就可以进入多个分组。
下面这段代码解决的是「如何允许同一块参加多个语义分组」:
model = GaussianMixture(
    n_components=5,
    covariance_type="full",
    reg_covar=1e-6,
    n_init=3,
    max_iter=300,
    random_state=224,
)

model.fit(embeddings)

probabilities = model.predict_proba(embeddings)
assignments = probabilities > 0.1
关键是最后一行:归属条件为概率严格大于 0.1,并不只取概率最高的簇。作者还补了兜底逻辑:如果没有任何概率超过阈值,就分配给概率最高的簇,避免遗漏。
高维向量加上 covariance_type="full",会增加 GMM 的计算负担。因此作者先用 UMAP 降维,配置为 n_neighbors=30、n_components=100、metric="cosine"、min_dist=0.0、random_state=224、n_jobs=1,通过 reducer.fit_transform(embeddings) 生成降维结果,再用于后续聚类。
这里的目标是尽量保留邻近关系,同时缩小聚类问题的维度。原文没有给出降维前后的耗时、内存或聚类质量对照,所以目前只能确认它的设计意图,不能据此判断收益大小。
这棵树怎样长出来,和原版 RAPTOR 有何区别
分组之后,作者计算每个簇的内容总长度。超过预算的簇,就对其中的成员再次运行 GMM,生成子簇,继续递归,直到内容长度落入预算。
当前阈值是 8,000 个字符,用来控制本地 qwen3.5:4b 的摘要工作量。它只是临时规则,作者计划换成按 token 计量的预算。字符与 token 不是固定比例,混合中文、英文和代码时,字符数尤其难以准确代表模型输入长度。
同一个块可以同时属于多个簇,因此这里展示的是层级结构,但成员关系并非互斥的严格树。原文示例中的 Chunk 2 同时出现在不同分支,就是为了让同一份内容参与不同主题的摘要。
这是一套受 RAPTOR 启发的变体,不能直接当作原版 RAPTOR 的复现。
原版 RAPTOR 从底向上反复聚类和摘要;作者先从顶向下拆分,再从底向上生成摘要。两者都提供多层抽象,但构造过程不同。
摘要阶段从最深层开始:原始块生成叶子簇摘要,叶子摘要再形成中间层摘要,最后得到根层摘要。作者通过 ollama.AsyncClient().chat 调用本地模型,设置 model="qwen3.5:4b"、think=False,并传入 options={"temperature": 0.5};消息由使用 SYSTEM_PROMPT 的 system 消息和承载 context 的 user 消息组成。
这里有个尚未完全说清的实施边界。作者强调,完整的递归摘要应让父层消费子层摘要,而不是每次重新拼接所有后代原文。但原文没有完整展示这部分实现,因此不能确认当前管线已经处处遵循这个原则。
摘要生成后会存入 PostgreSQL,再生成向量。这样系统能同时搜索两类内容:原始块负责细节,摘要负责跨段落概念;检索命中摘要后,再通过层级关系找到来源。
为什么把向量、图和原文都放进 PostgreSQL
作者不想维护三套独立数据库服务,于是让 PostgreSQL 保存内容,pgvector 承担向量相似度检索,Apache AGE 保存图关系。
图中的关系包括:
Book通过CONTAINS连接Cluster。Cluster通过CONTAINS连接子Cluster。Cluster通过SUMMARIZES连接Chunk。
每个图节点通过 UUID 引用 PostgreSQL 中的记录。图里保留标识和关系,大段原文仍以关系表为准。
下面的 SQL 展示了如何把图查询结果接回原文表,为生成摘要准备上下文:
SELECT
    (result.source_id::text)::UUID AS cluster_id,
    ch.meta_data,
    ch.raw_text AS content
FROM cypher('raptor_graph', $$
    MATCH (book:Book {id: 'BOOK_UUID'})
        -[*1..]->(c:Cluster {level: 1})
        -[r]->(d)
    RETURN DISTINCT
        c.id,
        d.id
$$) AS result(
    source_id agtype,
    target_id agtype
)
JOIN public.chunks ch
    ON ch.id = (result.target_id::text)::UUID
ORDER BY cluster_id, ch.position;
要看清两处边界:-[*1..]-> 用于寻找指定层级的簇,后面的 -[r]->(d) 只取这些簇直接连接的节点。它没有自动把任意深度的后代全部展开。查询还将 AGE 返回的 agtype 标识转为 UUID,再连接 public.chunks。
最后按簇和 ch.position 排序,SQLAlchemy 再按簇 UUID 归组,组织摘要上下文。
这个分工容易理解:图决定哪些内容相关,SQL 取出实际内容,应用层组织模型输入。原文展示了这条链路,但没有提供查询计划或性能数据,不能由「同一个数据库引擎执行」推导出「查询一定更快」。
我的判断
我认可的部分,是把摘要当作检索入口,并保留回到原文的路径。只拿摘要回答,容易丢失限定条件;只拿零散原文,又可能缺少跨章节概括。让两者配合,有明确的工程价值。
不过,结构更复杂,不等于检索效果已经更好。 作者明确说,检索准确率、延迟和索引成本仍需与普通平铺分块方案比较。目前这些属于实现经验和待验证的设计,不能当作效果结论。
成本也不只是多调用几次模型。UMAP、递归 GMM、摘要生成和摘要向量都会增加索引开销;重叠归属还可能反复处理同一内容。递归拆分必须确保子簇确实变小,否则可能无法收敛。作者提到了这些风险,但没有给出完整保护策略。
与常见替代做法相比,如果问题只是召回段落缺少前后文,可以先利用原始位置补取邻近块;如果只需要固定章节与段落的父子关系,也可以先用关系表表达。需要重叠语义归属、多层摘要和图遍历时,这套组合才更有吸引力。原文没有比较这些方案,选型仍要看实际查询。
另外,文章主要展示了索引构造。向量与层级关系怎样联合召回、如何排序、是否需要 reranking,都还没有展开。HNSW、IVF 和 embedding 模型选择被放到了后续讨论里,不能把当前架构视为完整的搜索方案。
能拿来做什么
- 做技术文档或项目知识库时,可以先保留块的原始位置、文档归属和稳定 ID。即使暂时只用平铺向量检索,也能据此补取邻近上下文,并为后续摘要关联留下基础。
- 给 AI 编程助手接入项目资料时,可以挑选跨章节问题,比较「只检索原始块」与「检索摘要后回取原文」的回答。核对答案依据是否完整,再决定是否承担分层索引成本。
- 已使用 PostgreSQL 的团队,可以小规模验证 pgvector 与 Apache AGE 的组合,重点检查图关系能否方便地接回原文表,以及递归拆分、重复摘要和 token 预算是否受控。
- 评估方案时,把检索准确率、查询延迟和索引成本一起记录。作者尚未给出这些对照结果,采用前需要用自己的文档和问题补上。