实测 Krisp 能否滤掉通话中的旁人说话
Krisp Voice Isolation 在语音识别前抑制背景人声,避免语音智能体把旁人的话当作来电者指令。作者用公开数据集中的 8 段真实录音,通过同一开源语音识别模型对比处理前后的转写。
AI 深度解读
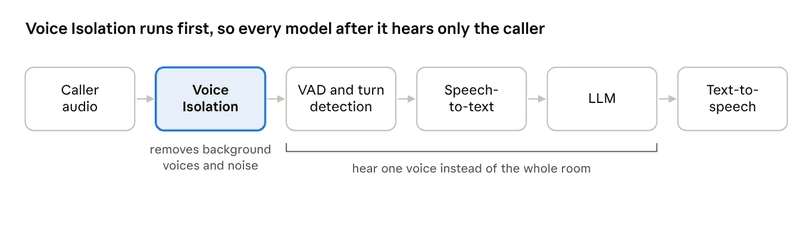
用户打电话取消订阅,旁边同事问了一句午饭吃什么,语音 Agent 却把两句话当成同一个请求。Krisp Voice Isolation 的做法是在语音识别和轮次判断之前先过滤旁人的声音。作者拿 8 段真实录音跑了一遍,主说话人停顿时被误转写的 331 个词全部消失。
这组结果最有用的地方,是把「两个人同时说」和「用户没说、旁人在说」分开了。前一种场景的识别改善有限,后一种却直接决定 Agent 会不会凭空收到一句指令。接入前要一起算的还有干净通话的识别损失,以及云 API 的跨区延迟。
旁人一开口,为什么连打断和轮次都会错?
语音转文字(STT)擅长识别人声,旁人的话也符合这个条件。交通声、空调声可以靠降噪压下去,但隔壁工位正在核对客户身份时,一句完整的话仍可能进转写。语音活动检测(VAD)也会听见它,导致 Agent 把旁人说话当成用户打断,或者误以为用户还没说完,迟迟不接话。
Voice Isolation 放在 VAD、轮次检测、STT 前面,也能接到语音到语音模型前。它过滤音频,后续组件仍各自负责识别、判断何时接话。Krisp 把它放在 VIVA 实时模型套件里,同套件还有 Turn-Taking、Interrupt Prediction 和 VAD。人与人通话使用的 Background Voice Cancellation(BVC)采用同一核心技术。它无需用户预先录入声纹,但依赖主说话人靠近麦克风。约 30 cm 以外,主声就有可能被压掉,实际距离取决于声学条件。智能音箱等远场设备有单独的纯降噪模型。
词错误率降了 73%,主要赢在哪段音频?
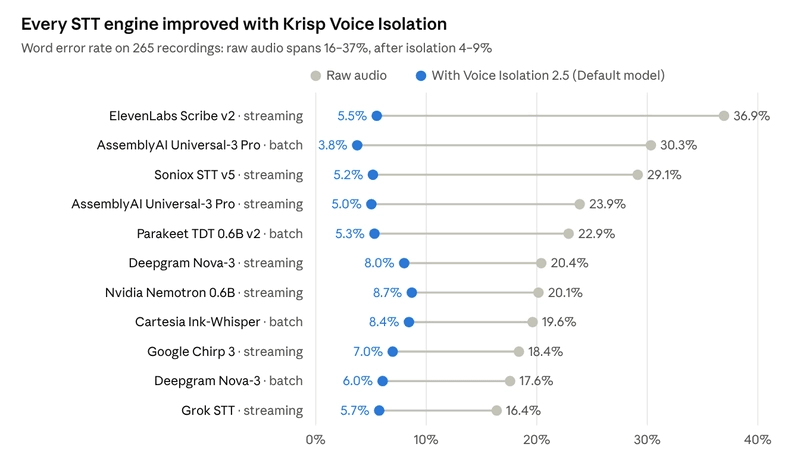
Krisp 的 2.5 发布测试里,10 套 STT 在干净单人音频上的平均词错误率(WER)是 2.10%,有第二个人同时讲话时升到 35.92%。另一套开放基准用了 265 段真实录音,覆盖办公室、家庭、汽车和 4 处运营中的呼叫中心,比较了 9 个引擎的 11 种配置。开启隔离后,平均 WER 从 23.24% 降到 6.24%,相对下降 73%。各引擎之间的差距也从约 20 个百分点缩到约 5 个百分点。官网另一个 46.4% 来自包含 1,685 段录音的 2.5 发布测试,两组数字应各自按测试口径阅读。2.5 于 2026 年 8 月发布,开放基准和数据集在 9 月公布。
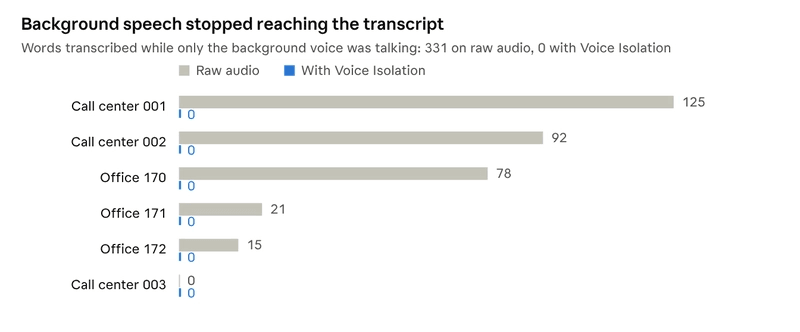
作者从同一公开数据集中选了 3 段办公室录音、3 段呼叫中心录音和 2 段车内电话,共约 11 分钟。他从亚洲按实时速度发送音频,将 32 kHz 转成 16 kHz,用 VIVA-tel 处理,再用 NVIDIA Parakeet TDT 0.6B v2 对照人工转写。合并 WER 从 40.1% 降到 10.2%。6 段录音包含只有旁人在说的区间,误转写从 331 词降到 0,旁人声降低 13–34 dB,主声电平变化在 1 dB 以内。两人同时说话时,WER 只从 13.2% 降到 12.5%,剩余误差多和电话号码、价格、邮编的格式有关。
隔离也会误删主声。官方基准的干净电话组 WER 从 3.48% 升到 3.91%,其中一个文件从 9.42% 升到 21.65%,Balanced 在这组是 3.53%。强回声单人录音在发布测试中,原始音频为 8.02%,2.5 处理后为 11.61%,2.1 则为 15.42%。人耳听得懂的残句,STT 有时会直接漏掉整段,因此试听和核对转写都得做。
WebSocket 怎么接,为什么 15 ms 不是上线延迟?
云 API 先由后端用 API key 换短时会话令牌。下面这段代码建立 WebSocket,声明用电话模型处理 16 kHz 音频,并等服务端就绪。
URL = "wss://streaming.krisp.ai/voice-isolation"

async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws:
    await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100}))
    hello = json.loads(await ws.recv())  # {"type": "ready", ...}
    # then send exactly 30 ms of audio per message (960 bytes at 16 kHz)
    # and write each binary message you receive to your output
发送单声道 16 位 PCM 时,每条消息必须恰好 30 ms,16 kHz 下是 960 字节。尾帧补静音,否则 invalid_frame_duration 会终止会话。suppression_level 范围是 0–100,默认最高,可在运行时调整。API 提供 8 或 16 kHz 的 VIVA-tel 和 32 kHz 的 VIVA-pro,后者在作者测试时能用,但 API 参考页尚未列出。
Krisp 给出的算法延迟是 15 ms,SDK 文档的附加延迟约 20 ms。云 API 只在美国区,作者从亚洲测得各会话中位帧往返耗时为 260–520 ms,建连通常要 1.5–3 秒。9 次会话里有 1 次在约 70 秒时异常关闭,重跑成功,单次记录无法定位断线原因。
API 和 SDK 的差别会影响哪些上线决定?
SDK 在自家服务器处理音频,只联网验证许可。它有 Default、Balanced、Lite、HD 四种模型。默认最高抑制下,Default 去除最多,Balanced 对主声处理更轻,算力开销相同。Lite 约用 Default 三分之一的算力,HD 面向 32 kHz WebRTC。SDK 文件名可见 krisp-viva-vi-tel-v2.5.1 这类写法。官方 CPU 示例里,支持 FP16 的 16 vCPU AWS Graviton3 开启 enableLowPrecisionExecution 后,从同时处理 76 路增至 137 路,较老的 Intel Ice Lake 则没有收益。
Pipecat 可用 KrispVivaFilter(),也能搭配 KrispVivaTurn,需要 SDK 和模型文件。LiveKit Cloud 提供 noise_cancellation.BVC(),隔离模型额外收费。按原文核验的 2026 年 11 月价格,Starter 无月费,两个 API 模型均为 0.18 美元/音频小时,5 分钟约 1.5 美分。试用给 30 美元、两路并发,额度有效期 12 个月,按分钟计费,约够 166 小时。Growth 月费 400 美元,含等额用量,单价降到 0.12 美元/小时。SDK 仅随定制报价的 Enterprise 提供。
我的判断
先看旁人讲话是否真的触发了误识别或误打断,再决定把预算花在输入处理还是 STT 上。公开基准给出了同一批录音的开关对照,也公开了失败样本,足够支持团队复用测试方法。作者的小样本只有一个 STT,录音也来自厂商公开集,331 词归零只能落在这批停顿区间。原文未给第三方隔离产品的独立横评,也没有语音到语音链路的公开结果。把 Krisp 当作优先试用项有依据,把它排在所有替代方案前面仍是作者的经验判断。
能拿来做什么
- 给现有语音 Agent 做一组开关隔离的回放。分别统计主说话人停顿时的误转写词数、双声重叠时的 WER、干净电话里的漏词,并记录 Agent 是否误打断或迟迟不接话。
- 在 Node 音频链路里按协商采样率缓冲 PCM,收到
ready后才发定长帧,并覆盖尾帧补静音和异常关闭后的重连。对亚洲用户的真实链路单独测建连时间、帧往返和首句响应。 - 做浏览器语音入口时,用实际耳麦和麦克风距离录样本。把远讲和强回声单列,核对姓名、号码等关键信息是否被吞掉,再决定哪些入口开启隔离。