同一模型换编程代理框架,解题率差近10个百分点
公开榜单对比了 11 套编程代理框架,平均任务解决率介于 42.7% 和 52.5% 之间,单个模型上的差距最高达 22 个百分点。同一框架重复运行也有 24.1% 的任务结果发生变化,榜单还记录了默认上下文窗口配置错误、响应长度限制未提示和上下文压缩未触发等问题。
AI 深度解读
同一组模型、同一批编程任务,换一套 Agent 的运行框架,平均解决率就能从 42.7% 变到 52.5%。但 Harness Leaderboard v0.1.9 还有个更容易被忽略的数字:同一个框架原样重跑,两次结果也有 24.1% 的概率一过一挂。
原作者在 2026 年 11 月 20 日读了 Joel Niklaus 的榜单和方法页,文中的数字都来自榜单。对正在选 AI 编程工具的团队,这组数据最实用的地方是帮你决定测哪一组搭配、怎么判断结果够不够稳,以及接入自定义模型时先查哪些配置。
同一个模型,为什么换个框架就会掉分
Harness 是模型和代码仓库之间的运行层。模型负责决定下一步做什么,框架负责把系统提示和工具定义交给模型,执行命令、应用代码编辑,再把结果送回去。对话太长时怎么压缩历史,出错后怎么重试,要不要派子 Agent,也由框架决定。模型权重一样,实际看到的信息和能执行的操作仍可能不同。
榜单固定了 11 个框架的版本。GLM-5.3-Flash 和 DeepSeek-V4.1-Flash 使用 1,048,576 tokens 的上下文,Flint 和 Ripple-65B-Preview 使用 262,144 tokens。两档大小是故意设的,较小的窗口更容易在长任务中触发历史压缩(compaction),能测到框架如何腾出空间。
Terminal-Bench 2.1 纳入 87/89 道终端构建、调试和配置题,DeepSWE v1.1 纳入 111/113 道真实仓库里的功能开发和修复题,涵盖 Go、Python、TS/JS、Rust。每个框架在每组模型与推理强度下逐题跑 3 次,榜单共记录 39,204 次尝试。任务说明、时间上限、联网权限和评分一致,沙箱代理统一约束推理强度并计量。每题不另设步数、token 或费用上限,框架沿用各自的默认提示词、工具、压缩和重试策略。
最便宜的一次,未必带来最便宜的结果
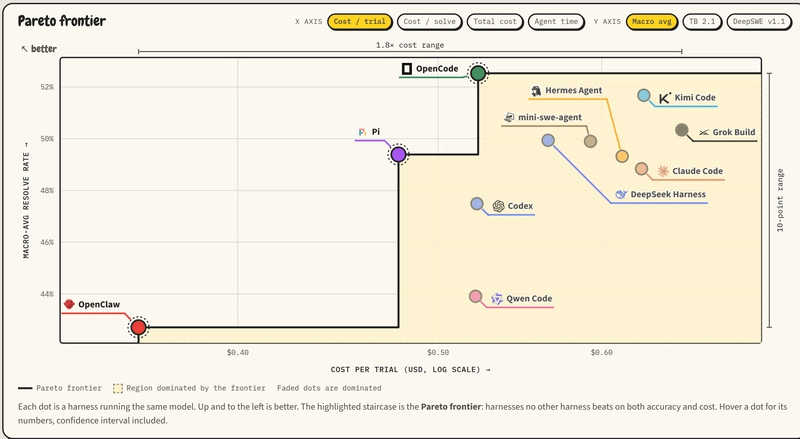
图里横向看单次运行成本,纵向看平均解决率。榜单先算每题的通过比例,再对各基准内的题目取平均,最后等权平均两套基准,并给出 95% 置信区间。把全部模型和推理强度放在一起看,有三个框架留在帕累托前沿,也就是找不到另一个框架能同时做到更便宜、解决率更高。
- OpenClaw 每次 $0.36,解决率 42.7%,单次成本最低。
- Pi 每次 $0.48,解决率 49.4%,榜单给出的每成功一题成本最低,为 $1.02。
- OpenCode 每次 $0.52,解决率 52.5%,是解决率最高的框架。按配对自助法(paired bootstrap)判断,只有低 0.9 个百分点的 Kimi Code 与它并列领先。
总榜适合用来筛候选。模型已定时,更有参考价值的是该模型那一列。OpenCode 和 Kimi Code 在 4 个模型上都进了领先组,但 Codex 在 DeepSeek-V4.1-Flash 和 Ripple-65B-Preview 上进入领先组,换成 GLM-5.3-Flash 就以 47.4% 排第 11。Ripple-65B-Preview 上,Kimi Code 的 56.4% 和 OpenClaw 的 34.4% 相差 22 个百分点。
重跑也会翻盘,默认参数还可能拖后腿
榜单把同一道题一次通过、一次失败记为一次结果翻转(flip)。原样重跑的翻转率是 24.1%,换框架是 27.1%,换模型是 33.8%。换框架比原样重跑高 3.0 个百分点,在 Terminal-Bench 2.1 和 DeepSWE 上分别高 4.0 和 2.0 个百分点。按这套测法,换模型更容易改变通过结果。看一场现场演示,很难判断换工具带来的收益能不能复现。
榜单里更容易直接复查的是默认值。OpenClaw 在未指定 max reply 时只请求 8,192 tokens,给自定义 OpenAI-compatible 端点回传上一轮推理内容也要手动开启。Codex 会给未知模型套用 272,000 tokens 的上下文,通过普通设置无法调高,需要改 model catalog,命令输出还会在 10,000 bytes 处截断。DeepSeek Harness 用 max reply 计算压缩触发点,像 Flint 这样两者同大的配置会让自动压缩失效。另两个边界也很具体,Claude Code 仅在连接 Anthropic 服务时按剩余上下文缩减回复上限,Grok Build 在模型设为纯文本时仍会发送读到的图片。
我的判断
我会把这份榜单用来缩小试用范围。它公开了复跑波动,也把框架出错和超时计为失败,比一次演示更接近团队面对的实际选择。不过,各框架分不同日期跑,供应商当天的响应速度会影响固定时限内能调用几轮。成本按通过等效性检查的供应商中最低的公开标价计算,团队账单还可能受到缓存折扣和订阅影响。
适用范围也要看清。这里测的是 Claude Code 和 Codex 驱动四个开放模型的表现,没有它们搭配 Claude 或 GPT 的对照。两套基准也无法代表自家仓库。作者建议用「三次全过」衡量无人值守任务的稳定性,这个指标比平均分更贴近实际需求。至于它能预测多少线上返工,原文没给对照数据,属于经验判断。
能拿来做什么
- 用同一个模型试跑候选框架,从自己的 TS/JS 仓库挑几道已有验收标准的构建、调试或修复题,每题跑 3 次,同时记录通过率、每成功一题的成本和三次全过的题目比例。
- 给自定义模型显式配置
context window和max output tokens,再跑一道会积累较长历史的任务,从运行记录核对请求实际带的上限,以及历史压缩有没有触发。 - 在比价前先确定失败后的处理方式。有人能接手时,可以关注每成功一题的成本。准备无人值守运行时,把三次全过的题目比例也放进选型表。