AI 测试报出 23 项问题,人工确认 8 项
作者将自研测试智能体仅凭网址运行于 Toolshop,30 分钟内探索 17 个页面,生成 289 项测试并执行其中 71 项。人工复核确认 23 项报告中的 8 项属实,其中包括密码长度校验与错误提示不一致。
AI 深度解读
只给一个 URL,AI 测试代理能测出多少真问题?TestOptim 对演示商城 Toolshop 跑了 30 分钟,标记出 23 个问题。作者随后到线上逐项复查:8 个成立,9 个被排除,另有 6 个需要账号才能核实。
这次实验有用的地方,不只是找到了 Bug,还公开了误报原因。对于想把 AI 接进测试流程的前端和全栈团队,它提供了一个具体参照:代理擅长检查页面之间的规则矛盾,却容易把猜出来的业务逻辑当成验收标准。
只给 URL,代理实际完成了多少工作
Toolshop 是不少测试人员学习 Playwright、Cypress 时使用的演示商城。作者团队把它作为 Weekly Teardown 第 2 期的测试对象;第 1 期测试的是 ParaBank,当时发现了无需登录的管理控制台。
这次 TestOptim 只拿到 URL,没有测试计划、凭据或提示。30 分钟内,它探索了 17 个页面,整理出 16 条用户流程和 29 条业务规则,生成 289 个测试,在时间耗尽前执行了 71 个,最终标记 23 个问题。
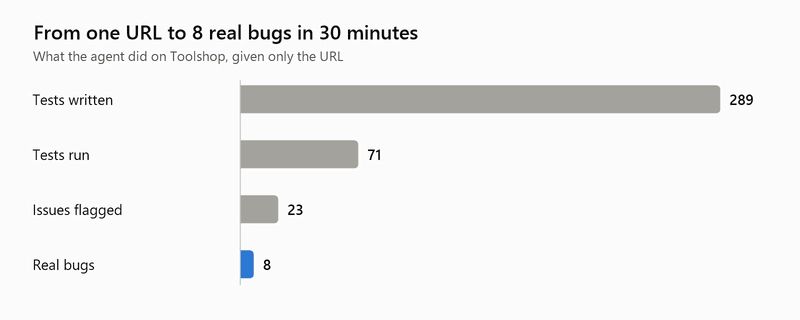
这里要分清生成量和执行量。289 个测试不等于完成了 289 次验证,更不代表已经覆盖整个商城。原文没有给出测试的具体分布,也没有解释哪些用例优先执行,因此还无法判断这 71 个测试的覆盖质量。
作者随后人工复查,确认 8 个问题,排除 9 个,留下 6 个待验证。
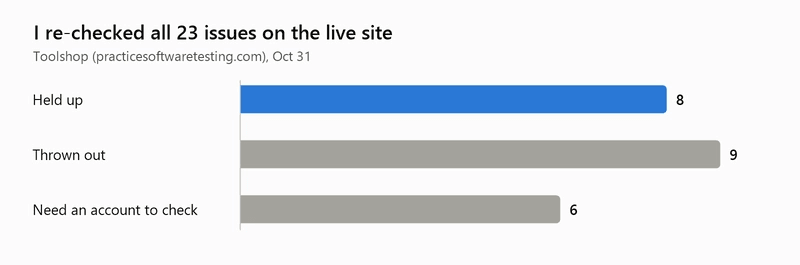
23 条发现是调查线索,8 个复核成立的问题才是这次实验已经拿到的结果。
真问题集中在规则不同步和异常状态
最典型的问题出现在注册密码上:页面说明至少需要 8 个字符,前端和 API 也都按 8 个字符校验,但输入 7 个字符时,错误提示却说最少需要 6 个。
下面两处代码分别约束前端表单和服务端请求,展示了实际执行的长度规则:
// sprint5/UI/src/app/auth/register/register.component.ts
PasswordValidators.minLength(8)
// sprint5/API/app/Http/Requests/Customer/StoreCustomer.php
Password::min(8)
注意两行中的 8。出错的是独立维护的翻译文件 assets/i18n/en.json,其中 fields.password.errors.minlength 仍然保留着 6 个字符的旧提示。
单独看每份文件都不容易发现异常;把页面说明、提交行为和错误信息放在一起,矛盾才会暴露。另一个密码问题也属于反馈错误:缺少特殊字符时,页面却提示包含非法字符,可能引导用户继续删除字符。
异常状态则暴露了页面的防御缺口。空购物车直接打开 /checkout,步骤条下面没有内容,控制台报出 TypeError: Cannot read properties of null (reading 'cart_items')。访问不存在的商品地址,也只剩空白页面和「Related products」标题,没有找不到商品的说明。
其余问题包括:Categories → Special Tools 指向空结果,公共 API 中也没有对应分类;忘记密码页面点击「Set New Password」后没有成功或失败反馈;「Show differences only」过滤了规格,却保留 Brand、Category、Availability 等完全相同的行;同一保修期限在商品页显示为 2years,比较页却显示为 2 years。
这些问题的影响程度不同,但有一个共同点:可以通过界面、状态或不同页面之间的对照来验证,不必先猜一套隐藏的业务规则。
误报说明,能操作页面不等于理解业务
被排除的 9 条发现,更能说明 AI 测试的边界。
代理把 1111-1111-1111-1111 银行卡和虚构礼品卡能够支付评为严重问题。但 Toolshop 没有接入支付处理服务,这属于演示环境的预期行为。虚构邮编返回编造的街道,也是类似情况。
环保折扣的误判则来自规则猜测。代码规定,购物车中超过一半的商品,其 CO₂ 等级为 A 或 B,才应用 5% 折扣。代理的测试购物车不符合条件,却得出了折扣从未生效的结论。作者明确承认这是他们的问题。
还有一些发现缺少需求依据:联系表单发送后消失、订单确认只显示发票号、分类页没有首页的价格筛选器、租赁卡片没有显示代理预期的价格。作者复查后将它们归为设计选择。
另有一条无法重现:代理报告空注册表单只显示 12 条错误中的 10 条,作者复查时已经能显示全部 12 条。剩余 6 条涉及购物车总额未更新、注册时 HTTP 500、支付步骤等,需要账号验证,作者没有继续推断。
自动探索可以发现可疑行为,但可疑行为是否违反需求,仍然需要证据。
我的判断
我认可作者公开误报和未确认项的做法。对评估工具的人来说,知道它为什么判断错,比只看一张问题数量图更有参考价值。
不过,这仍是一次演示站点实验。原文没有人工测试、既有 Playwright 或 Cypress 用例的对照数据,也没有给出节省工时的数据。「代理擅长发现规则漂移和冷门状态」是这次案例支持的经验判断,还不能直接推广为普遍效果。
它适合补充探索性测试:主动走页面、尝试异常输入、比较不同位置的反馈。已有的确定性测试则更适合守住明确的业务约束,例如折扣资格和结算金额。两者的价值不同,不能用生成测试的数量直接比较。
TestOptim 支持向 Slack、Jira 或 GitHub 发送带截图、复现步骤和严重级别的报告,这是原文介绍的产品能力;这次实验没有展示这些集成的验证结果。接入团队流程前,更该关注报告能否稳定复现,以及严重级别是否有合理依据。
能拿来做什么
- 给前端表单做一次一致性检查,把页面说明、校验规则、API 返回和国际化错误文案放在一起核对,优先排查密码长度这类重复维护的规则。
- 在日常回归中补上空购物车、错误商品 URL、提交后无反馈等状态,检查页面能否给用户明确的下一步指引。
- 让 AI 测试折扣、支付等流程前,提供业务规则和演示环境的约定,明确哪些行为是模拟,避免让代理自行补全验收标准。
- 把 AI 生成的问题报告先当作待验证线索,复核复现步骤与需求依据,再决定是否创建修复任务。