AI 视频服务如何约束生成与处理退款
作者将视频生成限制为双人、单场景和固定时长,通过场景模板与结构化提示减少输出失控。文章还讨论付费生成中的积分账本及失败退款,代码为简化示例。
AI 深度解读
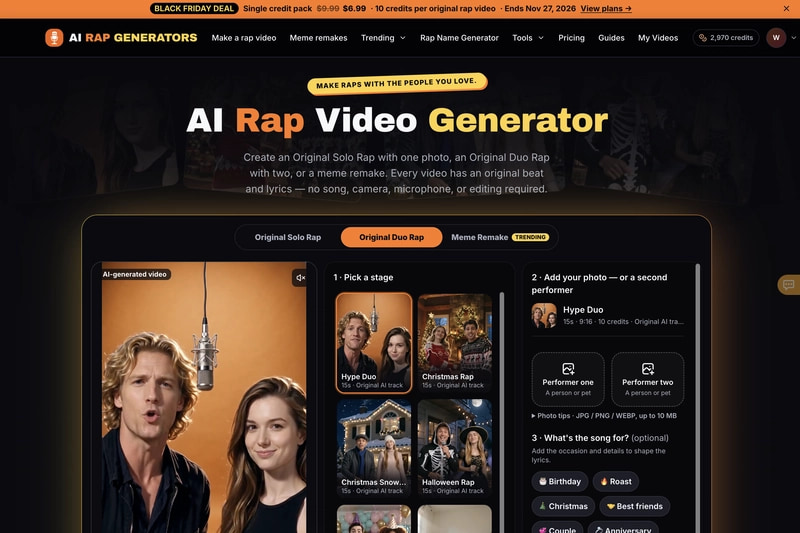
把两张人物照片做成一段带原创歌词和节拍的说唱视频,难点不只是让模型出片。作者做的 AI Rap Generators,把产品限制为 15 秒、9:16、两名成年表演者,再用结构化提示词控制画面,用积分账本处理扣费和失败退款。
这篇最值得程序员借鉴的,是怎样把一次有随机性的模型调用,包装成用户敢付钱的服务。不过,提示词效果主要来自作者经验,支付代码也只是简化示意,离完整生产方案还有距离。
为什么先限制玩法,再谈模型能力
通用视频工具把大量选择交给用户:怎么写提示词、镜头怎么动、音乐怎么配、跨镜头如何保持人脸一致。对独立开发者来说,每多一个自由度,就多一批需要处理的失败组合。
作者因此固定了「两个人、一个舞台、一段说唱」。用户的主要操作只有上传肖像和选择场景,例如吐槽对决、生日、宠物二重唱、屋顶,也可以补充名字或内部笑话。其他决定尽量交给场景模板。15 秒、9:16 MP4 的输出,也对应 TikTok、Reels、Shorts 的分享形式。
缩小输入范围,才有机会反复调好同一类输出。
模型选用 Seedance 2.0。按作者的描述,它能联合生成音视频,节拍、人声和表演在同一次生成中完成;参考图片则提供脸部、服装和发型等身份信息。这样可以减少后期拼接声音与口型的工作,但不等于口型和相似度有保证。
作者所用供应商的文档支持最长 15 秒,并允许单次请求组合文本和多张参考图。他也明确提醒,不同供应商的限制和参数可能不同。原文没有给出具体接入 API,不能据此直接写出调用代码。
提示词拆成五块,改动才有落点
作者最初为每个场景写一整段描述,结果不稳定,出问题也很难定位。后来改成五个区块:[Scene] 管身份与构图,[Music] 管音乐,[Timeline] 管动作节奏,[Lyrics] 管演唱内容,[Constraints] 管禁止事项。
下面这段屋顶模板,展示了如何把抽象的「来一段酷一点的说唱」拆成具体要求:
[Scene]
Use reference image 1 for the single rapper's identity, outfit, hair,
and proportions. On the rooftop terrace, keep the performer centered in
a locked-off knee-up vertical 9:16 shot. Preserve the city skyline,
string lights, palms, lounge furniture, and reflective stone floor;
no other people enter.

[Music]
Confident melodic rap, 110 BPM: hard kick, snare, rolling hats, deep sub
bass, piano-and-bell hook, airy pads. One clear vocal rides a constant
radio-loud beat.

[Timeline]
0-3s: bounce on beat and point at camera. 3-6s: broad arm sweeps.
6-9s: lean in with a smile and head bob. 9-12s: step side to side,
hands wide. 12-15s: keep the energy high and freeze on the final hit.

[Lyrics, in English, perform exactly these]
1. ...
(six lines)

[Constraints]
Accurate lip-sync, one rapper only, no subtitles or text, no cuts, no
camera move, no extra people. Keep the performer in the lower three
quarters, knee-up, with hands below the top quarter.
要留意 Use reference image 1 这一行:它指定了身份来源。不过,这份示例写的是单人表演,与产品强调的双人形式并不一致,原文没有解释,不能直接当成双人模板使用。
这些区块各有作用。固定机位和膝盖以上构图,可以减少镜头变化;110 BPM、明确的乐器和单一清晰人声,让音乐要求更具体;15 秒拆成五个 3 秒动作段,既提供变化,也安排了最后一拍定格的收尾。
歌词则主动压短:六行,每行约 7 到 10 个音节。作者认为长句容易让口型漂移,要求逐字演唱也有助于减少模型改写。但示例只保留了歌词占位,没有提供实际歌词供复现。
约束区块按失败现象逐条补充,比如禁止字幕、切镜、额外人物和镜头移动。原文提到要列出问题与规则的对应关系,却没有展示完整清单。
这里可靠的工程思路是把变量拆开,方便一次只改一项。至于成功率提高多少,作者没有给出样本量或对照数据。
一次生成,要按一笔交易来处理
视频调用会消耗真实成本,所以作者定了三条规则:先占用积分再调用模型;每次余额变化都写入只追加的账本;任务最终失败时最多退款一次。
产品每条视频消耗 10 积分,积分包从 $6.99 起,没有订阅,失败渲染自动退款。原文未说明起步积分包包含多少积分,因此无法据此计算单条视频的实际售价。
数据层分成 credit_ledger 和 credit_balance。前者记录 delta、job_id、idem_key 等信息,kind 限定为 purchase、hold、refund,且 idem_key 必须唯一;后者用 CHECK (balance >= 0) 防止负余额。
创建任务和占用积分放在同一个事务中。扣费通过带 balance >= $2 条件的 UPDATE 完成,并用 RETURNING balance 判断是否成功,避免先查余额再扣费之间的并发空隙。余额不足时抛出 INSUFFICIENT_CREDITS,占用记录使用 hold:job:${job.rows[0].id}。
退款路径则同时限制任务状态和账本写入:
const upd = await tx.query(
  `UPDATE jobs SET status = 'failed', error_code = $2, finished_at = now()
   WHERE id = $1 AND status NOT IN ('succeeded','failed')
   RETURNING user_id, cost_credits`,
  [jobId, errorCode]
);
if (upd.rowCount === 0) return; // 已经处于终态

const ins = await tx.query(
  `INSERT INTO credit_ledger (user_id, delta, kind, job_id, idem_key)
   VALUES ($1, $2, 'refund', $3, $4)
   ON CONFLICT (idem_key) DO NOTHING RETURNING id`,
  [upd.rows[0].user_id, upd.rows[0].cost_credits, jobId, `refund:job:${jobId}`]
);

if (ins.rowCount === 1) {
  await tx.query(
    `UPDATE credit_balance SET balance = balance + $2 WHERE user_id = $1`,
    [upd.rows[0].user_id, upd.rows[0].cost_credits]
  );
}
要注意 if (ins.rowCount === 1):只有确实新增了退款流水,才增加余额。重复回调、worker 重启和人工重试再次进入这条路径时,就不会反复退钱。这个保证依赖整段操作处于同一事务中。
重试沿用原任务和原占用,不能重新收费。
作者把超时、上游 5xx、限流归为可退避重试的问题;输入被拒绝、内容审核失败则不重试。只有进入最终失败状态才退款,并通过每晚比较余额与账本流水之和进行对账。
我的判断
这套做法适合借鉴:产品边界减少变化,提示词区块帮助定位问题,账本让收费行为可追溯。尤其是条件扣费与退款幂等,比应用层先查余额、靠回调只执行一次更经得起重复请求。
但原文的 hold 实际上直接扣减可用余额,账本也没有成功结算类型。它展示的是「先扣、失败再返还」的简化方案。示例没有完整覆盖提交生成请求后进程崩溃、供应商已接单但本地超时、成功回调与失败处理竞争等情况,也没有展示创建任务接口如何防止客户端重复提交。
提示词部分则属于经验之谈。没有对照实验,就不能确认五个标签本身带来了多少提升,也无法判断它与更短模板相比的成本收益。
另一个可取之处是把肖像规则写进产品:仅接受本人或已同意参与的成年人,不接受未成年人和公众人物,禁止色情、仇恨、欺骗及骚扰内容,输出标注 AI 生成。照片在七天后删除,通过存储生命周期规则和数据库标记落实。原文没有说明身份、年龄和同意如何验证,规则声明与执行机制之间仍有空白。
能拿来做什么
- 做 AI 生成页面时,先固定输出时长、比例和少量场景,把能力边界放到用户提交之前。这里的限制包括 15 秒、不支持自定义歌曲上传、仅面向两名成年人,以及肖像相似度会变化。
- 维护视频提示词时,可以按身份、音乐、时间线、歌词、约束拆分模板,记录具体失败现象,再逐项修改,避免一次改完整段后无法归因。
- 在 Node 服务中接入付费生成时,把任务创建、条件扣费和账本写入放进同一事务;退款同时检查任务终态和唯一流水,并让重试复用原任务。
- 承诺照片七天删除时,把存储生命周期配置和数据库状态处理一起纳入实现与检查,确保页面承诺有系统机制承接。