Agent 记忆研究:简单检索仍有竞争力
这份研究综述称,简单检索在一组七项测试中的六项胜过复杂记忆方案,并介绍检查记忆是否在行动时实际被使用的 MemUse。工程部分还涉及控制框架与沙箱隔离、异步子 Agent 等设计。
AI 深度解读
Agent 记得越多,干活就越靠谱吗?这份覆盖 2026-10-20 至 2026-11-03 的资讯汇编给出的答案是:未必。普通检索在多组测试里压过复杂记忆系统,任务成功也经常掩盖记忆浪费、规则违规和运行框架故障。
对写前端、Node 和 AI 编程工具的开发者,更有用的线索是:先证明检索出来的材料有用,再增加记忆结构;把模型决策与代码执行分开;验收时除了看结果,还要看 Agent 到底怎样完成任务。
记忆系统复杂了,为什么反而不占优势?
这组材料里,最值得放在一起看的,是 Naive RAG 与 MemUse。
前者拿不做信息提取、不做摘要、不修改记忆的普通 RAG,在 LoCoMo、LongMemEval、MEME、MemoryAgentBench 四个基准上,与复杂 Agent 记忆系统比较。结果是:普通 RAG 在 7 种配置中赢了 6 种。
它支持一个很实用的解释:原始证据能不能被完整找到,可能比记忆加工得多精致更重要。摘要会丢细节,提取会提前决定什么值得保留;当后续问题与加工时的预期不一致,被删掉的信息可能恰好决定答案。
不过,原文没有提供每种配置的分数、检索参数或成本明细。这能说明普通检索是必须认真对待的基线,还不能推出所有复杂记忆都该放弃。
MemUse 则把问题向前推进了一步:检索内容进入上下文之后,Agent 真的用了吗?
研究检查了 8,000 次 SWE-bench Verified 执行记录,发现大部分送达的记忆无关或重复。即使被判定获得了「有益记忆」,仍有 23% 的执行失败。这里要区分两件事:材料本身有帮助,不代表模型成功采用了它;任务最后成功,也不代表塞进去的材料都有贡献。
复杂结构也有适用场景。OpenWiki 把记忆组织成带来源引用的 wiki,再用证据图支持跨文档关联问题。在这类问题上,准确率从普通搜索的 0.10 提升至 wiki 的 0.52,加入图后又提升 27%,每个正确答案的成本下降 58%。原文没有交代这个 27% 的具体计算口径,不能直接当作增加 27 个百分点。
所以,真正的分界线是问题是否需要跨材料建立关系。查一个历史决定,与串起多个文档中的证据,可能需要不同方案。
LangChain 的设计 Agent 还提供了一个工程侧提醒:某版记忆曾膨胀到 500K tokens,后来把索引限制为 200 行。这是团队案例,并非通用最优值,但足以说明记忆也需要容量管理。
为什么要把 Agent 的决策与执行拆开?
Harness 可以理解为 Agent 的运行框架:负责组织模型调用、工具、状态、权限和任务流程。模型决定下一步做什么,运行框架负责让这一步可靠执行。
Anthropic 的 Managed Agents 把 harness、会话与执行沙箱分离,目标很明确:沙箱崩溃时,整个会话不必跟着消失。对于需要安装依赖、运行测试、修改文件的编程 Agent,这种故障边界很有价值。执行环境会出问题,任务状态仍应有地方保存。
相近的思路也出现在 CoworkOS:模型负责动作与委派策略,运行时持有执行状态。它在 12 个基准上与 Codex、DeepSeek Harness 竞争,但汇编没有给出具体分项成绩,不能据此判断谁全面领先。
LangChain 的 Managed Deep Agents v0.10 则解决异步协作问题。子 Agent 配置 "async": True 后,完成任务会通知编排者,减少反复轮询。轮询需要主 Agent 不断询问进度;事件通知允许它先处理其他工作。
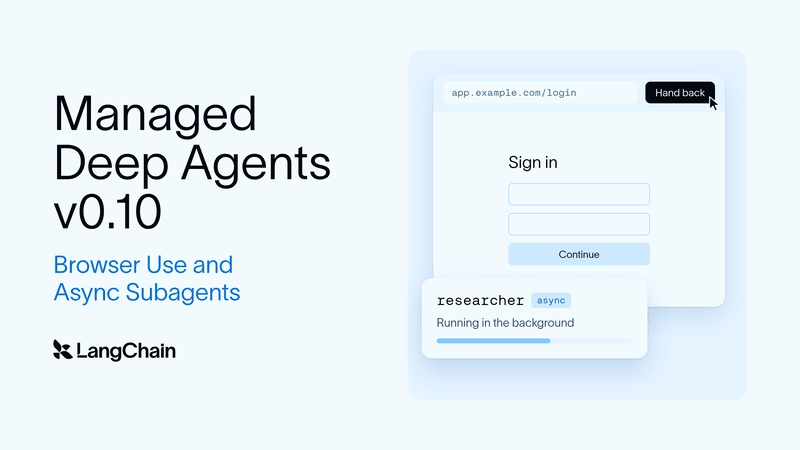
这个版本还提供沙箱浏览器,包含 browser_snapshot、browser_run、browser_screenshot、browser_handoff 四个工具,其中 browser_handoff 用于让用户完成登录,同时避免把凭据暴露给模型。升级时还要处理破坏性变更:connectors.mcp() 被移除,目录调整为 tools/mcp.ts|py。
其内部 WebVoyager 测试报告了 90% 准确率、总成本 $1.98;Browserbase/MCP 对照为 89%,成本约为前者的 9 倍。这里的限定词是「内部」:汇编未给完整测试条件,这组结果不能直接变成所有浏览器任务的选型结论。
基础设施压力也在变化。OpenAI 推出 Git 后端 Pando,原文称 master 分支提交量从 Q1 2024 到 Q3 2026 增长约 1,378%。这说明 Agent 产生的操作量可能改变系统瓶颈,但一般团队应先确认自己的瓶颈,没必要照搬大规模平台的改造。
只验收任务成功,会漏掉什么?
记忆之外,多篇研究都在提醒同一件事:最终结果不足以证明执行过程可靠。
Trial by Trace 沿执行轨迹,从七个维度检查 harness。它发现,31.1% 的运行虽然完成任务,却没有通过某些运行框架标准。这个数字不能解释成 31.1% 的答案错误,而是任务完成与框架合规没有完全重合。
ARCBench 检查长对话压缩后的规则遵守情况。问题通常不是规则文字被摘要删掉,而是 Agent 把后来的请求理解成了授权。针对压缩器的攻击还让违规数量增加到原来的两倍以上。保留规则文本,只解决了信息存在的问题,没有确保规则在决策时仍有优先级。
持久记忆又增加了一层风险。MemHarmBench 研究跨会话提示注入:恶意指令进入记忆后,即使原始内容被删除,后续会话仍可能受影响。原文强调,这类攻击往往没有明显异常,Agent 可以正常完成表面任务,同时执行有利于攻击者的动作。
LEANGUARD 选择在工具执行前检查策略。它用 Lean4 验证的规则约束每次调用,并能依据执行历史表达时序条件;检查不通过就拒绝执行。在报告的测试中,Tau-Bench 上禁止调用降至零,DTap 上直接提示注入成功率从 57.9% 降至 5.9%。这说明确定性的执行约束有价值,但不能把特定测试结果扩展成对所有攻击的保证。
接口也会改变过程。同样的工具操作、动作定义和后端,通过 MCP 与 CLI 暴露,94.3% 的配对执行出现了结构差异;修正方案 DART 在 MCP 上最多提高 9 个基准分,每个任务最多减少 27.1k tokens。工具功能相同,Agent 的调用成本与恢复路径仍可能不同。
我的判断
我认同这份汇编最核心的取舍:先建立可靠的简单检索基线,再要求复杂记忆拿出增益。 对维护代码库知识、历史决策和项目约束的团队,这比先搭一套自动摘要、关系图和记忆改写流水线更容易验证。
但作者最后归纳的「其他地方越简单越好」略显激进。普通 RAG 的 6/7 胜出与 OpenWiki 的跨文档提升,来自不同评测,不能拼成一张覆盖所有任务的性能排名。复杂系统是否值得,仍要看问题类型、来源可追溯性、维护成本和实际收益。
同样,故障隔离与事件通知有清楚的工程理由,但汇编没有给出它们相对其他架构的完整对照数据。团队经验、内部测试、论文基准,应分别理解。
这份材料本身也有编辑问题:开头条目和图片重复,Anthropic Engineering 栏目先说窗口期没有新文,后面又混入不同来源的文章。阅读时适合沿着具体研究和案例提取结论,不宜把栏目归属当成已经核实的事实。
能拿来做什么
- 为代码库问答建立普通 RAG 基线,保留原始文档片段;再用同一批问题比较摘要或图结构,记录正确率、成本,以及答案是否引用了真正相关的证据。
- 给 AI 编程流程补充轨迹检查,除了测试通过,还要检查越权工具调用、重复检索和无关记忆;涉及长对话压缩时,专门验证后续请求是否会被误当成新授权。
- 在 Node 编排服务中把任务状态与执行沙箱分开保存;有并行子任务时,用完成事件推进流程,并明确各子任务的文件所有权,减少同时修改同一文件的冲突。
- 接入 Managed Deep Agents v0.10 时,检查
connectors.mcp()的迁移和tools/mcp.ts|py布局;需要用户登录的浏览器流程,可评估browser_handoff,并用自己的任务重新测量成本和成功率。