CluSTER 用数据筛选压缩微调耗时
据文章介绍,KAIST 的 CluSTER 通过聚类均衡采样与数据并行分配,在所测任务中使用约 31% 的数据,将十小时训练缩短至约三小时,性能基本持平。实验覆盖约 70 亿和 130 亿参数模型,以及代码、医学领域数据。
AI 深度解读
KAIST 的 CluSTER 想解决一个微调中的浪费:数据有十万条,不代表里面有十万份新知识。按原文报告,它通过筛选训练样本、调整多 GPU 数据分配,最高节省 69.6% 的训练时间,同时让已测任务的性能基本保持不变。
值得程序员借鉴的,是它判断重复数据的方式:不只看文字像不像,而是看样本对模型学习的作用是否相似。不过,「只用约 31% 的数据」有明确的实验范围,筛选成本的统计口径也需要打个问号。
文字不同,也可能在教同一件事
常见的数据清理会删除重复文本、过滤低质量回答,再按主题补齐类别。CluSTER 多问了一层:这条样本究竟让模型学到了什么?
两道编程题可以有不同的业务背景、变量名和语言,却都在训练相似的能力。按文本相似度,它们可能相距很远;按对模型更新的影响,它们却可能高度重复。反过来,同属一个主题的样本,也未必在教同一种能力。
CluSTER 要压缩的是学习作用上的重复,而不只是文字上的重复。
这里的「学习作用」,可以理解为样本怎样推动模型参数更新。原文提到,通常可以使用梯度或影响度一类信号来衡量,但没有展开 CluSTER 的具体评分公式、近似方法和计算复杂度。因此,不能把这个介绍直接当成可复现的实现说明。
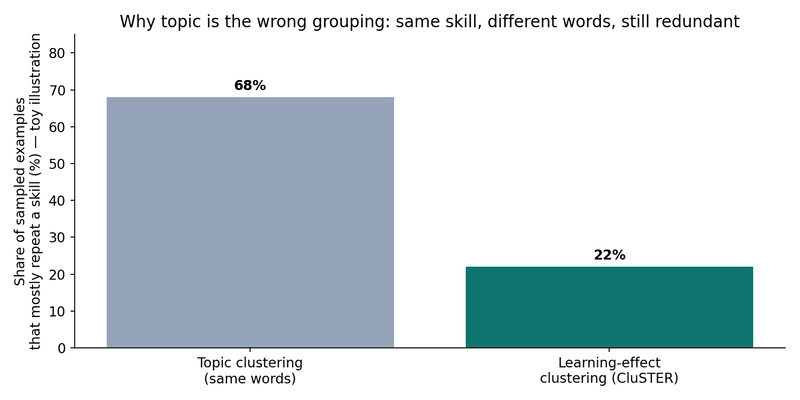
这个思路成立的前提,是数据里确实有大量重复教学。假如同一种能力已经出现了许多次,减少部分样本仍可能保留效果;假如数据原本就经过精细整理,每条都补充了不同的信息,可删的空间自然更小。
原文把一个簇比作一堂课,这个比喻方便理解,但不能把它当成严格保证。聚类结果只是评分信号下的相似分组,不等于已经准确识别了模型的全部技能。
为什么筛完数据,还要重新分给 GPU
CluSTER 的完整流程有四步,而且分配数据也是方法的一部分。
第一步,评估每条样本对学习的影响。第二步,把作用相似的样本聚成簇。第三步,跨簇均衡抽样,尽量保留不同学习作用的代表样本。第四步,在数据并行训练中,把这些样本均衡分给各张 GPU。
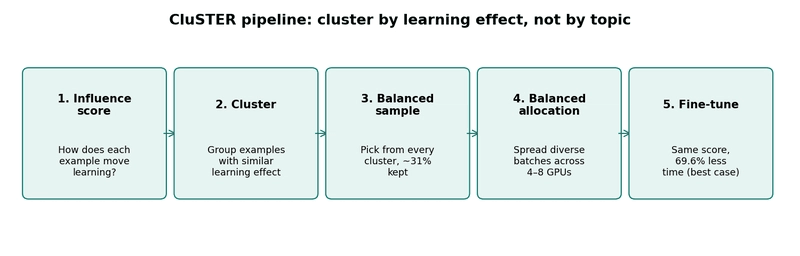
第三步解决的是覆盖问题。直接截取前 31% 的数据,容易保留数据集中占多数的类型;随机抽取 31%,也不能保证稀少类型一定留下。跨簇抽样试图减少这种遗漏:每类都留一些,而不是让大类占满预算。
但「每个簇都覆盖」仍然依赖前面的评分和聚类。如果少见但重要的样本被错误地归进大簇,后面的均衡抽样也救不回来。
第四步把视角从整个数据集推进到每张 GPU。原文认为,随机分片可能让某张卡集中收到相似样本,而另一张卡收到更丰富的组合;均衡分配则试图让各张卡都接触多种学习信号。
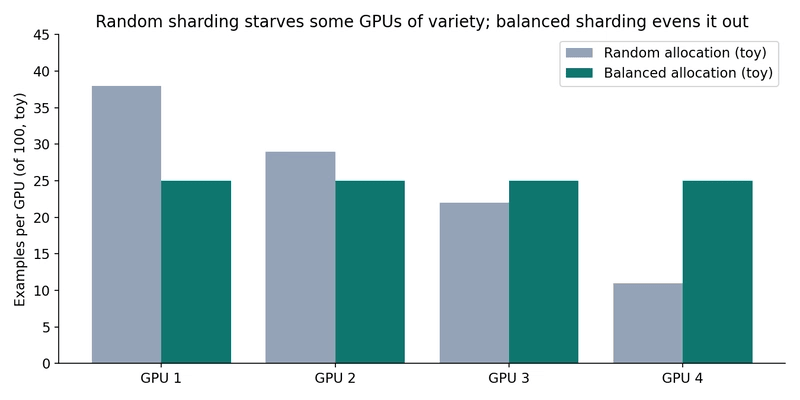
这里要区分两件事:样本提供的信息是否重复,以及处理样本需要多久。重复样本可能降低训练的信息收益,但不自动等于计算更慢。原文没有给出序列长度、每卡耗时等对照数据,无法仅凭这张示意图证明「重复最多的卡拖慢同步」。
能确认的是,CluSTER 同时考虑选哪些数据、怎样组织数据。各部分分别贡献了多少收益,这份介绍没有说清。
69.6% 和 31%,分别能说明什么
按原文,KAIST 于 2026 年 11 月 2 日公布这项工作,论文已在同年 10 月的 EMNLP 2026 发表,编号为 EMNLP 2026 main.342、arXiv 2609.12584。第一作者是 Hyunjin Kim,通讯作者是 KAIST School of Computing 的 Jae-Gil Lee 教授。
他们团队测试了约 7B、13B 参数的模型,覆盖编程和医疗领域的 3 个数据集、8 个基准测试,主要使用 4 张 GPU,也做了 8 张 GPU 的实验。这些是理解结果时必须带上的边界。
69.6% 是最高报告节省比例,31% 是医疗问答实验的数据保留比例,都不是通用配置。
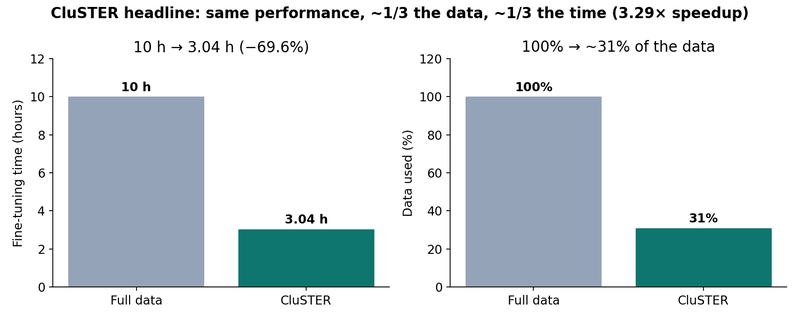
标题里的「10 小时到约 3 小时」,应按原文理解为比例演算:10 × 0.304 = 3.04 小时。对应加速比为 1 / (1 − 0.696),约 3.29×。它不能直接预测你自己的训练任务会节省多久。
「性能基本不变」也只适用于这些已测基准。介绍没有列出各项分数差异、波动范围,以及不同任务之间的取舍,不能据此认定所有能力都被完整保留。
筛选开销还有一处需要核实。原文一方面声称 69.6% 已包含流程成本,另一方面又用「净节省 = 6.96 小时 − 筛选成本」指导计算。这两个口径不能直接混用:如果筛选已经计入,就不应再扣一次;如果没有计入,才需要补扣。
对实际团队,应该统一比较完整数据方案的总耗时与「评分、聚类、抽样、分配、训练」的总耗时。原文没有提供足够的分项数据,无法消除这个疑问。
配套 notebook 据称演示了保留全部 5 种玩具技能的 31% 分层抽样、GPU 均衡分配,以及 3.04 小时、3.29× 和盈亏平衡计算。这些演示能解释机制,不能替代对论文实验的独立复现。
我的判断
我认同它把数据价值放到训练之前考虑。对需要反复做领域微调的团队,减少重复教学可能比继续堆数据更划算。它也不要求更换硬件,而是尝试提高已有训练资源的利用率。
但「几乎所有团队都在微调」「GPU 时间比数据更稀缺」属于原文的行业判断,没有给出调查依据。国内不少前端、全栈团队仍以模型 API、检索增强生成和提示词调整为主。如果业务没有训练环节,这个方法不会直接降低日常调用成本。
相比文本去重、质量过滤和按类别分层抽样,CluSTER 的优势设想是能发现更隐蔽的学习重复,代价则是额外计算和更复杂的流程。原文没有给这些替代方案的完整对照数据,因此不能据此宣布普通去重已经不够用。
所有核心成绩也都是作者报告,尚非这篇介绍独立复现的结果。医疗任务尤其不能把「8 个基准表现接近」理解为部署条件已经满足。至于预训练,原文明确没有回答它能否扩展过去。
能拿来做什么
- 如果团队正在微调代码模型,可以先检查数据是否重复训练同类能力,并用文本去重、质量过滤和类别分层抽样建立基线,再判断学习作用评分是否值得增加成本。
- 如果要试验数据裁剪,应同时记录筛选耗时与训练耗时,并单独检查少见任务的表现。不要把 31% 直接写成固定参数,也不要只凭一个平均分决定删多少。
- 如果使用多 GPU 数据并行训练,可以检查每卡的数据构成,并结合实际耗时判断分配效果。样本多样性是否改善、同步等待是否减少,需要分别测量。
- 如果日常只通过前端或 Node 调用模型 API,可以把它作为理解训练数据价值的材料。等业务出现明确的领域微调需求,再评估这套方法的投入产出。