用接口契约约束 Agent 跨语言通信
文章主张在服务端统一声明接口,通过 OpenAPI 和 AsyncAPI 生成 TypeScript、Python 客户端,让类型检查暴露跨服务字段偏差。同一份声明还用于生成审批表单,使审核者看到待执行调用的字段。
AI 深度解读
后端发送 {ticket_id, content},前端读取 {ticketId, body},两边测试都过了,页面却少了一条消息。作者用这个故障说明:跨服务接口最麻烦的错误,往往不会报错,只会悄悄丢掉信息。
他的办法是只在服务端声明一次数据结构,再生成 REST、WebSocket 客户端,甚至人工审批表单。值得读的地方,是它把类型约束推进到了审批环节:审核人看到哪些参数,也应该由工具契约决定。
两边各写一份类型,为什么仍然会出错
这篇是 Agent Graph Engineering 系列第 3 篇。前一篇把 Agent 与业务服务拆开,并划清状态归属;拆分之后,新的问题出现在代码库之间:双方如何持续同意同一份消息格式?
作者曾为一次 WebSocket 消息结构不一致排查了大半天。后端和前端各自内部都正确,但字段对应不上。JavaScript 读到 undefined,界面可能只是留白,于是排查方向先落在渲染、连接和序列化上。
各自拥有类型,不等于双方共享契约。
REST 已有相对成熟的路径:服务端声明序列化结构,导出规范,前端生成客户端。字段改名之后,编译器就能指出依赖它的位置。作者认为,Agent 使用的 WebSocket 通道也该获得同等待遇,不能只靠两边手写类型和代码审查维持一致。
这里还有一个顺序:先声明类型,再考虑生成。消息、工具参数、Agent 输出都应该有明确模型,这在单个代码库里就有价值。生成器解决的是第二个代码库出现后,结构必须重复表达的问题。
作者演示的应用有三个服务、两种语言,生成链路分别是:
- DRF serializers 经
drf-spectacular导出 OpenAPI,再由openapi-zod-client生成 Zodios client,另用脚本生成 TypeScript types。 - Backend consumers 经
chanx导出 AsyncAPI,再由chanx-js codegen生成带类型的 WebSocket 客户端。 - Agent consumers 通过
chanx generate-client生成 Python WebSocket 客户端。
统一入口是 gen:all = gen:schema && gen:type && gen:ws。重点不在命令多漂亮,而在边界另一侧的数据结构不再由人重复抄写。
生成器应该保留的不只是字段
作者展示了一个团队消息订阅通道。服务端声明它的路径,以及允许向客户端传递的六种事件:
class TicketTeamTopic(Topic[TeamFeedEvent]):
    """Outbound only: the actions a reviewer takes are sent on the ticket's own
    topic, which they are also subscribed to."""

    pattern = "ticket:{ticket_id}:team"
    passthrough_events = [
        NewEventMessage,
        AnswerStreamingMessage,
        AgentProgressMessage,
        ApprovalRequiredMessage,
        ToolProposalMessage,
        ReasoningStreamingMessage,
    ]
需要看的是 passthrough_events:这里就是该通道允许传递哪些消息的声明位置。
经过 AsyncAPI,前端生成结果如下:
export type HubTicketTeamTopicToServer = never;
export type HubTicketTeamTopicToClient =
  | AgentProgressMessage
  | AnswerStreamingMessage
  | ApprovalRequiredMessage
  | NewEventMessage
  | ReasoningStreamingMessage
  | ToolProposalMessage;

/** Outbound only: the actions a reviewer takes are sent on the ticket's own
 * topic, which they are also subscribed to. */
ticketTeamTopic: defineTopic<
  HubTicketTeamTopicToServer,
  HubTicketTeamTopicToClient
>()({
  name: 'ticket_team_topic',
  pattern: 'ticket:{ticket_id}:team',
}),
关键是第一行的 never。服务端没有声明入站处理器,这一限制被带进了 TypeScript:前端尝试向这个通道发送消息,会得到编译错误。
六种事件也完整进入联合类型。服务端加入第七种事件,重新生成后它便进入客户端类型;删除一种事件,前端依然引用该类型的相关分支就可能编译失败。至于新增事件能否强制所有消费分支补齐处理,还取决于前端有没有做穷尽检查,原文没有展开。
连 Python docstring 都变成了 JSDoc。开发者在编辑器里使用通道时,能看到它为什么只能接收消息,以及审批动作该发到哪里。维护一份解释,两种语言都能读到。
这比单纯生成接口名更有用:消息集合、通信方向和使用原因一起跨过了边界。
审批表单过期,会让人批准没看过的参数
工具调用审批是全文最有价值的延伸。
Agent 提议退款,审核人需要查看、修改参数,再决定是否批准。如果每个工具都配一张手写表单,工具新增字段后,表单可能没有同步。调用照常执行,审批记录也完整,但审核人从未见过其中某个参数。
审批界面的字段缺失,会直接影响审批是否知情。
作者让同一个表单引擎读取 Zod schema,生成字段、校验规则和默认值。它有两种输入:
REST 表单的 schema 来自 OpenAPI 生成结果;工具参数则在运行时通过 WebSocket 以 JSON Schema 到达前端,再转换成 Zod。
于是,新增工具不必先开发一套专属审批组件。只要参数已声明,通用引擎就能据此构建界面。作者给出的 issue_refund 审批页面中,退款对象、GBP 金额,以及供审计使用的退款理由,其帮助文字都来自工具 schema 的字段描述。
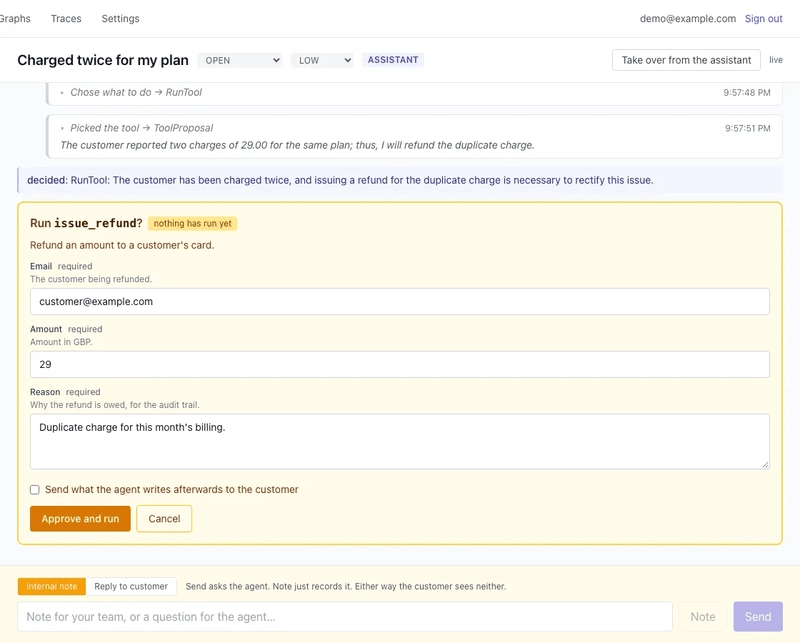
这里的收益是减少三份信息之间的漂移:工具接受什么、界面展示什么、前端怎样校验,都尽量从同一个对象读取。
不过,生成也有日常成本。修改 serializer 后忘记重新生成,报错可能指向生成文件,初次排查并不直观。作者建议用 pre-commit hook 或 CI 检查兜底,仓库还会单独用 --fail-on-warn 校验规范,让有歧义的描述先失败。
这个实现还依赖运行中的服务:前端生成器要请求实时 schema endpoint,just gen 会先启动所需服务。离线生成因此受限。生成代码不能手改,字段命名、可选性和判别联合的映射方式,也要接受生成器的选择。
我的判断
我赞同把 WebSocket 消息和工具参数当作正式接口维护。对于前端来说,静默缺字段很难定位;对于审批界面来说,缺字段还会误导审核人的判断。让这些信息共用声明,比要求每次评审都记得同步几处文件更可靠。
但原文关于表单「不会隐藏服务端接受的字段」的表达偏强。它成立的前提是 schema 完整、JSON Schema 到 Zod 的转换可靠,而且表单引擎支持所用结构。原文没有说明复杂条件、跨字段业务校验如何处理,不能据此推断所有校验都能自动覆盖。
类型生成也不能证明运行中的服务版本一致,更不能保证业务语义正确。编译器能发现字段名变了,却无法判断一个金额字段的含义是否改变。
相较于同语言项目直接共享类型包,生成器更适合跨语言边界;相较于手写专属表单,它减少同步负担,但特殊交互是否需要定制,仍要单独判断。作者没有提供故障率、维护工时或方案对照数据,因此这是具体实现支持下的经验判断。
适用范围也很明确:少量服务、一个团队、两种语言、每周变化。单服务单语言且已共享类型,或准备丢弃的原型,未必需要增加生成步骤。公共 API 的消费者无法由你统一重新编译,真正要解决的还是版本兼容。
能拿来做什么
- 如果前端和服务端各维护一份 WebSocket 消息类型,可以先挑一个稳定通道试做生成,确认事件集合、字段和发送方向都能保留下来,再扩展范围。
- 给 AI 工具增加人工审批时,让参数 schema 同时驱动字段展示、说明和校验,并核对每个实际执行参数是否都进入了审核界面。
- 把规范校验和重新生成检查接入 CI,避免只依赖开发者记得运行命令;原文的
--fail-on-warn可作为提前发现规范歧义的参考。 - 选型前先判断边界是否需要生成:同模块共享类型优先复用现有声明,跨语言再评估生成工具,对外 API 则另行设计版本兼容策略。