Agent 执行图如何选栈与划清边界
以 Python、Pydantic AI 和 LangGraph 组织 Agent 执行流程,将业务逻辑独立为服务,并用类型契约连接各层。方案涵盖流式通信、自有链路追踪、模拟模型测试与真实模型回归评估。
AI 深度解读
Agent 能回答问题,和它能稳定接进业务系统,是两件距离很远的事。这篇文章讨论后者:用 Python、Pydantic AI、LangGraph 和一套类型契约,把模型调用组织成能检查、能恢复、能测试的执行流程。
作者的核心主张很明确:系统结构应该直接声明出来,不能只藏在条件分支和工程师脑子里。对前端、全栈开发者,最值得借鉴的是模型、业务、通信和测试之间的边界,以及这些边界怎样减少联调与排障成本。
类型契约为什么比再调一次提示词更重要
作者所说的图,是 Agent 的执行图:状态、节点、边、路由、中断和恢复。它不是 Graph RAG,也不是知识图谱。后两者解决检索问题,可以作为某个节点调用的工具。
让模型返回什么、工具接受什么、消息怎样传递,都应该成为能校验的明确约定。
Pydantic AI 负责 Agent 层:声明输出类型和工具集合,用 Pydantic schema 验证参数与结果。模型传错类型时,错误在工具入口就被发现,不必等业务代码执行几层之后才出现 TypeError。路由也可以根据 isinstance 判断结果类型,不必在回复里搜索是否出现「escalate」。
工具依赖通过有类型的上下文传入,避免读取全局变量。Provider 抽象则方便为路由配置便宜模型,为综合回答配置更强的模型。但配置能切换,不代表不同模型的行为可以免测。
作者选择 Python,理由也在调用之外:本地模型部署、embeddings、评估工具、向量库和文档解析的生态。这个理由对需要这些能力的团队成立,却不足以单独证明已有 Node 技术栈必须迁移。
通信层用作者自己开发的 chanx,支持 Django、FastAPI 和 Litestar。消息定义成模型后,错误载荷可以在入口被拒绝;子图深处的节点也能发送进度事件,不必层层传递流句柄。
对前端更有价值的是生成 AsyncAPI 文档,再据此生成 TypeScript 客户端。REST 边界用 OpenAPI,WebSocket 边界用 AsyncAPI,让消息字段变化尽早变成编译错误。但 schema 只能约束结构,不能保证字段的业务含义始终一致。
什么时候值得把条件分支换成执行图
LangGraph 管流程,Pydantic AI 管单个 Agent。前者声明状态、节点和条件边,后者约束模型输出与工具调用,两者承担不同职责。
执行图的价值,在流程需要暂停和恢复时更明显。LangGraph 可以导出 Mermaid,查看节点前后的状态,并通过检查点(checkpoint)保存进度。人工审批于是成为可恢复的中断:等待用户决定,再从对应位置继续。
作者也承认成本:需要几周适应,第一版图很可能要推倒重来。它属于 LangChain 生态,部分使用方式带有该生态的假设;非 LangChain 代码的流式输出通过通用 custom channel 接入,chanx 用来补齐传输层。
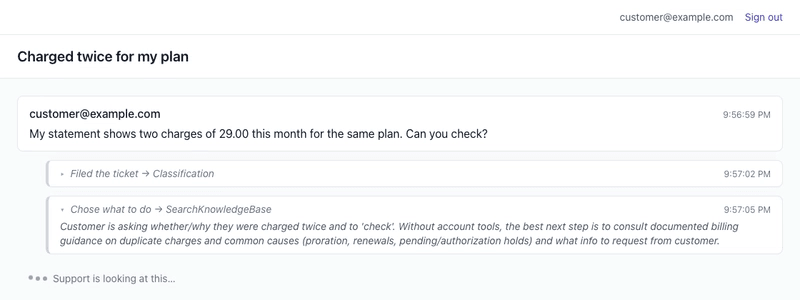
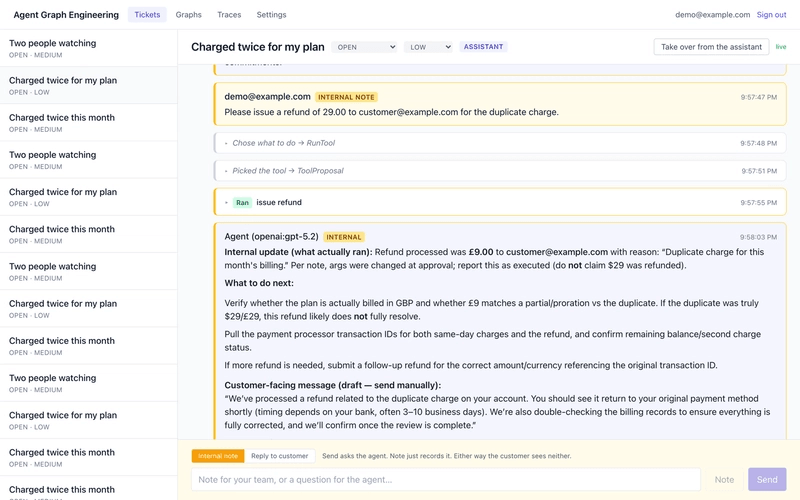
示例是客服工单分流。Agent 可以直接回答、搜索知识库、转人工或起草回复;真正向客户发送回复,需要人工批准。这样的流程既有分支,也有不可轻易撤回的动作,执行图才有明确用处。
服务边界同样关键:Django 管用户、权限、工单和历史,FastAPI 中的 Agent 服务管图、工具和检查点。Agent 只访问自己的数据库。
下面这张原文架构图,说明两个边界分别由什么契约连接:
flowchart LR
    FE["Frontend<br/>React"]
    BE["Backend<br/>Django"]
    AG["Agent<br/>FastAPI"]

    FE -->|"REST + WS<br/>OpenAPI"| BE
    BE -->|"typed WS<br/>AsyncAPI"| AG

    BE --- BEOWNS[["users, tickets,<br/>the thread a person reads"]]
    AG --- AGOWNS[["graphs, tools, checkpoints,<br/>the thread a model remembers"]]

    classDef owns fill:none,stroke-dasharray:4 3;
    class BEOWNS,AGOWNS owns;
重点看 BE --> 那一行:业务后端与 Agent 之间也有 typed WS 和 AsyncAPI 契约。前端展示、业务规则和模型执行各有归属,避免权限、计费规则逐渐混进提示词。
示例是三个服务、一个仓库。作者称它提炼自五服务生产系统,以及约五年的实时基础设施和 Agent 系统经验。这能解释设计来源,但不能替代读者自己的部署验证。
怎么区分代码坏了,还是模型表现变了
作者把测试分为两层,这一点很适合直接借鉴。
第一层是 pytest,在 HTTP 层拦截请求,返回记录好的 Provider 响应。不要直接替换 Pydantic AI 客户端,否则容易只测到替身行为。HTTP 层 Mock 能让真实的 SSE 解析、工具调用组装、流式输出和验证继续运行,覆盖完整 WebSocket 流程,适合每次提交执行。
第二层是真实模型评估(evals)。它回答另一类问题:改写提示词后,模型还会选对工具吗?换模型后,路由是否退化?可以使用 Pydantic AI 的 eval 模块,也可以写普通脚本。作者选择按需运行、从不放进 CI,原因是调用要花钱。
Mock 验证程序流程,真实模型评估验证模型行为,两者不能互相替代。
排障则依赖 OpenTelemetry。作者利用 LangGraph 与 Pydantic AI 的埋点,把节点和模型调用连接成一条 trace,并在 Agent 服务内部保存,通过 /traces 查看。向外导出由一个环境变量配置,可关闭、写文件、发送到 OTLP collector,或同时使用文件与 collector。
这里的验证范围交代得比较诚实:仓库用假 collector 检查 span 是否发出、endpoint 和认证 header 是否正确,没有逐一验证 Langfuse、Jaeger、Grafana 的实际接收。因此不能把「导出链路测过」理解成所有平台都已完成兼容测试。
我的判断
我赞同它把不确定性集中在模型选择,把其余流程尽量变成普通软件工程。类型、契约、检查点和 trace,分别处理输入错误、跨端漂移、执行恢复和问题取证,职责清楚。
但这不是经过对照实验得出的最优技术栈。原文没有给出采用前后的故障率、延迟、吞吐或开发效率数据。Pydantic AI 优于 Provider SDK、拆服务优于合并部署等判断,主要来自作者经验;chanx 又是作者自己的项目,「没人做同类能力」的说法也缺少比较材料。
简单的单步调用,用 SDK 加 schema 验证可能已经足够。拆分服务会增加通信与部署成本;业务边界可以先在代码中建立,是否独立部署,还要看团队规模和流程复杂度。
作者引用 Stanford AI Index 2026:相关职位占比从 2024 年的 0.06% 升至 2025 年的 0.23%,增长超过 280%,约九万个美国岗位;另有面向 1,674 位人才负责人的调查,52% 计划在当年年底前部署自主 Agent。这些是原文引用的市场信号,不能证明这套组件组合更优,也不能直接推导国内招聘需求。
示例仍缺少上下文预算、支出上限等能力,作者明确承认这一点。另外,检查点也不自动解决外部操作的重复执行问题;原文没有说清这部分。至于真实评估是否进入 CI,应按成本和风险决定,「永不进 CI」只是作者的取舍。
能拿来做什么
- 给现有 AI 功能梳理三类契约:模型输出、工具参数、WebSocket 消息。前端优先解决消息结构靠手写同步的问题,把生成客户端和类型检查接入日常构建。
- 遇到搜索、分流、审批和恢复交织的流程,再评估执行图。先明确哪些状态需要持久化、哪些动作需要人工批准,再选择节点和边。
- 把测试拆成 HTTP 层 Mock 与真实模型场景集。前者随提交运行,后者在修改提示词、工具定义或模型时执行,并记录路由和工具选择是否符合预期。
- 为每次运行连接节点与模型调用的 trace,并明确业务数据的归属。排障时先能回答「哪一步发生了什么」,再考虑扩展服务数量和观测平台。