五千余次调用揭示小模型裁判的评测陷阱
团队在多代理编码流水线中测试自动建议、按需调用和强制关卡三种裁判接入方式,发现高准确率主要来自多数类一致,代理也很少采纳建议。由于标签分布和评测设计存在问题,实验未能验证预期的Token节省,最终移除了裁判模型。
AI 深度解读
让便宜的小模型替大模型做判断,听起来是一笔好生意:筛文件、核验证据、拦截误报,都不必动用最贵的模型。但 TypeSafe 团队把 Jev 接入 Claude Code 多智能体流水线后发现:它经常答对,真正能改变决策的答案却很少。
这次实验最有价值的地方,是把「准确率高」和「值得接入」拆开了。线上运行两周多,最终帮助他们做出去留决定的,是一天完成的离线实验。对于正在给 AI 编程流程加评审、加工具、加检查关卡的团队,这个过程比单看模型分数更有参考意义。
准确率接近 96%,为什么仍然没用?
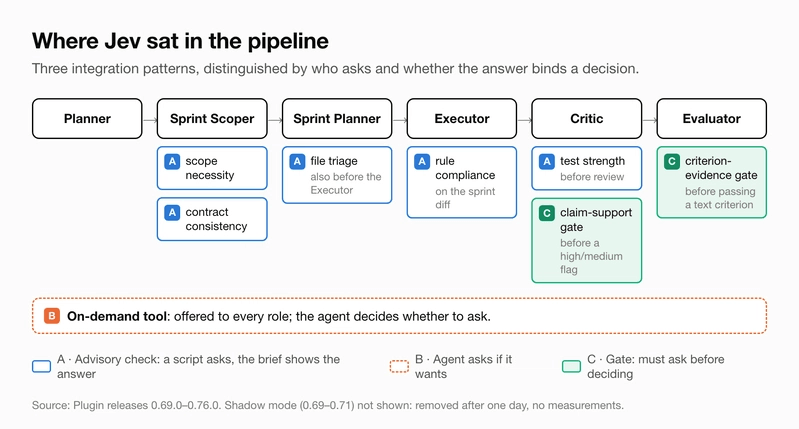
作者在 2026 年 10 月的 16 天里,把 TypeSafe 的小型判断模型 Jev 接入 Plugin。这个系统通过 Planner、Sprint Scoper、Sprint Planner、Executor、Critic 和 Evaluator,完成需求拆解、实现、审查与验收,主要执行者是 Opus 和 Sonnet 级别的模型。
目标很明确:把范围有限的判断交给便宜模型,让大模型少花 token,同时保持结果质量。不同任务的输入中位数从约 1.5k 到 26k tokens,延迟中位数为 250–500 ms。
五次真实构建产生了 4,222 次调用,离线实验又增加 1,092 次。10 月 2 日至 18 日,相关集成经历了 20 次发布、491 次提交。投入不算小,但他们最终没有测出最初想要的 token 节省,因为前置条件始终没有通过:Jev 的判断必须先证明可靠。
文件筛选最能解释这个落差。候选文件中约 96% 与任务无关,一个永远回答「无关」的模型,也能拿到 96% 准确率。团队自己的报告曾依据 0.956 的筛选准确率、0.833 的范围必要性准确率,建议保留这些检查。
如果多数答案本来就正确,高准确率可能没有增加任何决策信息。
因此,作者转而看 AUC 和平衡准确率。AUC 可以理解为:随机拿一个正例和一个反例,模型有多大概率把正例排在前面。0.5 接近随机,1.0 表示完全分开,低于 0.5 则方向反了。平衡准确率先分别计算两类的正确率,再取平均,永远猜多数类只能得到 0.5。
标签也出了问题。某次构建的 801 个文件标签里,没有一个相关文件;规则检查没有违规样本;验收条件的标签全部是「满足」。这样的数据无法证明模型能找到少数异常。模型没有抓到问题,可能因为能力不足,也可能因为测试集根本没放问题进去。
自动提醒和按需工具,都没有形成有效决策
第一种接法是自动咨询:脚本在固定位置调用 Jev,再把结果写进智能体开工前的上下文。
主构建里,768 次文件检查产生了 2,304 个判断。「是否与任务相关」的 AUC 只有 0.54。后来被智能体读取或修改的 24 次文件检查中,有 21 次被筛掉了,涉及 18 个不同文件。
「是否可能需要修改」却拿到了 AUC 0.955,看起来很强。但它只有 6 个正例,涉及 5 个文件,而且正例得分全部落在 0.31–0.53,低于人工设置的 0.7 路由阈值。最终只有一个文件被送进上下文,还是错的。
这里有两个不同问题:模型能否把对象排对顺序,以及系统有没有把这个排序变成合适的动作。高 AUC 不保证固定阈值好用。作者建议改成 top-k,也就是取分数最高的若干项,但没有实测这个改法。
其他检查同样没有站稳:
- 范围必要性判断共 240 次,其中 172 次,即 72%,没有可用结论,包括 154 次不确定、18 次证据不足。
- 契约一致性检查的 191 次回答全部是「一致」,置信度中位数为 0.98。真正的矛盾发生在契约与现有代码之间,而输入根本没有包含相关代码。
- 测试强度的 AUC 为 0.23。弱测试与有效测试的分类准确率为 0.49,即 62/126,低于始终猜「有效」的 0.87,即 110/126。但这里用 Critic 是否在测试所在 diff 块中报问题作为标签,只是测试质量的替代指标。
四次有标签的构建,智能体实际依据建议采取行动的答案分别只有 0、2、39、10 个。
第二种接法是提供按需工具,让智能体自己决定何时询问。主构建约 157 次任务执行提供了工具,使用率只有约 8%。Critic 有一次构建询问了 27 次「引用代码是否支持自己的发现」,26 次返回不确定,没有一次达到 0.8 的「支持」门槛。
数据没能解释智能体为什么不用:可能是建议可选,也可能是建议质量不够。不能据此直接认定「强制调用」就能解决问题。
强制过关以后,才看清它擅长什么
第三种接法从 Plugin 0.76.0 开始:Critic 提出高、中严重度问题前,必须询问 Jev;Evaluator 通过纯文本验收条件前,也必须询问。
但关卡上线当天,团队就决定移除 Jev。线上只有一个 sprint、三个已回答关卡,远不足以判断效果,于是作者重建历史审查记录,进行离线测试。
他们从 313 份 Critic 记录中恢复了 915 条发现,其中 721 条能取得问题行周围各 25 行代码,再构造三组样本:232 条原始问题、127 条修复后仍沿用原指控的问题,以及 232 条配上其他文件代码的问题。
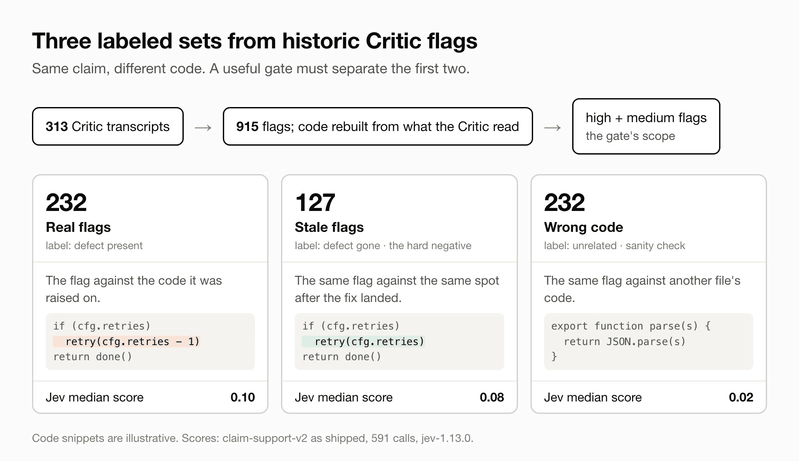
三种请求分别调用了 591、142、359 次,合计 1,092 次。结果把能力边界划得很清楚:
判断「代码是不是在谈这件事」,Jev 的 AUC 达到 0.97;判断「缺陷是否仍然存在」,原版提问的 AUC 只有 0.62,平衡准确率为 0.51,几乎等于永远回答「支持」的 0.50。把代码窗口扩大到上下各 150 行,没有改善。
按上线配置,关卡会质疑 82% 的真实问题,其中高严重度问题达到 94%,同时没有一条获得「支持」。
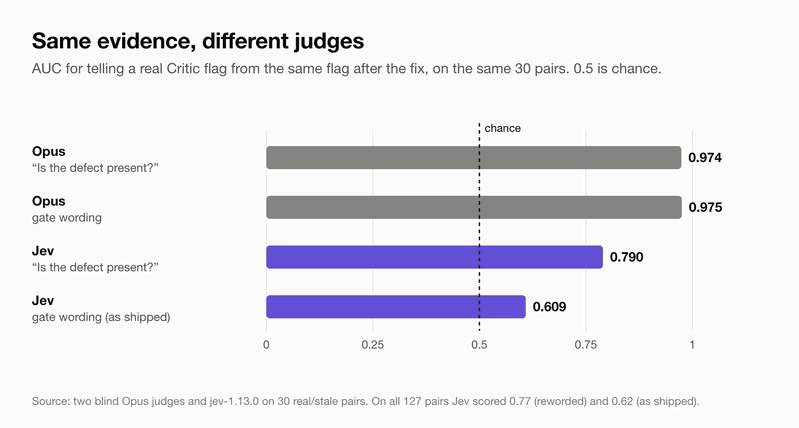
提问方式也在影响结果。把严格的「证据是否确立这一精确主张」改成「展示的代码中是否存在这条发现描述的缺陷」,Jev 的 AUC 从 0.62 提升到 0.77。
在同一组 30 对原始、修复后样本上,两名盲测 Opus 裁判使用两种措辞都达到 0.97–0.98;Jev 原措辞为 0.61,改写后为 0.79。原版措辞下,连 Opus 都没有给真实问题打出不低于 0.8 的分数,说明「支持」门槛与问题表述之间也存在错配。
识别代码与指控相关,不等于能判断指控是否成立。
作者据此移除了 Jev,保留离线测试脚本。用改写后的分数给历史问题排序、辅助复查,仍是一个可能方向,但没有验证,也没有被他们认为足以支撑继续集成。
我的判断
这次实验最值得认可的是:作者没有把调用量、延迟和准确率直接包装成收益。小模型更便宜,只能证明单次调用成本可能较低;如果它漏掉关键文件、质疑大量真实缺陷,整个流程是否省钱仍需另算。
但这也不是「小模型做裁判不行」的通用结论。实验只覆盖一个代码库、一个版本 jev-1.13.0,Opus 对照只有 30 对样本。不同构建的文件相关性 AUC 从 0.54 到 0.825,已经说明任务分布影响很大。
标签的可信度还要打折。所谓真实问题,由同一 Critic 家族确认并交给修复者处理,缺少独立核验;127 条失效问题是用修复后代码构造的,不一定代表真实误报。流水线里的 111 次复查全部认为发现有效,真实误报率仍然未知。
相比直接让强模型复核,小模型方案需要额外证明成本收益;相比命令验证,它又缺少确定性。主构建中,18 次 Evaluator 关卡有 17 次因为命令已经验证条件而被跳过,实际得到的 9 个回答全部是「证据不足」。能由命令检查的条件,继续让模型判断未必划算。
作者提出的 top-k、补充契约涉及的代码、用改写提问辅助排序,都有道理,但仍是未验证建议。真正得到数据支持的是:先做包含正反例的离线评测,比直接接入生产流程更容易发现问题。
能拿来做什么
- 给 AI 代码审查加裁判前,先准备包含真实缺陷、修复后代码和无关代码的小样本集,同时比较多数类基线与强模型。不要只拿一批正常代码计算准确率。
- 给前端或 Node 项目做文件筛选时,分别验证排序和阈值。如果分数能排序,却不能稳定对应实际概率,可以先测试 top-k,再决定是否允许它过滤文件。
- 把 TypeScript 检查、测试命令等能够明确验证的条件交给命令。模型评审集中处理命令无法直接判定的问题,并记录它的答案具体改变了哪一步决策。
- 调整裁判提示词时,把措辞、阈值和模型版本一起记录。先离线验证误拦情况,再让结果影响流程;复核本文匿名数据的命令是
node recompute.mjs,但这份实验尚未给出 token 节省结论。