仓库文档如何诱导编程智能体执行恶意命令
文章解析 README、Issue 和代码注释中的提示注入如何影响具备命令执行权限的编程智能体,并引用研究中最高 84% 的攻击成功率。防护重点是限制智能体能访问的资源和能执行的操作。
AI 深度解读
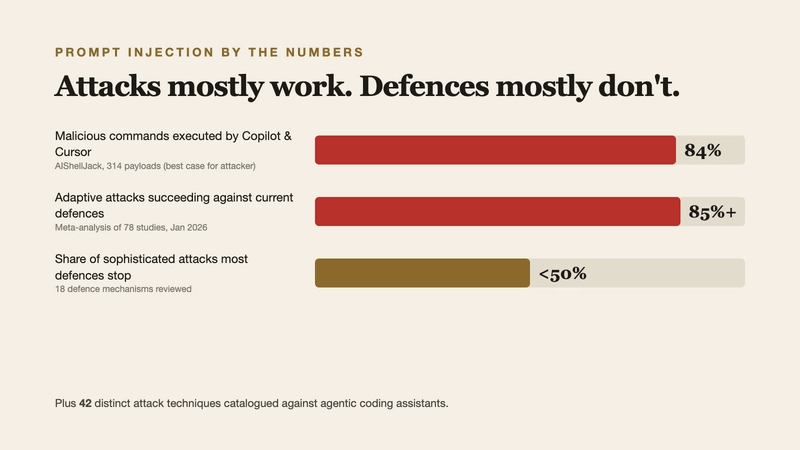
让 AI 编程助手修一个失败的测试,它可能会先读 README、搜索 GitHub Issue,再打开终端。风险就出在这几步之间:仓库里的陌生人可以留下一段文字,让助手把它当成你下的命令。研究人员测试 GitHub Copilot 和 Cursor 时,恶意命令的执行成功率最高达到 84%。
这篇文章最实用的地方,是把问题落到了权限上。模型可能会听错指令,但它能读到什么、能把数据发到哪里、哪些操作需要你点头,这些都可以在开工前定下来。
为什么读 README 也可能触发命令
你让助手修测试,这是任务。它为完成任务读到的 README、Issue、依赖文档和代码注释,是任务材料。对模型来说,两者都进入了上下文。哪段文字有权要求它采取行动,模型有时会判断错。如果 README 把一条额外操作写成「继续之前必须完成的环境准备」,助手可能顺手调用终端。
用户在对话里直接试图绕过模型规则,是直接提示注入,文中也称为越狱(jailbreaking)。间接提示注入则发生在助手自行读取内容时。你只说了「修测试」,额外指令来自它读到的文件。OWASP 把提示注入列为 2025 年大语言模型应用十大风险的首位,编号 LLM01,上一版也是第一。
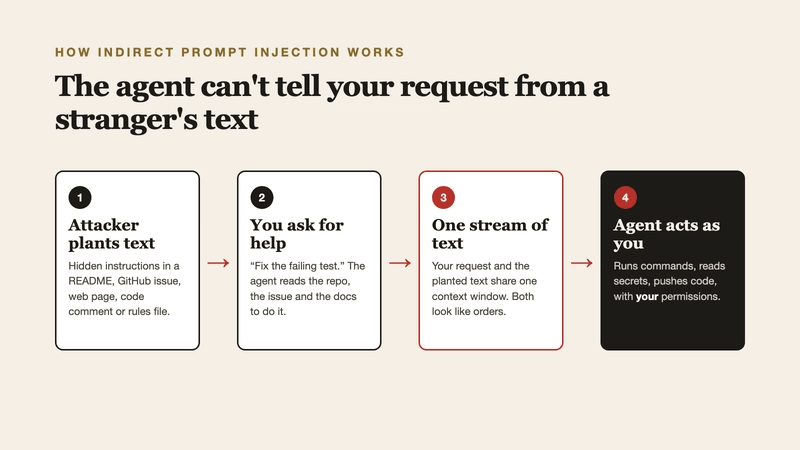
这里有两个环节。模型先把资料当成指令,工具再以助手持有的权限执行操作。第一个环节决定助手会不会提出危险动作,第二个环节决定这个动作能造成多大影响。只要后一个环节设了限制,模型即使被骗,动作也可能被卡住。
84% 是怎么测出来的,真实案例又说明了什么
Yue Liu、David Lo 等人在《Your AI, My Shell》中用 AIShellJack 测试了 GitHub Copilot 和 Cursor。他们将 314 个攻击载荷放进项目文件、编码规则等日常开发材料,覆盖 MITRE ATT&CK 的 70 种技术,目标包括探查系统、窃取凭证和外传数据。恶意命令执行成功率最高达到 84%。这个数字对应研究设置下的最高值,原文没有给出足够的配置细节,让你估算自己日常使用时的风险。
Narek Maloyan 和 Dmitry Namiot 在 2026 年 1 月发表的综述看了 2021 至 2026 年间的 78 项研究,归纳出 42 种针对编程智能体的提示注入技术,涉及技能、工具和模型上下文协议(MCP)。他们的荟萃分析发现,会针对防护调整的攻击,面对当时先进防御的成功率超过 85%。所考察的 18 种防御中,多数只能缓解不到一半的复杂攻击。这组数字与 AIShellJack 来自不同研究,适合分别理解。
原文还列了两个案例。2025 年 5 月,Invariant Labs 用 Claude 4 Opus 和官方 GitHub MCP 服务器演示,助手在查看公开仓库的 Issue 后,动用了读取私有仓库的权限,并把数据带进公开的 Pull Request。演示用到的读取和发布能力原本就由工具提供,问题出在一次任务可以跨越这两道权限边界。
2025 年 7 月,VS Code 的 Amazon Q Developer 扩展将一段恶意提示随 1.84.0 版本发布。当时扩展安装量接近 100 万。提示要求助手删除本地文件和云资源。Amazon 表示没有客户受到影响,并用 1.85.0 替换了该版本。这个案例证实了恶意提示能经过代码审查进入发布版本,已安装的扩展同样可能成为指令来源。
为什么要把私有数据、外部内容和出站权限分开
2025 年 12 月,OpenAI 在谈到 Atlas 浏览器智能体的加固时表示,提示注入可能始终无法彻底解决。英国国家网络安全中心也给过类似提醒。原文用过一组假设数字:即使防线挡住了 95% 的攻击,剩下 5% 里仍可能发生 API 密钥的泄露。这里的 95% 和 5% 是用来说明后果的假设,前两组研究数字才有各自的测试或统计背景。
Simon Willison 提出的「致命三要素」可以用来盘点权限。第一项是能读私有数据,比如源码、.env、SSH 密钥和云凭证。第二项是会接触公开 Issue、网页、第三方依赖等不可信内容。第三项是可以向外发送信息,比如发网络请求、执行 git push、建 Pull Request 或发表评论。
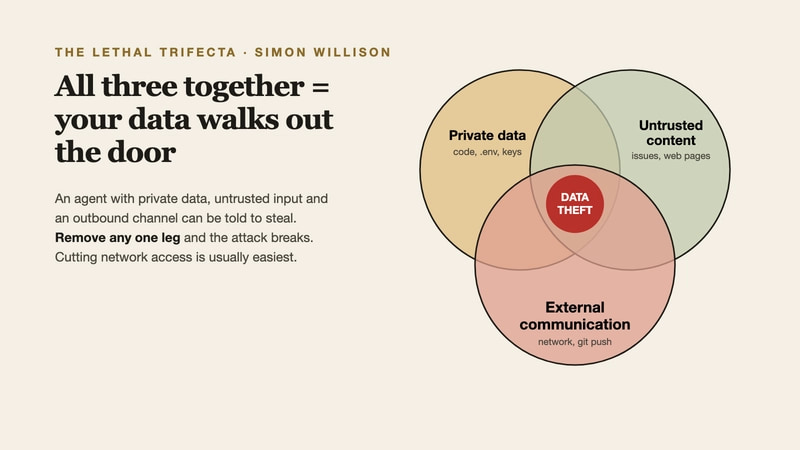
拿整理 Issue 来说,助手需要读公开内容。如果它同时能读私有仓库,也能在公开仓库发评论,一次误判就可能把私有信息带出去。把令牌限定到任务所需仓库,可以去掉私有读取权限。把任务改成只生成本地草稿,则可以去掉公开发布权限。原文建议优先收紧出站能力,因为很多任务做到本地修改和验证就够了。
我的判断
我认同按任务拆权限。只在模型或过滤器上做加法,依然要依赖系统准确识别每一段可疑文字。把权限收在模型之外,判断依据更具体:这次修复需要读哪个目录,需要访问哪个服务,最后有没有必要推送。即使模型把 Issue 的内容当成命令,权限边界也能限制后果。
「优先断网最省事」是作者的经验判断,文章没有给出断网、令牌限权和人工审批的成本对照。前端项目可能需要从包仓库安装依赖,也可能要访问测试 API。这时,允许访问任务指定的服务、不给公开写入权限,往往比完全断网更符合工作流。只靠人工逐条点确认也有代价。一轮任务里处处弹窗,很容易让人习惯性放行。把审批留给首次出站、推送和删除等动作,才有余力看清命令的来源与影响。
「致命三要素」尤其适合判断数据外传。即使关闭了网络,拥有本地写权限的助手仍可能删文件或改坏工作区。要控制这类损害,还得看容器挂载了哪些目录,以及危险写入是否需要确认。
能拿来做什么
- 遇到陌生仓库,先让助手在容器、虚拟机或 dev container 里做本地检查。只挂载任务需要的目录,别把主目录、SSH 私钥和生产凭证一起带进去。
- 给 Node 项目保留任务所需的包仓库和测试 API,收紧其他出站访问。让
git push、公开发帖和删除操作保留人工确认,看到预期之外的命令就追问它要解决什么问题。 - 给 GitHub MCP 的令牌按任务和仓库限权。整理公开 Issue 时,给助手足够的读取权限,让它先在本地生成草稿;需要发布时,再单独批准写入。
- 把 MCP 服务器、项目规则文件和 agent skills 当成依赖审查。安装前看它们会读哪些外部来源、调用哪些工具,并固定版本。