用 TypeScript 提前校验万相视频生成请求
文章将万相3.0文档中的媒体类型、组合和输出时长约束编码为本地 TypeScript 校验函数,在提交前返回错误与警告。实现无需网络调用,并附有可在 Node.js 运行的测试。
AI 深度解读
视频生成最烦的失败,是排队等了一轮,才发现素材组合不合法,或者模型根本没按剪辑意图执行。作者给 Wan 3.0 加了一道本地预检:用 TypeScript 在提交任务前检查素材、时长和提示词引用,把能提前发现的问题挡在队列外。
这个方案值得程序员借鉴的地方,是把 API 文档里的限制变成可执行规则。不过,作者只验证了本地测试,没有调用生成 API。它能检查请求是否踩了已知规则,不能保证视频一定符合预期。
同一个模型做多种任务,请求就得承担更多约束
按作者引用的 Alibaba Cloud Model Studio 指南,wan3.0-video 和 wan3.0-video-prime 都支持文生视频、首帧生成、首尾帧生成、多模态参考、视频编辑和视频延长。调用方不必为不同任务切换模型名,模型通过 input.media 中各项的 type,再结合 prompt 判断任务。
方便的另一面,是任务模式藏在请求内容里。字段类型正确,并不代表组合合法。
作者先区分两组素材:first_frame、last_frame 属于帧输入;reference_image、reference_video、reference_audio、file、link 属于参考输入,两组不能混用。
数量限制也要逐项检查:首帧和尾帧各最多 1 个,参考图片最多 10 张,参考视频和音频各最多 5 个,file、link 各最多 1 个,而且两者不能同时出现。每次请求的素材总数最多 20 个。
输出参数还有两类规则。resolution 的类型列出 480P、720P、1080P;ratio 列出 21:9、16:9、4:3、1:1、3:4、9:16 和 adaptive。指南建议帧输入或参考输入使用 ratio: "adaptive",而 21:9 只列在文生视频场景。这里要分清硬限制与建议,不能把推荐值全部变成拦截条件。
预检函数不发网络请求。素材的 bytes、seconds 都是可选字段,需要上传流程提供,例如通过 fs.stat 获取文件大小,通过 ffprobe 获取时长。缺少这些信息时,本地检查就存在盲区;它不会自动下载素材补齐信息。
时长不能只看输出,还要算上输入视频
作者编码了三项时长约束:参考视频总时长最多 15 秒,参考音频总时长最多 15 秒,指定输出时长时允许整数 2 到 30,或者特殊值 -1。
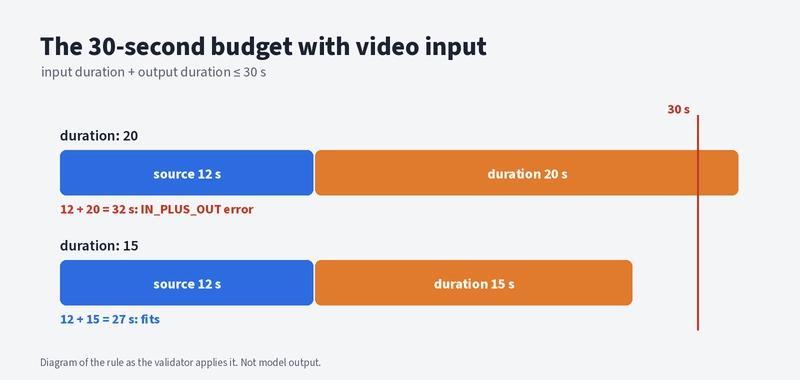
有视频输入时,还要检查输入视频与输出时长之和是否超过 30 秒。以下代码负责这部分校验:
if (sum(of("reference_video")) > 15) err("VID_TOTAL", "reference videos total more than 15 s");
if (sum(of("reference_audio")) > 15) err("AUD_TOTAL", "reference audio totals more than 15 s");

const d = p.duration;
if (d !== undefined && d !== -1 && (d < 2 || d > 30 || !Number.isInteger(d)))
  err("DURATION", `duration ${d}: use an integer 2-30 or -1`);

const vidIn = sum(of("reference_video"));
if (vidIn > 0 && d !== undefined && d !== -1 && vidIn + d > 30)
  err("IN_PLUS_OUT", `input video ${vidIn} s + output ${d} s exceeds 30 s`);
要看最后一个条件:只有已知输入视频时长,并且显式指定了非 -1 的 duration,才执行总预算检查。-1 绕过的是这里的本地算术判断,不能据此理解为服务端没有时长限制。
原文给出的例子是,12 秒输入视频加 20 秒输出会超额,加 15 秒则落在预算内。
延长视频还有一个容易误填的地方:指南建议将 duration 设为 -1,或设为源视频长度加上希望延长的长度。作者因此对「输出时长短于源视频」给出警告。
这里也留下一个需要核实的细节:文章同时使用「输入加输出不超过 30 秒」与「延长任务填写延长后的总长度」两条表述,但没有展示不同任务下的完整参数解释和真实 API 返回。做延长功能时,不能直接把 duration 当成「新增几秒」,也不能只凭这段代码确定所有任务的时长语义。
请求合法,也可能引用错素材、表达错任务
编辑和延长都使用 reference_video。模型如何区分它们?作者引用的指南要求 prompt 表达操作意图,例如编辑使用 edit video、remove、replace、change to,延长使用 extend、continue。
作者用正则检查这些词,编辑词还包括 edit、delete、add。存在参考视频,却没有匹配到编辑或延长词,就返回 NO_INTENT 警告:这个视频可能只会被当作参考素材。
意图检查适合提醒用户复核,不适合替用户决定任务。
原因很具体:add 出现了,不代表用户一定想编辑;中文提示词也可能表达得很清楚,却匹配不到英文正则。
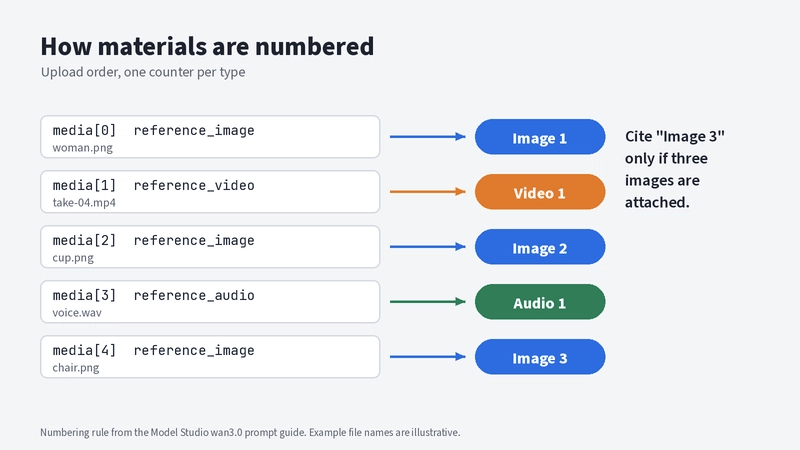
素材引用则更适合做确定性检查。Wan 3.0 按上传顺序编号,但图片、视频、音频分别计数。Image 1 和 Video 1 可以同时存在,不是整个素材数组共享一个序号。同类素材有两个及以上时,指南要求使用编号。
作者的引用检查匹配 image、img、video、audio 后面的数字,忽略大小写。如果只上传两张图片,却写了 Image 3,就返回 BAD_CITE。
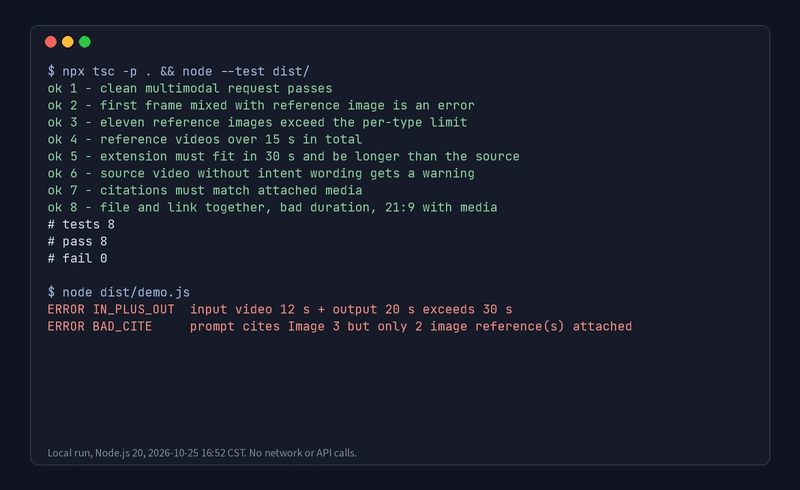
演示请求同时踩中两个问题:12 秒视频配 duration: 20,触发 IN_PLUS_OUT;只有两张图片却引用第三张,触发 BAD_CITE。这类错误无需等待生成结果就能发现。
接入异步流程时,预检放在创建任务之前。API 创建任务需带 X-DashScope-Async: enable,拿到任务 ID 后,再轮询 GET /api/v1/tasks/{task_id}。以下代码把错误拦截与警告记录接入提交过程:
const issues = preflight(prompt, media, params);
const errors = issues.filter(i => i.level === "error");
if (errors.length) throw new Error(errors.map(e => `${e.code}: ${e.msg}`).join("\n"));
for (const w of issues.filter(i => i.level === "warn")) log.warn({ code: w.code }, w.msg);

const task = await createTask({ model: "wan3.0-video", input: { prompt, media }, parameters: params });
log.info({ taskId: task.output.task_id, warnings: issues.length }, "queued");
关键是 errors.length 这一行,它决定请求能否进入队列。createTask 只是 HTTP 客户端的占位函数,并非原文给出的 SDK API。
我的判断
我认同把明确规则放在提交边界,也认同返回稳定错误码。MODE_MIX、BAD_CITE 不只是方便展示错误,还能帮助团队统计上游请求构造器最常犯什么错,从源头修改生成逻辑。
但原文的验证范围要讲清楚:作者使用 node:test,通过 tsc 编译,在 Node.js 20 上跑通了 8 个测试,没有调用 API。这证明列出的测试用例通过了,不能证明规则覆盖完整,也没有数据说明实际减少了多少失败任务。
相比只在前端表单限制输入,把预检放在 Node 提交入口能覆盖更多调用来源;相比完全依赖服务端报错,它能缩短一部分反馈路径。但地区可用性、账户配额、限流、链接是否可访问或需要登录,都超出本地函数能力。
日志示例也还差一步:警告先输出,之后才获得任务 ID,示例没有展示共享请求标识。要实现作者说的「按任务追查警告」,还得补上日志关联。
至于 Prime 的速度定位,原文引用了第三方 wan30.io 的宣传,没有给出两个模型的对照实测,不能据此替团队决定选型。
能拿来做什么
- 在 Node 创建视频任务的统一入口调用
preflight(),让error阻止提交,让warn保持可查看,并将稳定错误码映射成前端可理解的提示。 - 上传素材时保留文件大小、时长和同类素材顺序。用户增删或重排素材后,重新检查 prompt 中的编号,避免引用指向错误对象。
- 对编辑和延长提供明确的任务选项,再辅助构造 prompt;英文关键词检查保留为提醒,中文输入需要单独处理,不能直接照搬正则。
- 为提交请求、警告和任务 ID 建立关联,并在任务成功后及时保存 MP4。原文指出输出视频 URL 仅有效 24 小时,预检通过并不代表整个异步流程已经完成。