# 一篇不是标题党的CommonJS和ES6模块规范讲解|博客系列
> 本文详细对比讲解了CommonJS和ES6模块规范的原理、用法及区别,涵盖模块化发展历程、语法示例、优缺点分析,帮助前端开发者理解和选择合适的JavaScript模块方案。
- 原文:https://feinterview.poetries.top/docs/fe-blog-docs/blog-docs/javaScript2/22-%E4%B8%80%E7%AF%87%E4%B8%8D%E6%98%AF%E6%A0%87%E9%A2%98%E5%85%9A%E7%9A%84CommonJS%E5%92%8CES6%E6%A8%A1%E5%9D%97%E8%A7%84%E8%8C%83%E8%AE%B2%E8%A7%A3
- 来源:前端进阶之旅(feinterview.poetries.top)
- 更新:2025.10.25
- 可见范围:免费部分
---
### 原始写法
在没有`CommonJS`和`ES6`的时候,我们想要达到模块化的效果可能有这么三种:
#### 1. 一个函数就是一个模块
```html
```
> 缺点:污染了全局变量,无法保证不会与其它模块发生冲突,而且模块成员之间看不出直接关系。
#### 2. 一个对象就是一个模块
对象写法 为了解决上面的缺点,可以把模块写成一个对象,所有的模块成员都放到这个对象里面。
**index.html**
```html
```
> 缺点:会暴露所有模块成员,内部的状态可能被改写。
例如,我们如果只是想暴露出两个方法而不暴露出`_sum`,就做不到。
而此时,`_sum`可能被外部改写:
```javascript
module1._sum = 2;
```
#### 3. 立即执行函数为一个模块
```html
```
利用立即执行函数内的作用域已经闭包来实现模块功能,导出我们想要导出的成员。
此时外部代码就不能读取到`_sum`了:
```javascript
console.log(module1._sum) // undefined
```
### CommonJS规范
这里不做具体的介绍了,我只把一些重要的知识点以及混淆点例举出来。
主要是从这四个方面说:
- 暴露模块
- 引用模块
- 模块标识符
- CommonJS规范的特点
#### 1. 暴露(定义)模块
**正确的暴露方式:**
暴露模块有两种方式:
- `module.exports = {}`
- `exports.xxx = 'xxx'`
例如有一个`m1.js`文件:
第一种暴露方式:
```javascript
module.exports = {
name: 'lindaidai',
sex: 'boy'
}
```
第二种暴露方式:
```javascript
exports.name = 'lindaidai';
exports.sex = 'boy'
```
为什么可以有这两种写法呢?
我是这样理解的:`module`这个变量它代表的就是整个模块,也就是`m1.js`。而其实这个`module`变量是有一个属性`exports`的,它是一个叫做`exports`变量的引用,我们可以写一下伪代码:
```javascript
var exports = {};
var module = {
exports: exports
}
return module.exports
```
(当然这只是伪代码啊,实际你这么去用会发现没有效果)
最后导出的是`module.exports`,而不是`exports`。
**容易混淆的暴露方式:**
如果你在代码中试图`exports = { name: 'lindaidai' }`,你会发现在引入的地方根本获取不到`name`属性。
```javascript
// m1.js
exports = {
name: 'lindaidai'
}
```
```javascript
// test.js
const math = require('./m1.js')
console.log(m1); // {}
```
在控制台执行`node test.js`,发现打印出来的`m1`是一个空的对象。
我是这样理解的:整个模块的导出是靠`module.exports`的,如果你重新对整个`exports`对象赋值的话,它和`module.exports`就不是同一个对象了,因为它们指向的引用地址都不同:
```javascript
module.exports -> {} // 指向一个空的对象
exports -> { name: 'lindaidai' } // 指向的是另一个对象
```
所以你对`exports = {}`做任何操作都影响不到`module.exports`。
让我们来看几个正确和错误的示例吧:
```javascript
// m1.js
// 1. 正确
module.exports = {
name: 'lindaidai',
sex: 'boy'
}
// 2. 正确
exports.name = 'lindaidai';
exports.sex = 'boy'
// 3. 正确
module.exports.name = 'lindaidai';
module.exports.sex = 'boy'
// 4. 无效
exports = {
name: 'lindaidai',
sex: 'boy'
}
```
可以看到
- `exports.name = xxx`是`module.exports.name = xxx`的缩写。
- `exports = {}`确不是`module.exports = {}`的缩写。
#### 2. 引用(引入)模块
对于模块的引用使用全局方法`require()`就可以了。
注意⚠️这个全局方法是`node`中的方法哈,它不是`window`下面的,所以如果你没做任何处理想直接在`html`里用肯定就是不行的了:
**index.html**:
```html
```
例如上面👆这样你打开页面控制台肯定就报错了:
```
Uncaught ReferenceError: require is not defined
at index.html:11
```
而如果你是在另一个`js`文件中引用(例如`test.js`),并在终端执行`node test.js`是可以用的:
**test.js**:
```javascript
var m1 = require('./m1.js')
console.log(m1);
```
那是因为你的电脑上全局安装了`Node.js`,所以可以这样玩。
**所以我们可以发现`require()`它是`Node.js`中的一个全局方法,并不是CommonJS独有的,CommonJS只是众多规范中的其中一种。**
这种规范允许我们:
- 使用`module.exports = {}`或者`exports.name = xxx`导出模块
- 使用`const m1 = require('./m1')`引入模块
注意⚠️:
另外还有一点比较重要,那就是`require()`的参数甚至能允许你是一个表达式。
也就是说你可以把它设置为一个变量:
**test.js**:
```javascript
var m1Url = './m1.js';
var m1 = require(m1Url);
// 甚至做一些字符串拼接:
var m1 = require('./m' + '1.js');
```
但是需要注意咯,这个传参可以为表达式并不是`require`特有的。因为`JS`语言是传值调用,函数或者方法在调用的时候参数会被先计算出来,因此在我们使用`require`方法并传入表达式的时候,会先计算出表达式的值再传递给`require`。(感谢掘友[骑自行车](https://juejin.im/user/5a91606ef265da4e7e10d527)的指出)
#### 3. 模块标识符(标识)
模块标识符其实就是你在引入模块时调用`require()`函数的参数。
你会看到我们经常会有这样的用法:
```javascript
// 直接导入
const path = require('path');
// 相对路径
const m1 = require('./m1.js');
// 直接导入
const lodash = require('lodash');
```
这其实是因为我们引入的模块会有不同的分类,像`path`这种它是`Node.js`就自带的模块,`m1`是路径模块,`lodash`是我们使用`npm i lodash`下载到`node_modules`里的模块。
分为以下三种:
- 核心模块(`Node.js`自带的模块)
- 路径模块(相对或绝对定位开始的模块)
- 自定义模块(`node_modules`里的模块)
三种模块的查找方式:
- 核心模块,直接跳过路径分析和文件定位
- 路径模块,直接得出相对路径就好了
- 自定义模块,先在当前目录的`node_modules`里找这个模块,如果没有,它会往上一级目录查找,查找上一级的`node_modules`,依次往上,直到根目录下都没有, 就抛出错误。
**自定义模块的查找过程:**
这个过程其实也叫做**路径分析**。
现在我把刚刚的`test.js`来改一下:
```javascript
// var m1 = require('./m1.js');
// console.log(m1);
console.log(module.paths)
```
然后在终端执行:
```
node test.js
```
会发现输出了下面的一个数组:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
[
'/Users/lindaidai/codes/test/CommonJS和ES6/commonJS/node_modules',
'/Users/lindaidai/codes/test/CommonJS和ES6/node_modules',
'/Users/lindaidai/codes/test/node_modules',
'/Users/lindaidai/codes/node_modules',
'/Users/lindaidai/node_modules',
'/Users/node_modules',
'/node_modules'
]
```
这里所说的查找,是指查找你现在用的这个模块,我现在用的是`test.js`,你可能看不出什么效果。现在让我们来模拟一个我们使用`npm i`安装的一个自定义模块功能。
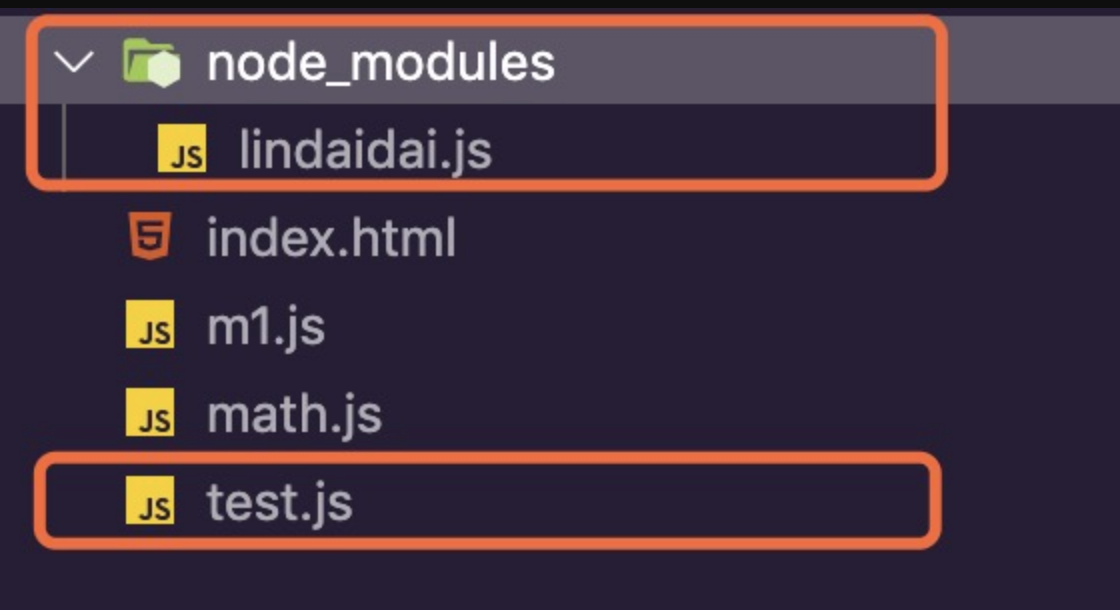
首先,我在根目录下新建了一个名叫`node_modules`的文件夹,并在其中新建了一个名叫`lindaidai.js`的文件,用来模拟一个`npm`安装的依赖。
目录结构:
稍微编写一下`lindaidai.js`:
```javascript
module.exports = {
print: function () {
console.log('lindaidai')
}
}
console.log('lindaidai模块:', module.paths)
```
然后在`test.js`中引入这个`lindaidai`模块:
```javascript
// var m1 = require('./m1.js');
// console.log(m1);
// console.log(module.paths)
var lindaidai = require('lindaidai');
lindaidai.print();
```
现在执行`node test.js`,会发现输出了:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
lindaidai模块: [
'/Users/lindaidai/codes/test/CommonJS和ES6/commonJS/node_modules',
'/Users/lindaidai/codes/test/CommonJS和ES6/node_modules',
'/Users/lindaidai/codes/test/node_modules',
'/Users/lindaidai/codes/node_modules',
'/Users/lindaidai/node_modules',
'/Users/node_modules',
'/node_modules'
]
lindaidai
```
所以现在你可以知道,平常我们使用这种依赖的时候,它是怎样的一个查找顺序了吧,它其实就是按照自定义模块的顺序来进行查找。
**文件定位:**
上面👆已经介绍完了路径分析,但是还有一个问题,就是我们导入的模块它的后缀(扩展名)是可以省略的啊,那`Node`怎么知道我们是导入了一个`js`还是一个`json`呢?这其实就涉及到了文件定位。
在NodeJS中, 省略了扩展名的文件, 会依次补充上.js, .node, .json来尝试, 如果传入的是一个目录, 那么NodeJS会把它当成一个包来看待, 会采用以下方式确定文件名
第一步, 找出目录下的package.json, 用JSON.parse()解析出main字段
第二步, 如果main字段指定的文件还是省略了扩展, 那么会依次补充.js, .node, .json尝试.
第三部, 如果main字段制定的文件不存在, 或者根本就不存在package.json, 那么会默认加载这个目录下的index.js, index.node, index.json文件.
以上就是文件定位的过程, 再搭配上路径分析的过程, 进行排列组合, 这得有多少种可能呀. 所以说, 自定义模块的引入, 是最费性能的.
(总结来源:https://zhuanlan.zhihu.com/p/27644026)
#### 4. CommonJS规范的特点
我先把`CommonJS`规范的一些特点列举出来吧,然后我们再一点一点的去看例子。
- 所有代码都运行在模块作用域,不会污染全局作用域;
- 模块是同步加载的,即只有加载完成,才能执行后面的操作;
- 模块在首次执行后就会缓存,再次加载只返回缓存结果,如果想要再次执行,可清除缓存;
- CommonJS输出是值的拷贝(即,`require`返回的值是被输出的值的拷贝,模块内部的变化也不会影响这个值)。
(总结来源:https://juejin.im/post/5db95e3a6fb9a020704bcd8d)
第一点还是好理解的,咱模块的一个重要的功能不就是这个吗。
第二点**同步加载**,这个写个案例我们来验证一下。
**同步加载案例**:
*m1.js*:
```javascript
console.log('我是m1模块')
module.exports = {
name: 'lindaidai',
sex: 'boy'
}
```
*test.js*
```javascript
var m1 = require('./m1');
console.log('我是test模块');
```
可以看到,`test`模块依赖于`m1`,且是先下载的`m1`模块,所以如果我执行`node test.js`,会有以下的执行结果:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
我是m1模块
我是test模块
```
这也就验证了`CommonJS`中,模块是同步加载的,即只有加载完成,才能执行后面的操作。
第三点**模块首次执行后会缓存**,我们也可以写个案例来验证一下。
**模块首次执行后会缓存案例:**
*m1.js*:
```javascript
var name = 'lindaidai';
var sex = 'boy';
exports.name = name;
exports.sex = sex;
```
*test.js*:
```javascript
var m1 = require('./m1');
m1.sex = 'girl';
console.log(m1);
var m2 = require('./m1');
console.log(m2);
```
`test`同样依赖于`m1`,但是我会在其中导入两次`m1`,第一次导入的时候修改了`m1.sex`的值,第二次的时候命名为`m2`,但是结果`m1`和`m2`竟然是相等的:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
{ name: 'lindaidai', sex: 'girl' }
{ name: 'lindaidai', sex: 'girl' }
```
也就是说模块在首次执行后就会缓存,再次加载只返回缓存结果,这里我是用了改变`m1.sex`的值来证明它确实是取了缓存结果。
那么就有小伙伴会疑惑了,其实你这样写也并不能证明啊,因为你改变了`m1.sex`也可能是影响原本`m1`模块里的`sex`属性呀,这样的话第二次`m2`拿到的肯定就是被改变的值了。
唔...我正想证明来着呢。因为`CommonJS`的第四个特点就可以很好的解决你这个疑问。
第四点**CommonJS输出是值的拷贝**,也就是说你用`require()`引入了模块,但是你在最新的模块中怎样去改变,也不会影响你已经`require()`的模块。来看个案例。
**CommonJS输出是值的拷贝案例**:
*m1.js*:
```javascript
var name = 'lindaidai';
var sex = 'boy';
var advantage = ['handsome']
setTimeout(function () {
sex = 'girl';
advantage.push('cute');
}, 500)
exports.name = name;
exports.sex = sex;
exports.advantage = advantage;
```
*test.js*:
```javascript
var m1 = require('./m1');
setTimeout(function () {
console.log('read count after 1000ms in commonjs is', m1.sex)
console.log('read count after 1000ms in commonjs is', m1.advantage)
}, 1000)
```
执行`node test.js`之后的执行结果是:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
read count after 1000ms in commonjs is boy
read count after 1000ms in commonjs is [ 'handsome', 'cute' ]
```
也就是说,在开始`var m1 = require('./m1')`的时候,`m1`已经被引入进来了,但是过了`500ms`后我改变了原本`m1`里的一些属性,`sex`这种基本数据类型是不会被改变的,但是`advantage`这种引用类型共用的还是同一个内存地址。(这种复制的关系让我想到了之前学原型链继承的时候,它那里也是,会影响`Father.prototype`上的引用类型)
如果这里你是这样写的话:
*m1.js*:
```javascript
var name = 'lindaidai';
var sex = 'boy';
var advantage = ['handsome']
setTimeout(function () {
sex = 'girl';
// advantage.push('cute');
advantage = ['cute'];
}, 500)
exports.name = name;
exports.sex = sex;
exports.advantage = advantage;
```
现在的执行结果肯定就是:
```javascript
LinDaiDaideMBP:commonJS lindaidai$ node test.js
read count after 1000ms in commonjs is boy
read count after 1000ms in commonjs is [ 'handsome' ]
```
因为相当于对`m1`的`advantage`重新赋值了。
当然,或者如果你的`m1.js`中返回的值是会有一个函数的话,在`test.js`也能拿到变化之后的值了,比如这里的一个例子:
```javascript
var counter = 3;
function incCounter() {
counter++;
}
module.exports = {
get counter() {
return counter
},
incCounter: incCounter,
};
```
因为在这里实际就形成了一个闭包,而`counter`属性就是一个取值器函数。
好滴,这基本就是`CommonJS`的特点了,总结就不写了,在开头已经说过了,不过对于最后一点:**CommonJS输出是值的拷贝**,这个对于引用类型的变量来说还是会有一点歧义的,比如上面的`advantage`那个例子,大家知道就行了。
### AMD规范
#### 1. 产生原因
上面介绍的`CommonJS`规范看起来挺好用的啊,为什么又还要有其它的规范呢?比如`AMD、CMD`,那它们和`CommonJS`又有什么渊源呢?
我们知道,模块化这种概念不仅仅适用于服务器端,客户端同样也适用。
而`CommonJS`规范就不太适合用在客户端(浏览器)环境了,比如上面的那个例子,也就是:
**test.js**:
```javascript
const m1 = require('./m1.js')
console.log(m1);
// 与m1模块无关的一些代码
function other () {}
other();
```
这段代码放在浏览器环境中,它会如何运行呢?
- 首先加载`m1.js`
- 等`m1.js`加载完毕之后才执行后面的内容
这点其实在**CommonJS规范的特点**中已经提到过了。
后面的内容要等待`m1`加载完才会执行,如果`m1`加载的很慢呢?那不就照成了卡顿,这对于客户端来说肯定是不友好的。像这种要等待上一个加载完才执行后面内容的情况我们可以叫做`"同步加载"`,很显然,这里我们更希望的是`other()`的执行不需要等`m1`加载完才执行,也就是我们希望`m1`它是`"异步加载"`的,这也就是`AMD`。
在介绍`AMD`之前让我们看看`CommonJS`规范对服务器端和浏览器的不同,它有助于让你理解为什么说`CommonJS`不太适合于客户端:
- 服务器端所有的模块都存放在本地硬盘中,可以同步加载完成,等待时间就是硬盘的读取时间。
- 浏览器,所有的模块都放在服务器端,等待时间取决于网速的快慢,可能要等很长时间,浏览器处于”假死”状态。
#### 2. 定义并暴露模块
有了上面这层背景,我们就知道了,`AMD`它的产生很大一部分原因就是为了能让我们采用**异步的方式加载模块**。
所以现在来让我们看看它的介绍吧。
`AMD`是`Asynchronous Module Definition`的缩写,也就是`"异步模块定义"`。(前面的`A`就很好记了,它让我不自觉的就想到`async`这个定义异步函数的修饰符)
> 它采用异步方式加载模块,模块的加载不影响它后面语句的运行。所有依赖这个模块的语句,都定义在一个回调函数中,等到加载完成之后,这个回调函数才会运行。
此时就需要另一个重要的方法来定义我们的模块:`define()`。
它其实是会有三个参数:
```javascript
define(id?, dependencies?, factory)
```
---
> 以上是免费部分。完整内容需要「前端进阶之旅」会员,原文:https://feinterview.poetries.top/docs/fe-blog-docs/blog-docs/javaScript2/22-%E4%B8%80%E7%AF%87%E4%B8%8D%E6%98%AF%E6%A0%87%E9%A2%98%E5%85%9A%E7%9A%84CommonJS%E5%92%8CES6%E6%A8%A1%E5%9D%97%E8%A7%84%E8%8C%83%E8%AE%B2%E8%A7%A3