
# 二叉树
# 二叉树概述
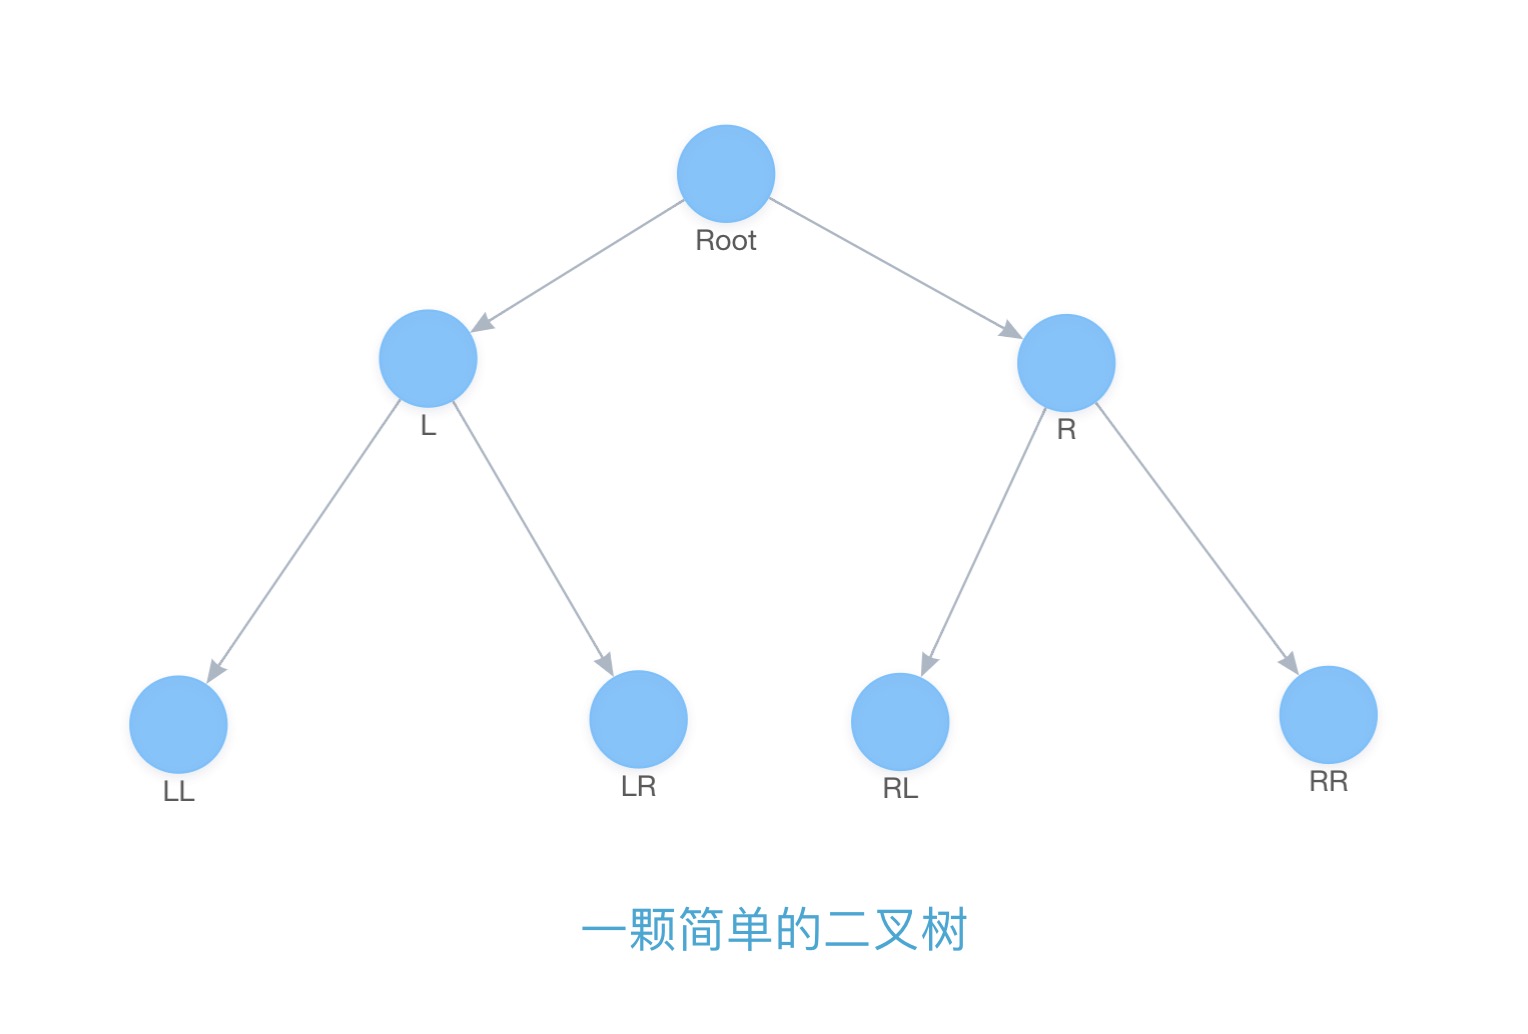
二叉树是非常基础并且是一种非常重要的数据结构, 正和它的名字一样, 二叉树的每个节点最多有两个子树.
我们可以先来看下面的这颗二叉树, 为了方便,我这里将left用L表示, right用R表示:
# 二叉树与JS
上面的二叉树可以用我们JavaScript的对象来进行表示, 相信大家很容易就能看懂:
var tree = {
    value: "Root",
    left: {
        value: 'L',
        left: {
            value: 'LL'
        },
        right: {
            value: 'LR'
        }
    },
    right: {
        value: 'R',
        left: {
            value: 'RL'
        },
        right: {
            value: 'RR'
        }
    }
}
当前节点的值存放到value这个属性中, 左(右)子树存放到left(right) 中.
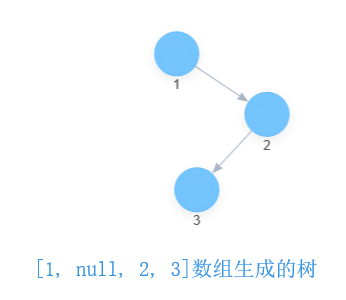
这样我们很容易就能写出数组[1, null, 2, 3]的二叉树:
# 定义一个二叉树的节点类
通过上面的JS对象,让我们来写一个可以生成单个节点的类:
// 定义一个二叉树的节点类
class Node {
  constructor(value, left = null, right = null) {
    this.value = value;
    this.left = left;
    this.right = right;
  }
}
现在让我们用这个类来生成一颗简单的二叉树吧:
const tree = new Node(
  'Root',
  new Node(
    'L',
    new Node('LL'),
    new Node('LR')
  ),
  new Node(
    'R',
    new Node('RL'),
    new Node('RR')
  )
)
console.log(tree)
(这棵树在后面都会用到,大家知道后面案例的tree表示的是它就行了)
# 二叉搜索树
二叉搜索树(也叫二叉查找树)的特点:
- 左子树上所有节点的值必定全部小于根节点的值
- 右子树上所有节点的值必定全部大于根节点的值
- 左子树和右子树也分别为二叉搜索树
例如二叉搜索树:
const root = new Node(
  2,
  new Node(1),
  new Node(
    5,
    new Node(4),
    new Node(6)
  )
);
[左子树][根][右子树]
// 对应为:
[1] [2] [4 5 6]
非二叉搜索树:
const root = new Node(
	2,
	new Node(3),
	new Node(4)
)
[左子树][根][右子树]
// 对应为:
[3] [2] [4]
# 二叉树的遍历
# 四种遍历的概念
二叉树的遍历大范围主要分为两种:
- 深度遍历
- 广度遍历
而在深度遍历中,又分为前序、中序、后序三种遍历方法.
四种遍历的主要思想:
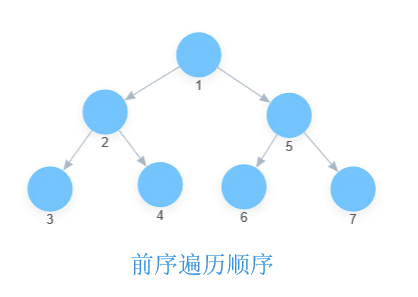
- 前序遍历:访问根–>遍历左子树–>遍历右子树;
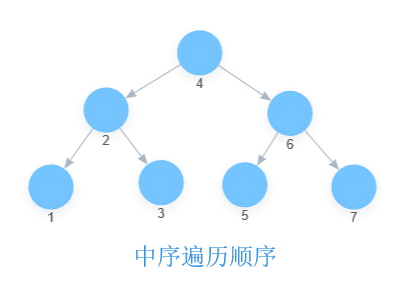
- 中序遍历:遍历左子树–>访问根–>遍历右子树;
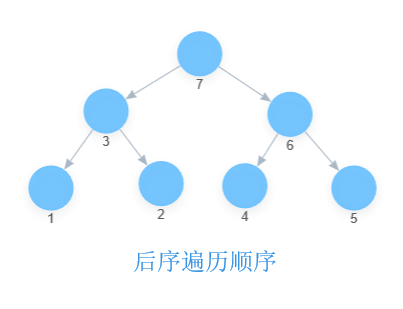
- 后序遍历:遍历左子树–>遍历右子树–>访问根;
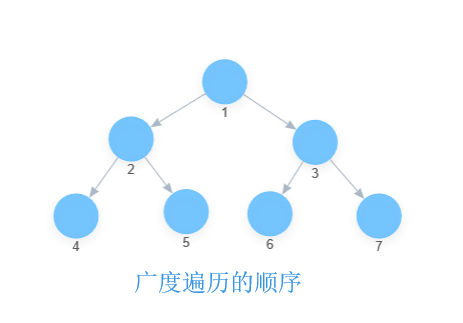
- 广度遍历:按照层次一层层遍历;
例如一颗简单的二叉树,让我们用图形的方式来分别表示一下遍历顺序:
(数字表示的就是遍历的顺序)
| 前序 | 中序 |
|---|---|
 |
 |
| 后序 | 广度 |
 |
 |
# 前序遍历
遍历顺序为:
首先我们来实现一下前序遍历, 你可能很容易的就想到了可以用递归的方式来实现:
递归遍历
function preOrderRec(tree) { // 前序遍历函数
    let list = [] // 定义一个数组来放最终遍历结果
    let preOrderRecFn = function(node) { // 定义一个函数来实现递归
        if (node) { // 若是该节点存在
            list.push(node.value) // 当前节点的值推进数组
            preOrderRecFn(node.left) // 先遍历左子树
            preOrderRecFn(node.right) // 然后遍历右子树
        }
    }
    preOrderRecFn(tree)
    return list
}
可以看到,上面preOrderRec函数接受一个tree对象, 然后判断每个节点是否存在, 若是存在则先将当前节点的值推进数组, 然后再遍历左子树, 之后再遍历右子树.
非递归遍历
function preOrderUnRec(tree) {
    let list = [] // 定义一个数组来放最终遍历结果
    let preOrderUnRecFn = function(node) { // 定义一个函数来遍历节点
        if (node) { // 若是该节点存在
            let stack = [node] // 将当前节点推入栈
            while (stack.length !== 0) { // 终止条件: stack数组为空
                node = stack.pop() // 取出栈中的最后一个节点
                list.push(node.value) // 当前节点的值推进数组
                if (node.right) stack.push(node.right) // 先将右子树节点推入栈
                if (node.left) stack.push(node.left) // 再将左子树节点推入栈
            }
        }
    }
    preOrderUnRecFn(tree)
    return list
}
如果你看上面的代码觉得有点生涩的话, 可以先看第一遍循环:
非递归遍历第一次循环
function preOrderUnRec(tree) {
    let list = [] // 定义一个数组来放最终遍历结果
    let preOrderUnRecFn = function(node) { // 定义一个函数来遍历节点
        // 第一次输入的 node 为 {value: 'Root', left: {}, right: {}}
        if (node) {
            // 将当前节点推入栈
            // 此时 stack: [ {value: 'Root', left: {}, right: {}} ]
            let stack = [node]
            while (stack.length !== 0) { // 终止条件: stack数组为空
                // 取出栈中的最后一个节点, 此时:
                // node: {value: 'Root', left: {}, right: {}}
                // stack: []
                node = stack.pop()
                // 当前节点的值推进数组
                // list: ['Root']
                list.push(node.value)
                // 先将右子树节点推入栈
                // stack: [ {value: 'R', left: {}, right: {}} ]
                if (node.right) stack.push(node.right)
                // 再将左子树节点推入栈
                // stack: [ {value: 'R', left: {}, right: {}}, {value: 'L', left: {}, right: {}} ]
                if (node.left) stack.push(node.left)
            }
        }
    }
    preOrderUnRecFn(tree)
    return list
}
经过第一次循环之后, 我们发现list中已经存放了我们想要的Root字符串.
stack数组也变成了两项:
stack: [ {value: 'R', left: {}, right: {}}, {value: 'L', left: {}, right: {}} ]
此时进入while循环的判断stack.length !== 0, 显然这个判断是为true, 所以程序又会继续往下走:
非递归遍历第二次循环
while (stack.length !== 0) { // 终止条件: stack数组为空
    // 第二次循环
    // 此时 stack: [ {value: 'R', left: {}, right: {}}, {value: 'L', left: {}, right: {}} ]
    // node: {value: 'L', left: {}, right: {}}
    // stack: [ {value: 'R', left: {}, right: {}} ]
    node = stack.pop()
    // 当前节点的值推进数组
    // list: ['Root', 'L']
    list.push(node.value)
    // 先将右子树节点推入栈
    // stack: [ {value: 'R', left: {}, right: {}}, {value: 'LR'} ]
    if (node.right) stack.push(node.right)
    // 再将左子树节点推入栈
    // stack: [ {value: 'R', left: {}, right: {}}, {value: 'LR'}, {value: 'LL'} ]
    if (node.left) stack.push(node.left)
}
看到这里你应该就懂了.
# 中序遍历
遍历顺序为:
遍历之后:


