Serverless 入门实战 从运行原理到四个落地案例
一个只有几十人在用的内部工具,每天的调用量撑死几百次,却要为它单独挂一台常驻云主机,还得管系统升级、证书续期、磁盘日志清理。机器九成时间在空转,运维那摊活儿一样都没少。这类场景就是 Serverless 最典型的入口,把常驻服务拆成按需执行的函数,没请求的时候不占资源,自然也就没有账单和值班。
这篇是我把 Serverless 从概念到落地重新梳理一遍的笔记。前半部分讲清它到底解决什么问题、函数是怎么被拉起来的、冷启动为什么能压到百毫秒,后半部分是四个可以照着敲的完整案例,代码和部署命令都在。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- Serverless 的两种定义,以及 FaaS 和 BaaS 各自负责哪一块
- 写第一个函数,触发器、事件对象和日志分别该怎么处理
- 函数的调用链路、冷启动与热启动、以及 FaaS 的三层结构
- 用一份 YAML 描述整个应用,把开发调试部署的效率提上去
- 阿里云函数计算、腾讯云函数、Vercel 三种上手方式的差别
- 四个完整案例,登录注册、Restful 内容管理 API、音视频处理、React 服务端渲染
先说一句时效性的话。这篇写于 2021 年 4 月,各家云厂商的控制台界面、免费额度和计费单价这几年都调整过好几轮。文里的截图和数字保留当时的样子,方便你对照着理解流程,真要动手掏钱之前请以官方文档和控制台的最新页面为准。
# 一、什么是 Serverless
理清 Serverless 要解决的问题其实很简单,把这个词从字面上拆开看就够了。Server 指服务端,它划定了 Serverless 解决问题的边界;less 可以理解成较少关心,这是它的目的。两个词组合在一起,就是「较少关心服务端」。
注意是较少关心,不是没有服务器。你的代码最后还是跑在实实在在的机器上,只不过这台机器的采购、扩容、打补丁、装监控,全都从你的工作清单里挪走了。这一点很关键,很多人第一次听到 Serverless 会以为是某种新的运行时黑科技,其实它更像是一次责任边界的重新划分。
顺着这个思路,Serverless 在业界一般有两种口径:
- 第一种:
狭义 Serverless(最常见)=Serverless computing 架构=FaaS 架构=Trigger(事件驱动)+ FaaS(函数即服务)+ BaaS(后端即服务,持久化或第三方服务)=FaaS + BaaS - 第二种:广义
Serverless=服务端免运维=具备 Serverless 特性的云服务
狭义那条是我们平时写代码时打交道最多的,也是这篇的主线。广义那条更像一种标准,比如对象存储 OSS、CDN、云数据库这些你从来不用管机器的产品,都算具备 Serverless 特性的云服务。BaaS 里的那些第三方服务,说的就是它们。
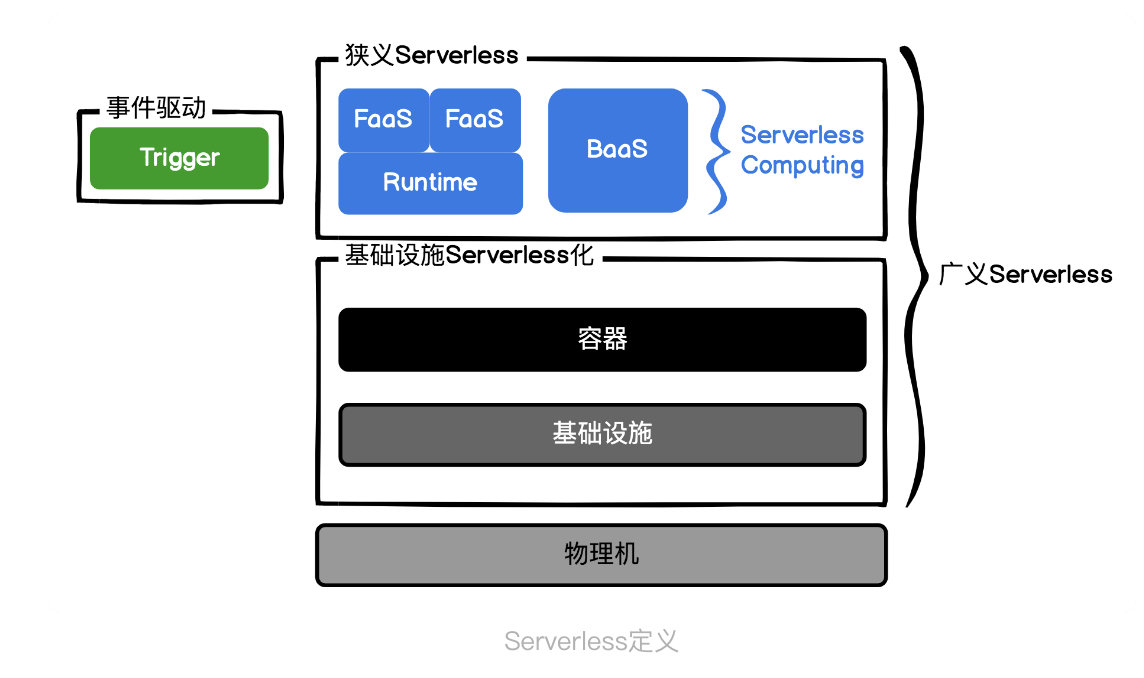
这张图把两条口径的关系画在了一起。你可以这么记:FaaS 负责放你的业务代码,BaaS 负责放你的状态,Trigger 负责把外面的事件送进来。三者凑齐,才是一个能跑的 Serverless 应用,光有 FaaS 是写不出完整业务的。
那什么时候值得上 Serverless?我自己的判断标准很粗暴,看两件事:请求量是不是明显有波峰波谷,以及这段逻辑能不能做成无状态。定时任务、图片视频处理、Webhook 回调、活动页接口、小程序后端,这几类基本都能对上。反过来,需要长连接、需要常驻内存缓存、单次执行动辄几十分钟的活儿,Serverless 目前并不划算。
# 二、编写你的第一个 Serverless 应用
各家 FaaS 平台的产品名不一样,AWS 叫 Lambda,阿里云叫函数计算,腾讯云叫云函数,但你真正要写的东西高度一致。挑平台之前先看下面这张横向对比,能省掉不少纠结。
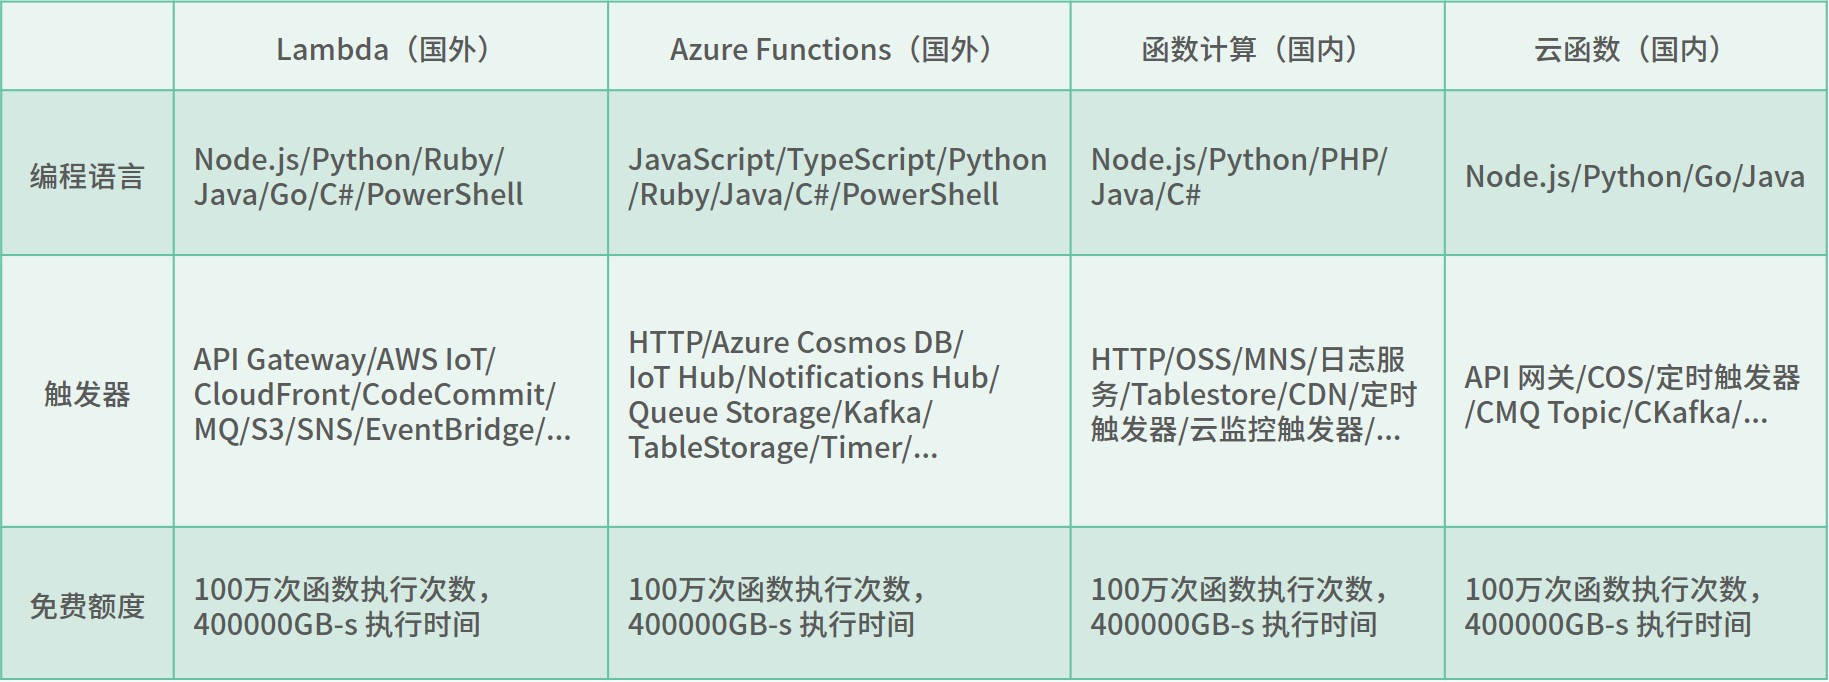
图里的信息可以归成三条:
- FaaS 平台都支持 Node.js、Python 、Java 等编程语言;
- FaaS 平台都支持 HTTP 和定时触发器(这两个触发器最常用)。此外各厂商的 FaaS 支持与自己云产品相关的触发器,函数计算支持阿里云表格存储等触发器;
- FaaS 的计费都差不多,且每个月都提供一定的免费额度。其中 GB-s 是指函数每秒消耗的内存大小,比如1G-s 的含义就是函数以 1G 内存执行 1 秒钟。超出免费额度后,费用基本都是 0.0133元/万次,0.00003167元/GB-s。所以,用 FaaS 整体费用非常便宜,对一个小应用来说,几乎是免费的。
上面这两个单价是 2021 年当时的公开报价,写在这里是想让你对量级有个感觉,一万次调用一分多钱。这几年各家的计费模型陆续加了预留实例、按 CPU 计量等新维度,免费额度也调整过,实际花多少钱请以你所在区域的官方定价页为准。不过量级结论到现在还成立,个人项目和内部工具跑在 FaaS 上,基本就是免费。
选语言这块有个小建议。如果你的函数是给 HTTP 请求兜底的,也就是用户会在页面上等结果,优先选 Node.js,冷启动最快,后面讲生命周期时会说原因。如果是离线跑批、数据处理,语言就随意了。
以阿里云函数为例
// logic.js
exports.sayHello = function (name) {
  return `Hello, ${name}!`;
}
这个文件里只有纯业务逻辑,一个 name 进去,一句问候出来,跟运行在哪儿完全无关。它在本地能用 Jest 直接测,也能原样搬到 Express 应用里。
// index.js
const logic = require('./logic');
exports.handler = (request, response, context) => {
  // 从 request 中获取
  const { name } = request.queries;

  // 处理业务逻辑
  const message = logic.sayHello(name)

  // 设置 HTTP 响应
  response.setStatusCode(200);
  response.setHeader("Content-Type", "application/json");
  response.send(JSON.stringify({ message }));
}
这段是入口函数,它只干三件事:从 request 里取参数、调 logic.js 拿结果、把结果按 HTTP 的格式写回 response。业务逻辑一行都没有。
把业务逻辑拆分到入口函数之外,这是写 FaaS 函数的第一条纪律。理由很实在,handler 的签名是平台定的,阿里云是 (request, response, context),AWS 是 (event, context, callback),你把逻辑写在里面,就等于把业务代码焊死在了某一家云上。逻辑在外面,换平台时只需要重写那十几行胶水代码。
# 触发器及事件对象
函数自己不会跑,得有东西把它叫醒,这个东西就是触发器。触发器决定了三件事:谁能叫醒这个函数、事件长什么样、以及函数的返回值最后去哪儿。下面三种是日常用得最多的。
- HTTP 触发器
在众多 FaaS 平台中,函数计算直接提供了 HTTP 触发器,HTTP 触发器通过发送 HTTP 请求来触发函数执行,一般都会支持 POST、GET、PUT、HEAD 等方法。所以你可以用 HTTP 触发器来构建 Restful 接口或 Web 系统。
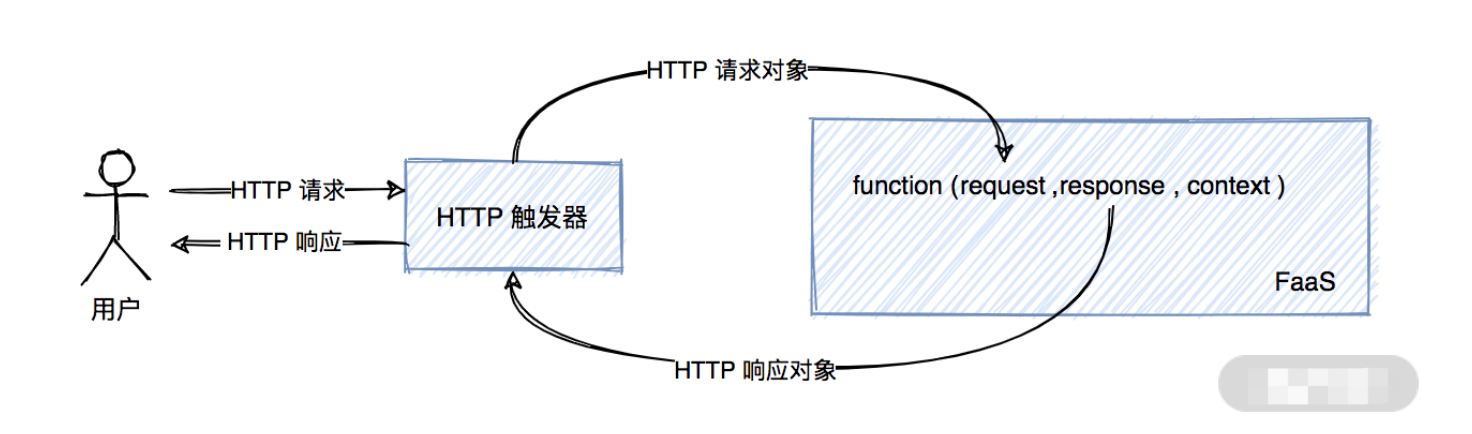
HTTP 触发器会根据 HTTP 请求和请求参数生成事件,然后以参数形式传递给函数。那么 HTTP 触发器的入口函数参数中的 request 和 response 参数具体有哪些属性呢?
其实 request 和 response 参数跟 Express.js 框架里那两个对象很像,request.queries 取查询串,request.headers 取请求头,response.setStatusCode()、response.setHeader()、response.send() 写响应。所以上手几乎没有学习成本,后面案例里用 @webserverless/fc-express 直接把它们转成 Express 的 req 和 res,也正是因为这层相似。
- API 网关触发器
API 网关触发器与 HTTP 触发器类似,它主要用于构建 Web 系统。区别在于中间多了一层 API 网关来接收 HTTP 请求,然后再产生事件,将事件传递给 FaaS。FaaS 将函数执行完毕后将函数返回值传递给 API 网关,API 网关再将返回值包装为 HTTP 响应返回给用户。
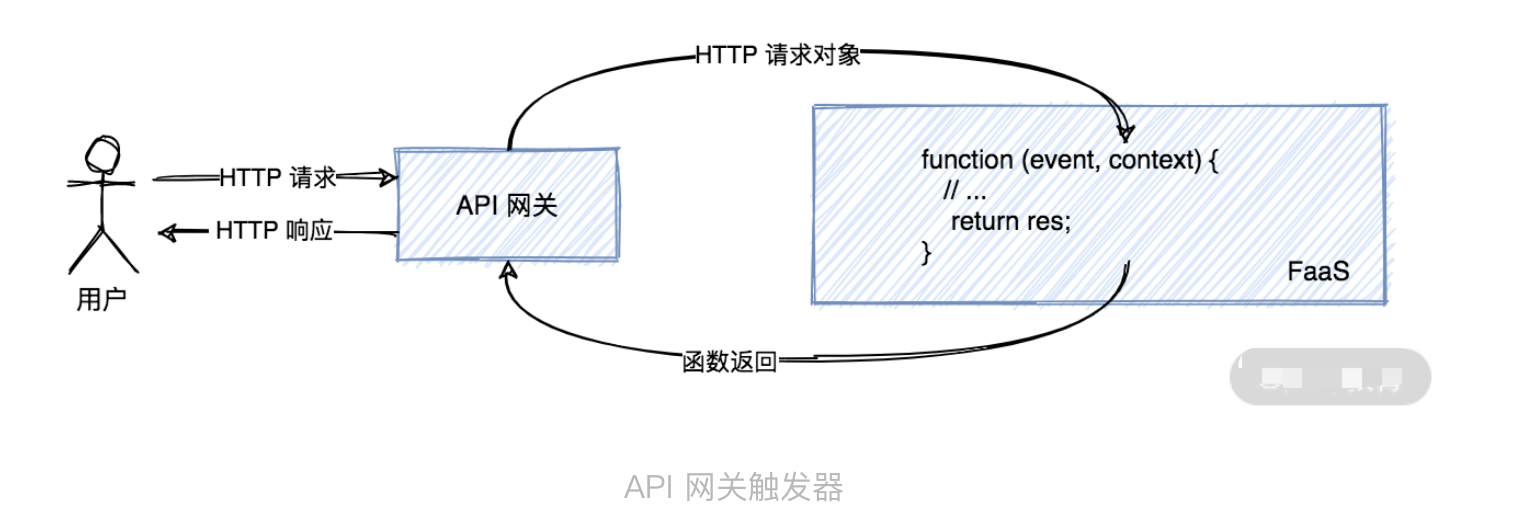
多这一层网关值不值?看你要不要那些附加能力。参数校验、路径参数、IP 黑白名单、限流、鉴权、自定义域名和证书,这些网关都能做,函数里就不用写了。后面第六节那个内容管理系统就是走 API 网关的,因为它有 /article/detail/[article_id] 这种带路径参数的路由,用 HTTP 触发器自己解析会很啰嗦。反过来,如果只是一个孤零零的回调接口,HTTP 触发器更省事,也少一份网关的钱。
- 定时触发器
定时触发器就是定时执行函数,它经常用来做一些周期任务,比如每天定时查询天气并给自己发送通知、每小时定时处理分析日志等等。
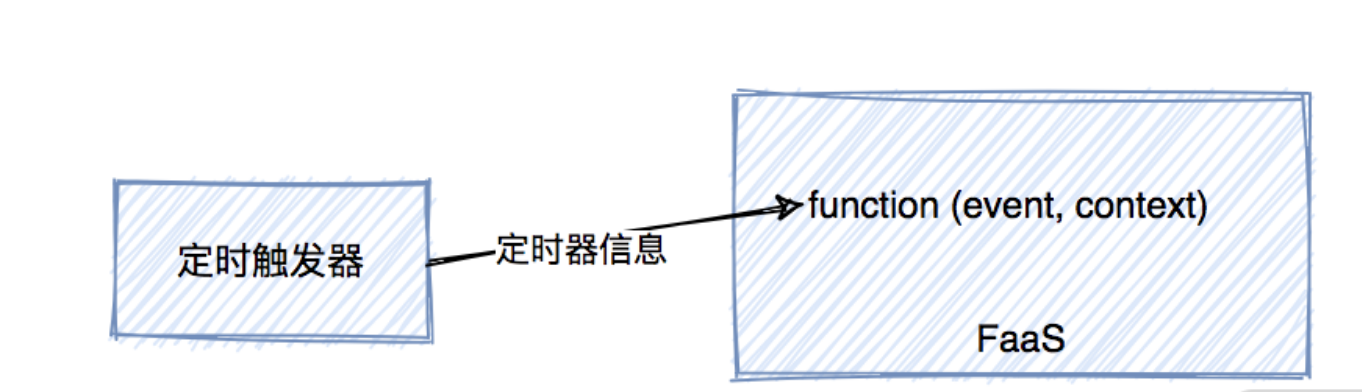
定时触发器是我认为最容易被低估的一个。以前想跑个定时任务,要么开台机器写 crontab,要么在业务服务里塞个 node-schedule,前者浪费机器,后者一旦服务多实例部署就会重复执行。定时触发器这两个坑都没有,配置一个 Cron 表达式就完事,平台保证同一时刻只触发一次。
这里有个坑要注意,定时触发器是异步调用的,函数抛错了外面没人接。所以定时函数里一定要自己 try/catch 并把失败结果记下来,否则任务默默失败你根本不知道。
# 日志输出
无论你用什么编程语言开发 Serverless 应用,都要在合适的时候输出合适的日志信息,方便调试应用、排查问题。在 Serverless 中,日志输出和传统应用的日志输出没有太大区别,只是日志的存储和查询方式变了。
变在哪儿?传统应用你可以 ssh 上机器 tail -f 看日志文件,函数没有这个机会。函数实例执行完就可能被销毁,本地磁盘上的东西跟着一起没,所以日志必须实时打到外部的日志服务里。这也是为什么很多人第一次写函数会觉得「怎么调试这么难」,其实是习惯还停在有机器可登的年代。
以函数计算为例,如果你在控制台创建函数,则函数计算默认会使用日志服务来为你存储日志。在「日志查询」标签下可以查看函数调用日志。日志服务是一个日志采集、分析产品,所以如果你要实现业务监控,则可以将日志输出到日志服务,然后在日志服务中对日志进行分析,并设置报警项。
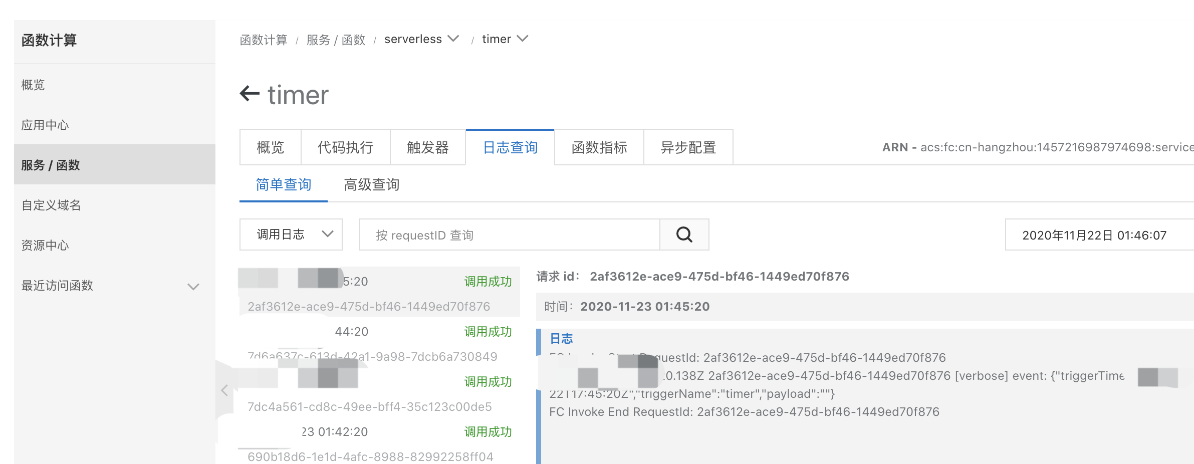
实践中我习惯在每个函数入口打一行结构化日志,把 requestId、入参摘要、耗时都记上。函数是分散的,出问题时没有一条完整的调用栈可看,requestId 就是你把几个函数的日志串起来的唯一线索。
# 三、Serverless 应用是怎么运行的
Serverless 应用是由一个个 FaaS 函数组成的,每一次运行其实就是单个或多个函数的运行。所以搞懂 Serverless 的运行原理,等于搞懂函数的运行原理。
这一节可能是全篇最值得花时间的部分。你不理解函数怎么被拉起来,就没法解释线上那些「为什么第一次请求特别慢」「为什么全局变量有时候还在有时候没了」的怪现象。
FaaS 是怎么运行的
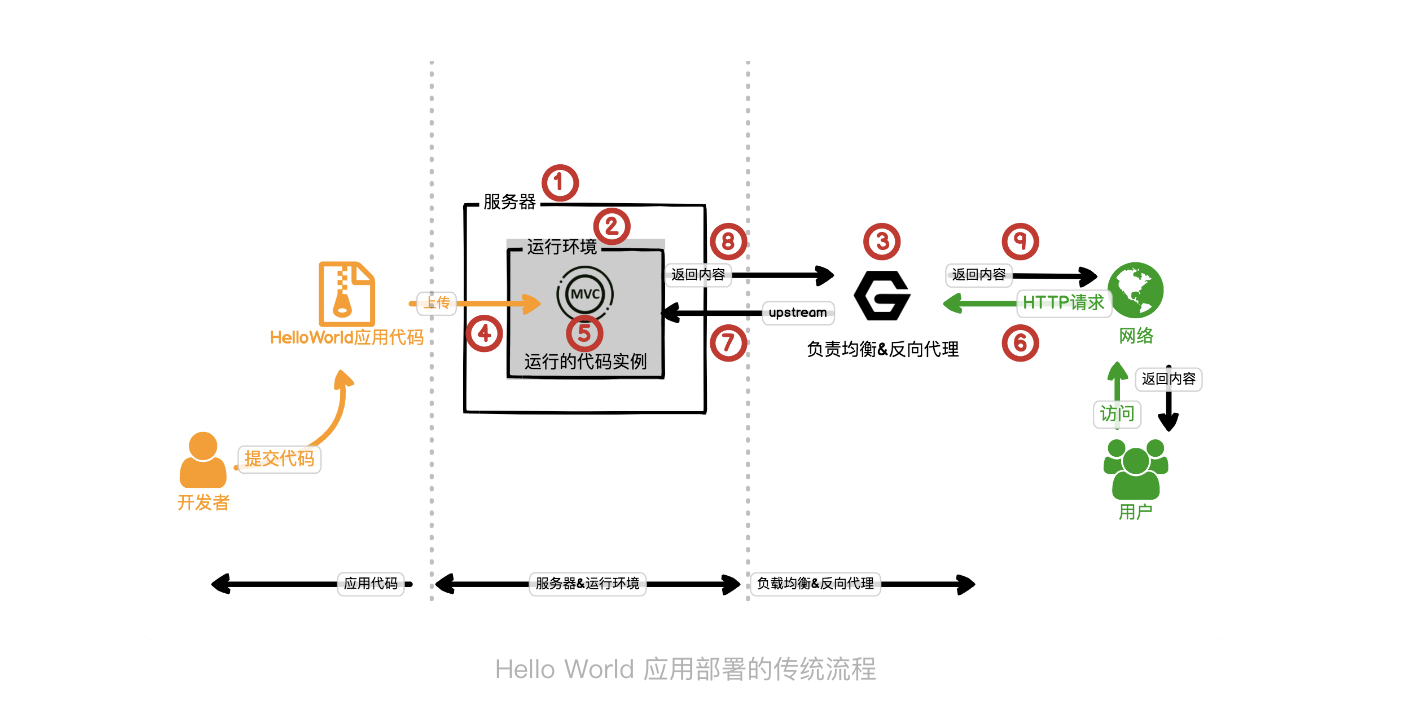
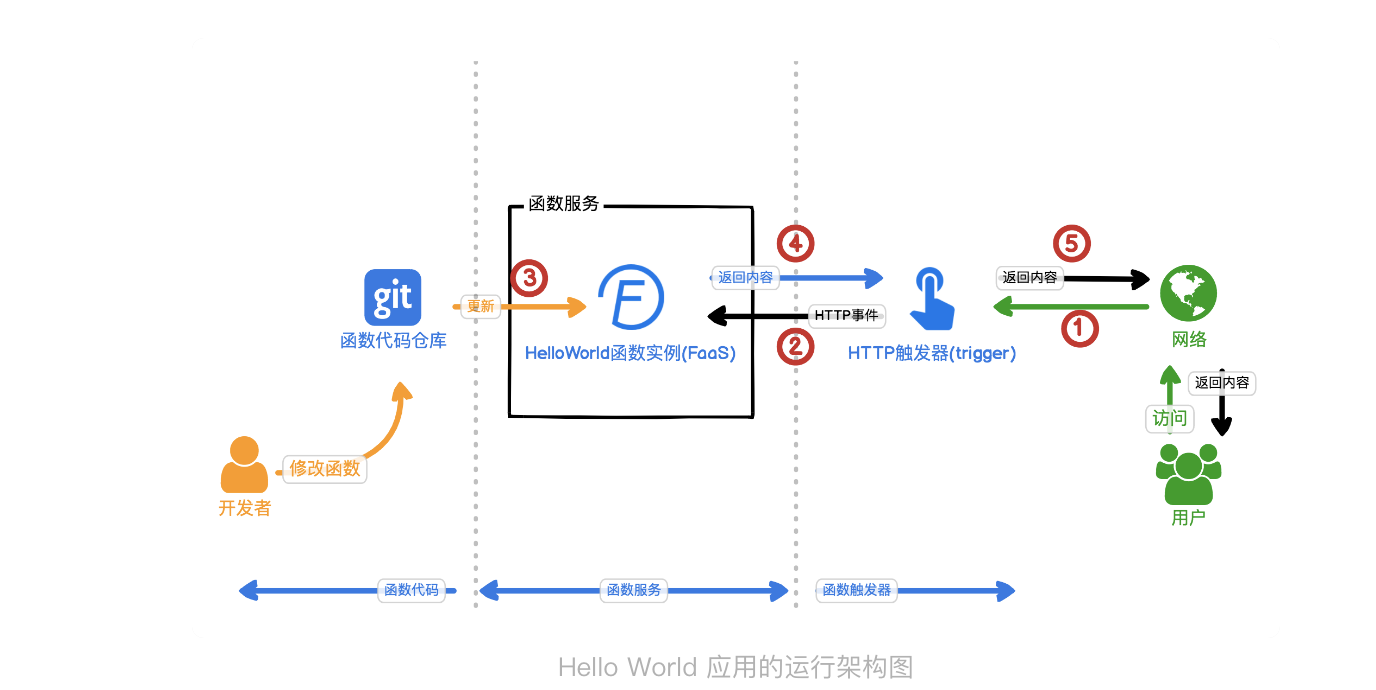
上面两张图放在一起看更清楚。第一张是 FaaS 内部的调度流程,第二张是把 FaaS 和传统服务端的职责摆在一起对照,你会发现负载均衡、进程守护、扩缩容这些原来要你操心的环节,在 FaaS 这一侧全被平台吃掉了。
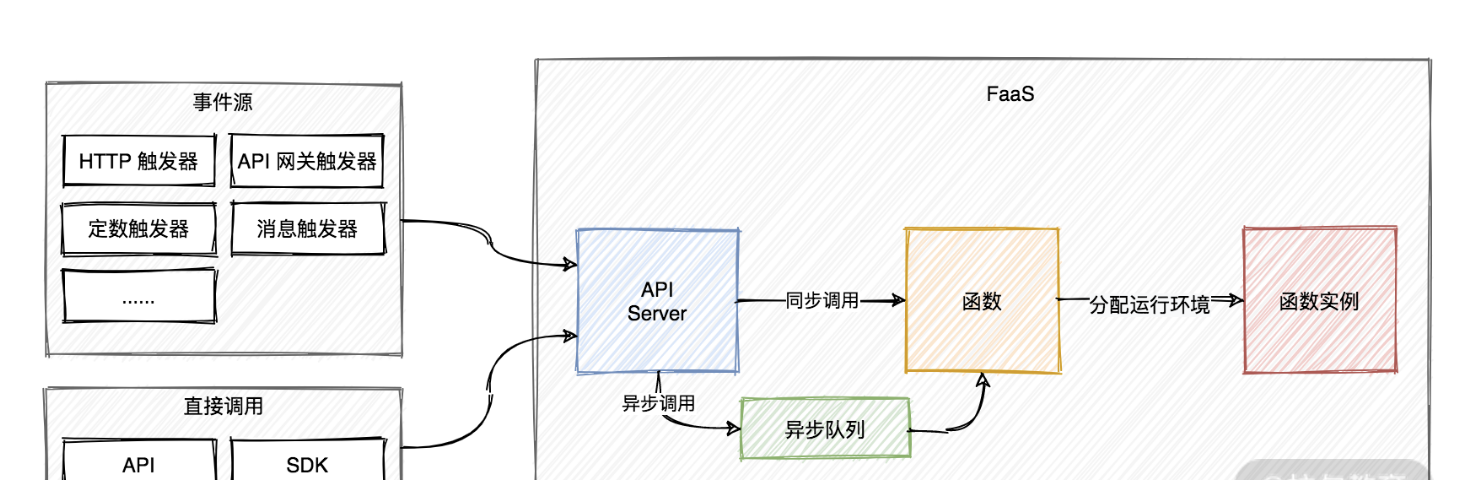
# 函数调用链路:事件驱动函数执行
对于 FaaS 函数来说,一方面可以通过事件来触发执行,另一方面也可以直接调用 API 来执行。FaaS 平台都提供了执行函数的 API。