
上一个项目前端后端一把抓,SQL 天天写;这个项目接口全由后端提供,我半年没碰过数据库,前两天要自己查一段线上数据,group by 和 having 谁在前谁在后都得想半天。翻出以前的学习笔记,发现里面攒了不少当时踩过的东西,干脆重新整理一遍,把每条命令背后的取舍也补上。
这篇不是 SQL 教程的替代品,它更像一份查得动的复习清单。每一节我都尽量说清楚「什么时候会用到」和「用错了会怎样」,而不是只列语法。顺带一提,我之前也整理过一篇 MongoDB 的复习笔记,关系型和文档型对照着看,对「什么数据该放哪儿」这件事会更有感觉。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- mac 上装 MySQL、起服务、登录,以及连接参数各是什么意思
- 库、表、列三级操作的完整命令,以及改表时容易翻车的地方
- 列类型怎么选,整型宽度、char 和 varchar、日期时间类型的坑
- 增删改查四类语句,重点讲 select 的执行顺序
- 连接查询、子查询、union,配一整套基于商品表的实战练习
- 索引、触发器、视图、存储引擎这些进阶概念
- 常用函数速查,数学、字符串、日期、加密、格式化各一组
- MySQL 8 相对 5.x 改了什么,哪些写法已经不能用了
先说一句时效性。这些笔记是在 MySQL 5.x 时代写的,MySQL 8 之后有几处默认行为变了,比较明显的是默认字符集从 latin1 换成了 utf8mb4、默认认证插件换成了 caching_sha2_password、还有一批老函数被移除。我会在对应章节单独起一小段标出来,原文的写法保留不动,因为你维护老库的时候还是会碰到。具体某个特性落在哪个小版本上,以官方文档为准。
# 一、环境搭建
mac 上装 MySQL,用 Homebrew 最省事,它会把二进制、配置文件、启动脚本一起装好。
brew install mysql
装完之后终端会打印一大段提示,包括数据目录位置、怎么启动、以及初始的 root 账号说明。这段值得看一眼再往下走,尤其是它告诉你安全初始化命令怎么跑。
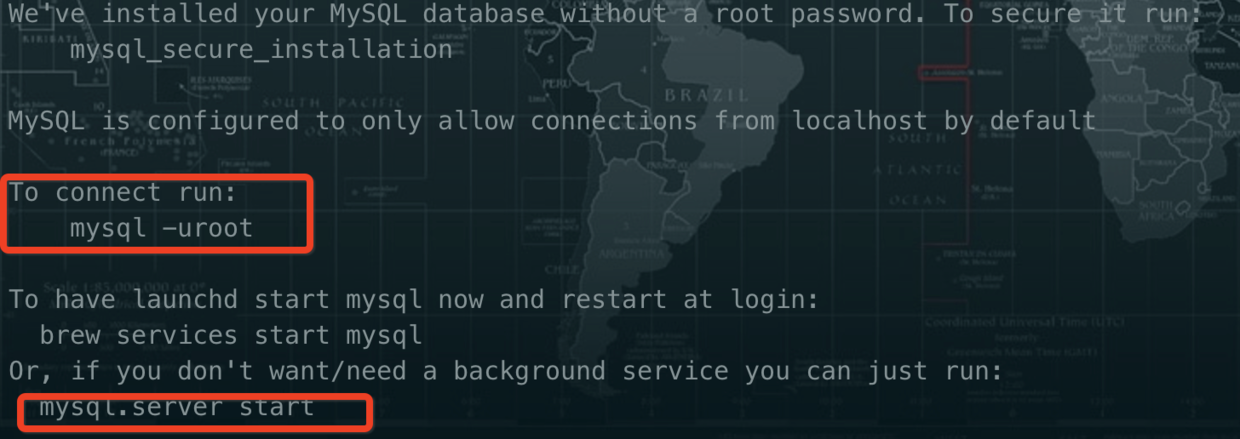
启动服务用下面这条。它是 Homebrew 提供的包装脚本,比直接调 mysqld 省心。
# 启动

mysql.server start
服务起来之后就能连了。刚装好的 root 一般没密码,直接 -uroot 进去。
#登录
mysql -uroot
这里有个坑要注意。MySQL 8 的默认认证插件换成了 caching_sha2_password,一些老的客户端库连不上,报的错通常是 Authentication plugin 'caching_sha2_password' cannot be loaded。遇到这个不是密码错了,是客户端不支持新插件,解决办法要么升级客户端,要么把这个账号的认证方式改回 mysql_native_password。我第一次撞上的时候在密码上纠结了半天,完全找错了方向。
# 二、基础知识
这一章是所有操作的地基,库、表、列三层,每一层都有增删改查。命令看着琐碎,但结构其实很整齐。
# 1、数据库的连接
# 例子
mysql -u root -p 123456 -h 127.0.0.1
三个参数的含义分别是:
-u用户名-p密码-hhost主机地址,不写默认连本机
-p 这个参数有讲究。上面这种把密码直接跟在后面的写法能跑,但它会把密码留在 shell 历史记录里,而且 -p 和密码之间不能有空格,有空格 MySQL 会把它当成数据库名。生产环境更推荐只写 -p 不带值,回车之后它会提示你输入,输入的内容不回显也不进历史。
# 2、库级知识
每条命令后面都要加分号,这是 MySQL 客户端判断语句结束的标志。少了分号它会一直等着,光标停在 -> 那里,很多人第一次会以为是卡住了。
- 显示数据库:
show databases; - 选择数据库:
use dbname; - 创建数据库:
create database dbname charset utf8; - 删除数据库:
drop database dbname;
建库时指定字符集这个习惯很重要,不指定就跟随服务器默认值,几年后迁移的时候各个库字符集不一致会很难受。这里再补一句 MySQL 8 的变化,原文写的 charset utf8 在 MySQL 里其实是 utf8mb3,一个字符最多三字节,存不下 emoji 和部分生僻字。MySQL 8 把默认字符集改成了 utf8mb4,四字节,才是真正完整的 UTF-8。新库建议显式写 charset utf8mb4,老库里那些 utf8 就是历史遗留。
drop database 这条要格外小心,它没有确认没有回收站,敲下回车整个库就没了。我的习惯是在生产库上永远不手敲这条命令。
# 3、表级操作
# 3.1 显示库下面的表
show tables;
# 3.2 查看表的结构
desc tableName;
desc 输出的是列名、类型、能否为空、键类型、默认值这些,是最快速的一览。
# 3.3 查看表的创建过程:
show create table tableName;
这条比 desc 更有用,它把完整的建表语句还原出来,包括引擎、字符集、索引定义、自增起始值。要在另一个库里复制一张同样结构的表,直接把它的输出粘过去就行,不用一列列比对。
# 3.4 创建表
建表语句的骨架长这样,方括号里的部分是可选项。
create table tbName (
列名称1 列类型 [列参数] [not null default ],
列名称N 列类型 [列参数] [not null default ]
) engine myisam/innodb charset utf8/gbk
例子
create table user (
    id    int         auto_increment,
    name  varchar(20) not null default '',
    age   tinyint unsigned not null default 0,
    index id (id)
)engine=innodb charset=utf8;

# 注:innodb是表引擎,也可以是myisam或其他,但最常用的是myisam和innodb,
# charset 常用的有utf8,gbk;
这个例子里有几处值得拆开看。auto_increment 让 id 自增,但用它有个前提,这一列必须建索引,所以下面跟了一句 index id (id)。not null default '' 这个组合是个好习惯,理由放到 6.5 节讲默认值时展开。
关于引擎的选择,原文说「最常用的是 myisam 和 innodb」,这是 2019 年之前的语境。现在基本不用纠结了,新表一律 InnoDB,因为它支持事务、行级锁和外键,MyISAM 只有在纯读、能接受表锁的老场景里才见得到。MySQL 从 5.5.5 开始默认引擎就是 InnoDB 了。
# 3.5 修改表
改表这块命令多,但可以按「加什么、改什么、删什么」归成三组来记。真正要小心的是,alter table 在大表上是重操作,MySQL 5.6 之后虽然支持了在线 DDL,但仍然可能锁表或者产生大量 IO。线上大表改结构,我的做法是先在从库或者影子表上试一遍,估算耗时。
3.5.1 修改表之增加列
alter table tbName add 列名称1 列类型 [列参数] [not null default ]

#(add之后的旧列名之后的语法和创建表时的列声明一样)
3.5.2 修改表之修改列
alter table tbName change 旧列名  新列名  列类型 [列参数] [not null default ]

# (注:旧列名之后的语法和创建表时的列声明一样)
change 和 modify 的区别经常有人搞混。change 能改列名,所以要写两个列名;modify 只改类型和属性,写一个列名就够。两者都必须把完整的列定义重写一遍,漏写 not null 或者 default,那些属性就没了。这个我踩过,改个字段长度顺手把默认值弄丢了,上线之后插入报错。
3.5.3 修改表之减少列
alter table tbName drop 列名称;
3.5.4 修改表之增加主键
alter table tbName add primary key(主键所在列名);
比如 alter table goods add primary key(id) 就是把主键建在 id 列上。要注意这一列里不能有重复值也不能有 NULL,有一条不满足这条语句就失败。
3.5.5 修改表之删除主键
alter table tbName drop primary key;
这里有个陷阱。如果这一列还带着 auto_increment,直接删主键会报错,因为自增列必须有索引。得先 modify 把自增属性去掉,再删主键。
3.5.6 修改表之增加索引
alter table tbName add [unique|fulltext] index 索引名(列名);
3.5.7 修改表之删除索引
alter table tbName drop index 索引名;
索引名建议有规律,比如 idx_列名、唯一索引用 uk_列名。表一大、索引一多,光看名字就能知道它是干什么的,省得每次都去 show index。
3.5.8 清空表的数据
truncate tableName;
truncate 和 delete from 表名 效果看着一样,内部完全是两回事。truncate 是 DDL,相当于把表删了重建,速度极快、自增计数归零、不写 binlog 的行记录,也没法回滚。delete 是 DML,一行行删,能带 where、能回滚、自增计数不重置。要清空一张大表用 truncate,要删部分数据用 delete,别搞反了。
# 4、列类型讲解
选列类型这件事,前期多想五分钟,后期能省几个小时。核心原则就一条,在能装下的前提下选最小的那个,因为每一行都要占这么多空间,索引也跟着变大。
# 4.1 列类型
tinyint (0~255/-128~127)smallint (0~65535/-32768~32767)mediumintintbigint
参数解释
整型有两个常见的附加参数,unsigned 表示无符号也就是不能为负,zerofill 表示用 0 填充到指定宽度,括号里的 M 就是那个宽度。
- 举例:
tinyint unsigned;
tinyint(6) zerofill;
这里有个特别容易误解的点。int(11) 里的 11 不是「能存 11 位数字」,它只是显示宽度,跟存储范围一点关系都没有。int 永远占 4 字节,写 int(1) 照样能存 20 亿。这个宽度只有配合 zerofill 时才有实际效果。补一句演进,MySQL 8 已经把整型的显示宽度标记为废弃了,新版本里写了会有告警,这个设计确实误导了太多人。
# 4.2 数值型
- 浮点型:
floatdouble - 格式:
float(M,D)unsigned\zerofill;


