
用户传一个 2GB 的培训视频,点了上传,进度条走到 80% 网络抖了一下,整个请求超时,回来得从 0 重传。运维那边还会顺带告诉你 Nginx 的 client_max_body_size 被打爆了,网关日志里全是 413。这类问题单靠调大超时时间和请求体上限是解决不了的,得换一套上传姿势。
这篇把分片上传、断点续传、秒传这三件事从原理到代码完整走一遍,前端切片和 Hash 计算、Node 端接收与合并、Web Worker 和抽样 Hash 优化、并发控制,最后附一份上线前的 checklist 和面试速答版,照着做能直接落到项目里。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- 分片上传、断点续传、秒传三者的关系和各自的代价
- 一张图看清浏览器和 Node 服务端之间的四次交互
File/Blob.slice/FileReader/FormData这几个 API 在链路里各干什么- 前端切片与
spark-md5计算文件指纹的完整实现,以及内存上的坑 - Node 端接收分片、校验状态、流式合并的实现,含几个容易写错的地方
- Web Worker、抽样 Hash、并发控制、失败重试四种优化手段
- 上线前的安全与稳定性 checklist
- 面试里怎么用两分钟把这套方案讲清楚
# 一、三个概念和它们之间的关系
先把名词捋清楚,这三件事是层层递进的,不是三个平行选项。
分片上传是地基。把一个大文件按固定大小切成若干个 Chunk,每个 Chunk 单独发一个 HTTP 请求,服务端收齐之后再拼回完整文件。
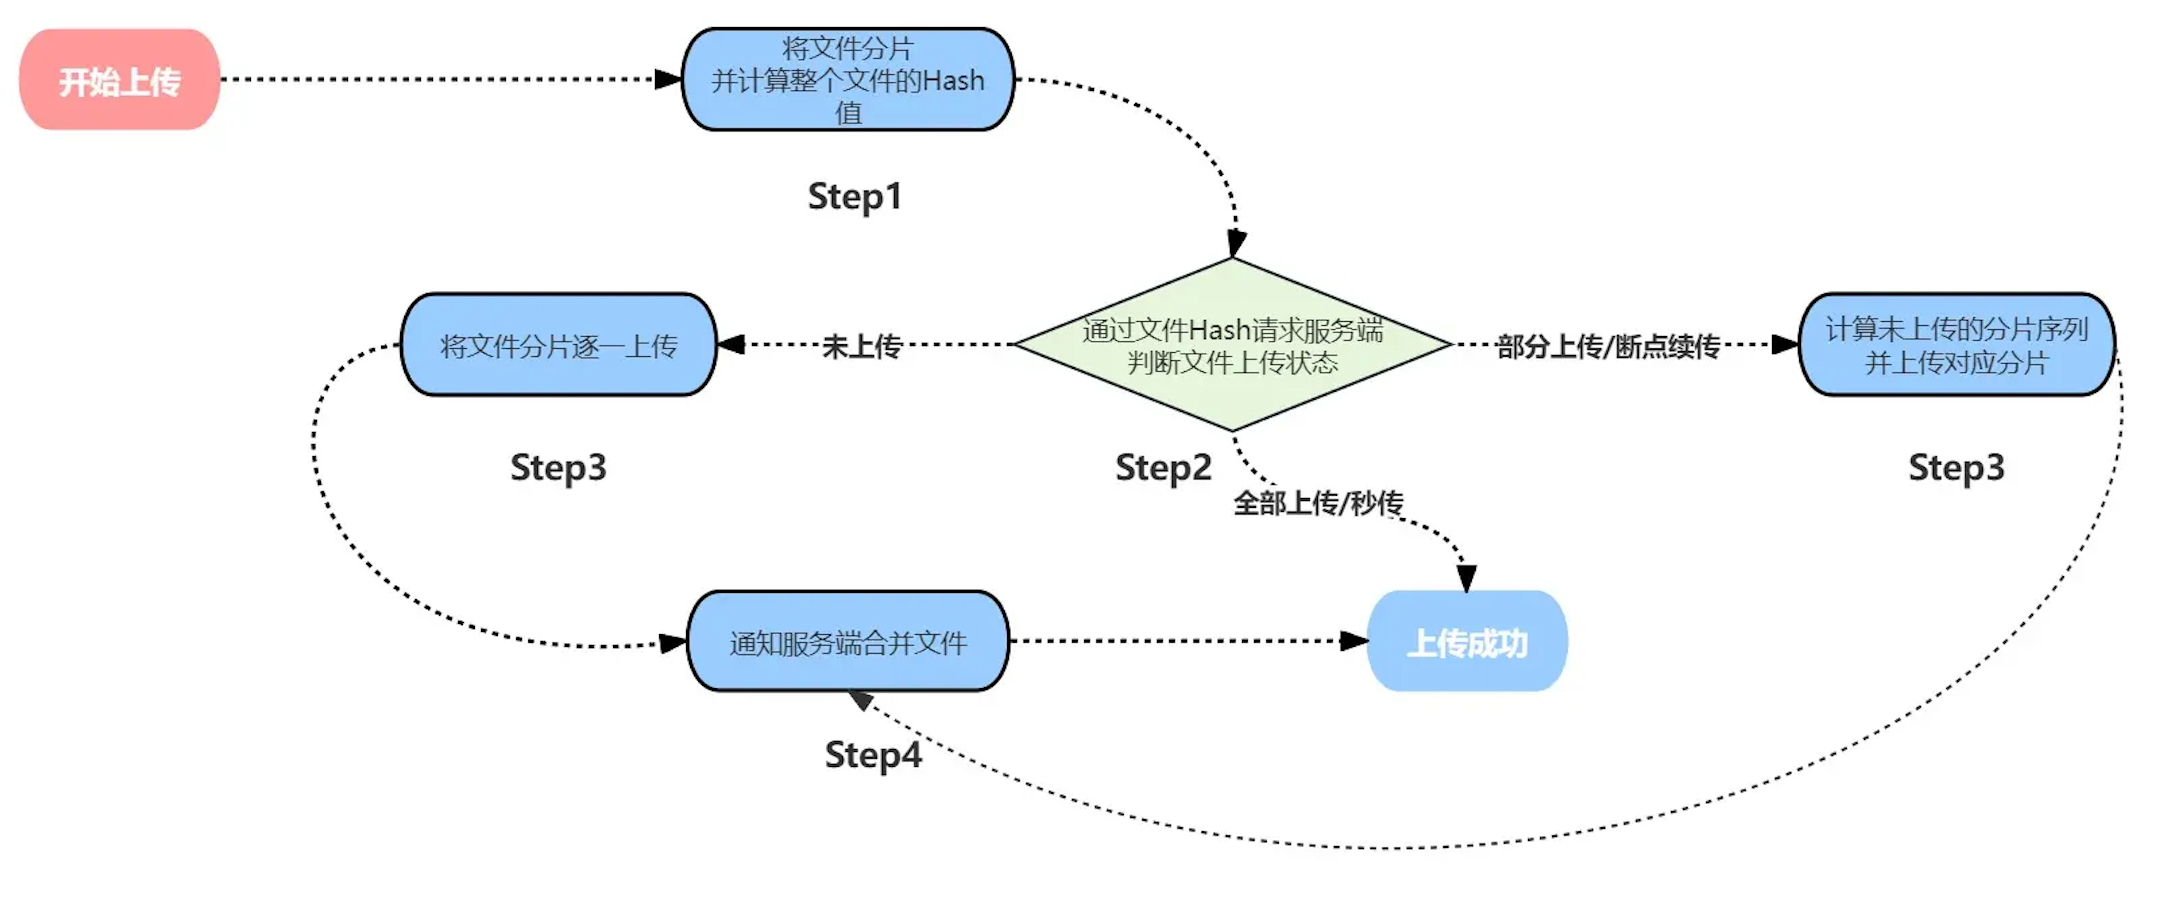
切开之后立刻带来三个好处。单个请求体从 2GB 变成 1MB,超时和 413 的问题直接消失。多个分片可以并行发,带宽利用率上去了。服务端不用把整个文件读进内存,内存曲线平了。
断点续传是建在分片之上的。既然文件已经是一片一片传的,服务端就能记住「哪几片收到了」。客户端每次上传前先问一句「这个文件传到哪了」,服务端返回还缺哪几片,客户端只补那几片就行。
秒传是断点续传的极端情况。如果服务端发现这个文件已经完整存在了,那一片都不用传,直接返回成功。实现秒传的前提是能给文件算出一个稳定的唯一标识,通常用 MD5 之类的 Hash 算法生成文件指纹。
所以这三件事共用同一套基础设施,那就是「切片 + 文件指纹」。指纹算出来了,秒传和断点续传就都是顺手的事。
# 二、整体链路,浏览器和服务端聊四次
在写代码之前,先把整条链路的交互顺序画出来,后面每一节都是在填这张图里的某一格:
┌──────────────┐                                     ┌──────────────┐
│   浏览器      │                                     │  Node 服务端  │
└──────┬───────┘                                     └──────┬───────┘
       │ ① File.slice 切片 + spark-md5 算 fileHash          │
       │    (大文件放 Web Worker,别卡主线程)              │
       │                                                     │
       │ ② POST /verify  { fileHash, totalCount, extname }   │
       ├────────────────────────────────────────────────────►│
       │                                                     │ 查
       │ ◄────────────────────────────────────────────────── │ chunkFile/<hash>/
       │    neededFileList = []        → 秒传,直接结束       │
       │    neededFileList = [3,7,9]   → 断点续传,只补 3 片  │
       │    neededFileList = [1..N]    → 全量上传             │
       │                                                     │
       │ ③ POST /upload  FormData(chunk,index,hash)  × N     │
       ├════════════════════════════════════════════════════►│ 落盘
       │      并发受控 · 单片失败单片重试 · 更新进度条         │ chunk-<index>
       │                                                     │
       │ ④ POST /merge   { fileHash, extname }               │
       ├────────────────────────────────────────────────────►│ 按索引排序
       │ ◄────────────────────────────────────────────────── │ 流式拼接
       │                  { ok, url }                        │ 删分片目录
四次交互里,第二次是整套方案的大脑。秒传、断点续传、全量上传三条分支全靠它的返回值决定,前端只需要照着 neededFileList 干活。
# 三、动手前要先认识四个浏览器 API
# 3.1 File 对象
File 是一种特殊的 Blob,从 <input type="file"> 或者拖拽事件里拿到,带着这几个只读属性:
| 属性 | 描述 |
|---|---|
File.name |
文件名 |
File.size |
文件大小(字节) |
File.type |
文件 MIME 类型 |
File.lastModified |
最后修改时间 |
这里有个坑要注意,File.type 是浏览器根据扩展名猜的,不可信。真要做类型校验得读文件头的 magic number,光看 type 很容易被改后缀绕过。
# 3.2 Blob.slice 做切片
切片靠的就是 Blob.slice(start, end),它返回一个新的 Blob,指向原文件的一段区间。
const blobSlice = File.prototype.slice || File.prototype.mozSlice || File.prototype.webkitSlice;
const chunk = blobSlice.call(file, start, end); // 返回指定范围的 Blob
mozSlice 和 webkitSlice 是很老的前缀写法,现在的浏览器都支持标准的 File.prototype.slice,这段兼容代码留着没坏处,但新项目直接写 file.slice(start, end) 就够了。
slice 有一个特别关键的性质,它是惰性的,不会真的把那段数据读进内存,只是记了一个偏移量。后面讲内存优化的时候会用到这一点。
# 3.3 FileReader 读取内容
要算 Hash 就得拿到二进制内容,这一步靠 FileReader:
const fileReader = new FileReader();
fileReader.readAsArrayBuffer(blob); // 读取为 ArrayBuffer
fileReader.onload = (e) => {
  console.log(e.target.result); // 读取结果
};
FileReader 是回调式的老 API。现在 Blob 上直接有 arrayBuffer() 方法返回 Promise,写起来清爽得多,配合 for await 循环读分片会比回调链好维护。老代码里的 FileReader 不用急着改,但新写的建议直接用 await blob.arrayBuffer()。
# 3.4 FormData 组装请求
分片上传走 multipart/form-data,前端用 FormData 组装:
const formData = new FormData();
formData.append('chunk', new Blob([chunkData])); // 文件分片
formData.append('index', 1); // 分片索引
formData.append('fileHash', 'xxx'); // 文件哈希
注意别自己手动设 Content-Type。传 FormData 时浏览器会自动带上带 boundary 的 Content-Type,你手写一个反而会把 boundary 弄丢,服务端解析直接失败。这个我踩过,排查方向很容易跑偏到后端去。
# 四、Step 1 前端切片并计算文件指纹
第一步要同时产出两样东西,分片列表和文件 Hash。因为算 Hash 本来就要把文件整个读一遍,顺手就把分片攒出来了。
import SparkMD5 from 'spark-md5';

/**
 * 将目标文件分片并计算文件 Hash
 * @param {File} targetFile 目标上传文件
 * @param {number} baseChunkSize 分片大小(单位 MB)
 * @returns {chunkList: ArrayBuffer[], fileHash: string}
 */
async function sliceFile(targetFile, baseChunkSize = 1) {
  return new Promise((resolve, reject) => {
    // 兼容不同浏览器的分片方法
    const blobSlice = File.prototype.slice || File.prototype.mozSlice || File.prototype.webkitSlice;

    const chunkSize = baseChunkSize * 1024 * 1024;
    const targetChunkCount = Math.ceil(targetFile.size / chunkSize);
    let currentChunkCount = 0;
    const chunkList = [];

    const spark = new SparkMD5.ArrayBuffer();
    const fileReader = new FileReader();

    fileReader.onload = (e) => {
      const curChunk = e.target.result;
      spark.append(curChunk); // 追加到 Hash 计算
      currentChunkCount++;
      chunkList.push(curChunk);

      if (currentChunkCount >= targetChunkCount) {
        // 全部读取完成,获取文件 Hash
        const fileHash = spark.end();
        resolve({ chunkList, fileHash });
      } else {
        loadNext();
      }
    };

    fileReader.onerror = () => reject(null);

    const loadNext = () => {
      const start = chunkSize * currentChunkCount;
      const end = Math.min(start + chunkSize, targetFile.size);
      fileReader.readAsArrayBuffer(blobSlice.call(targetFile, start, end));
    };

    loadNext();
  });
}
这段代码是串行读的,一片读完在 onload 里触发下一片。串行是必须的,因为 spark.append() 的调用顺序决定了最终 Hash 值,乱序算出来的指纹每次都不一样,秒传立刻就废了。
SparkMD5.ArrayBuffer 这个类的价值就在这里,它支持增量计算。你可以喂它一片一片的数据,最后调 end() 拿结果,全程不需要把整个文件驻留在内存里。浏览器原生的 crypto.subtle.digest() 只接受一次性的完整数据,做不到流式,这也是大文件场景下大家还在用 spark-md5 的原因。
不过这版实现有个明显的内存问题。


