AI 生成的联系表单也要防邮件滥发
作者在本地搭建了会向访客发送确认邮件的典型联系表单,并用模拟邮件服务对比加固前后的发送量。文章指出,表单功能验收容易漏掉服务端限流和防滥用检查。
AI 深度解读
一个 AI 生成的联系表单,只要允许访客指定确认邮件的收件人,就可能把网站自己的发信权限借给陌生人。作者用 Node 在本地做了两轮对照。相同的 724 次异常请求,先让模拟邮件 API 记录了 1,448 次发送,其中 724 次发往团队之外。加固后只剩 60 次,全部发给团队,正常留言也能送达。
最有用的一步发生在写限流代码之前。作者把「我们收到了」搬回网页,直接取消自动回信。如果你刚让 Cursor、Claude Code 或建站工具接好表单,可以从这里开始检查。
表单里最该先看的是收件人
作者给虚构的发票产品 Ledgerly 写了一个 Vercel 风格的 /api/contact。它只接收 POST,每次提交调用两次 resend.emails.send()。第一封发给固定的团队地址,第二封发给请求里的 email,还把请求里的 name 拼进邮件主题和正文。浏览器里的 required 和 type="email" 能辅助填写,服务端仍要自己校验收到的值。
这个设计把两个决定交给了提交者。一个是邮件寄给谁,另一个是品牌邮件里出现什么内容。自动回信既能反复打扰某个收件人,也能把带链接的文字放进一封看似来自品牌的邮件。团队通知还有自己的风险,留言被直接插入 HTML 后,原本应当作为文字阅读的内容可以变成可点击的链接。
作者用 Node 标准库搭了三块本地测试代码。server.mjs 模拟平台,解析 JSON,设置 req.ip,将请求体上限设为 5 MB。mailer.mjs 用内存发件箱记录 emails.send(),attack.mjs 为每个测试场景启动独立服务,避免限流状态串到下一组。统计的是进入模拟发件箱的记录,整个实验没有发送真实邮件。
因此,CR/LF 测试能证明换行字符进入了两封邮件的主题,无法据此断定真实服务商会如何处理。JSON 邮件 API 可能拒绝或编码这些字符,手工拼接 SMTP 头的实现则有邮件头注入风险。另一个可直接观测到的问题是体积,一条约 1 MB 的留言通过了处理器,交给模拟邮件服务的内容也超过了 1 MB。平台的请求体上限允许解析这条请求,业务字段仍然需要更小的上限。
先收紧发信权限,再用三道限额兜底
作者取消访客自动回信,页面直接展示提交成功。团队邮件发往固定地址,主题固定为 New contact form message。姓名、邮箱和留言可以进入纯文本正文,进入 HTML 时则要转义。确实需要邮件确认的候补名单,可以走双重确认(double opt-in),地址核验后的业务邮件使用固定模板,连访客填的姓名也无需带入。
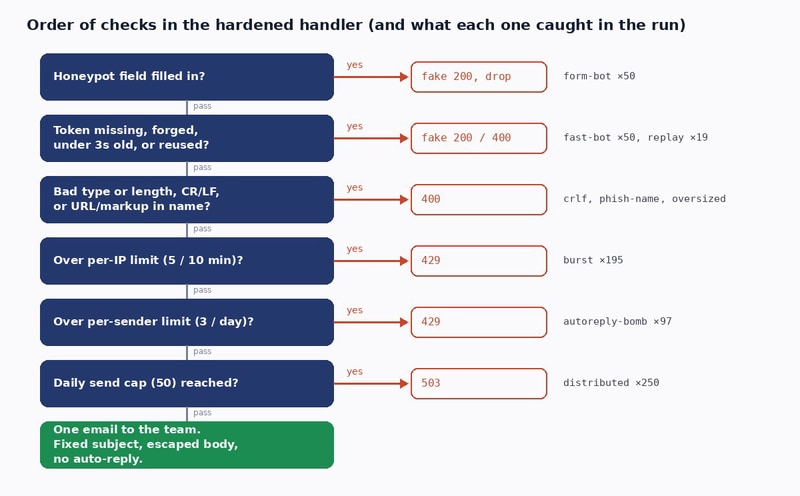
请求到达发信逻辑前,要先过隐藏的 website 蜜罐字段和签名令牌。令牌格式为 timestamp.nonce.HMAC,通过 FORM_SECRET 签名,最短填写时间 MIN_FILL_MS 默认是 3000 毫秒,有效期为 2 小时,每枚只能用一次。蜜罐被填或提交过快时返回 200 并丢弃,令牌缺失、无效、过期或重复使用时返回 400。业务校验要求姓名 1–80 字符,排除控制字符、链接和尖括号,邮箱最长 254 字符并检查格式,留言限制在 2–5,000 字符。
下面这段处理器把这些检查放在唯一一次团队发信之前。
export default async function handler(req, res) {
if (req.method !== "POST") return res.status(405).end();
const now = Date.now();
const ip = req.ip; // set by the platform, not by a client header you parse yourself
const b = req.body || {};
const reject = (status, reason) => res.status(status).json({ ok: false, reason });
// 1. bot checks first, and answer bots with a fake success so they don't adapt
if (b.website) return res.status(200).json({ ok: true, _dropped: "honeypot" });
const tokErr = checkToken(b.token, now);
if (tokErr === "too-fast") return res.status(200).json({ ok: true, _dropped: "too-fast" });
if (tokErr) return reject(400, tokErr);
// 2. shape and size
const bad = validate(b);
if (bad) return reject(400, bad);
// 3. rate limits
if (limited(`ip:${ip}`, PER_IP, now)) return reject(429, "ip-rate-limit");
if (limited(`email:${b.email.toLowerCase()}`, PER_EMAIL, now)) return reject(429, "email-rate-limit");
const today = new Date(now).toISOString().slice(0, 10);
if (today !== day) { day = today; sentToday = 0; }
if (sentToday >= DAILY_SEND_CAP) return reject(503, "daily-cap");
sentToday++;
// 4. one email, to us only. Fixed subject; user text escaped and only in the body.
await resend.emails.send({
from: "Ledgerly <hello@ledgerly.example>",
to: "team@ledgerly.example",
replyTo: b.email,
subject: "New contact form message",
text: `From: ${b.name} <${b.email}>\nIP: ${ip}\n\n${b.message}`,
html: `<p>From: ${esc(b.name)} <${esc(b.email)}></p><pre>${esc(b.message)}</pre>`,
});
// No auto-reply. The page shows "Thanks, we got it". Confirmation emails go out only
// after the address is verified (double opt-in) and never contain user-supplied text.
return res.status(200).json({ ok: true });
}
先看 to: "team@ledgerly.example" 这一行。它固定了收件人,访客地址只保留为 replyTo,供团队回复。再看 sentToday++,它发生在调用邮件 API 之前,因此发送失败也会消耗一次当天的额度。
三道限额管的是不同范围。每 IP 每 10 分钟允许 5 次,按提交的邮箱地址每天允许 3 次,触限返回 429。整个表单按 UTC 日期共享 DAILY_SEND_CAP,实验设为 50,耗尽后返回 503。前两道约束局部流量,最后一道给发信调用数封顶。
同样的 724 次请求,为什么还有 60 封邮件
两组各 50 次的机器人提交分别触发蜜罐和填写时间检查,HTTP 响应全是 2xx,模拟发件箱却是空的。20 次重复提交只发出 1 封,另外 19 次被单次令牌检查拦下。200 次突发提交只发出 5 封,100 次集中提交只发出 3 封。300 次分布式提交仍发出了 50 封,耗尽那一组独立实验的配额,其余 250 次被全局上限挡住。
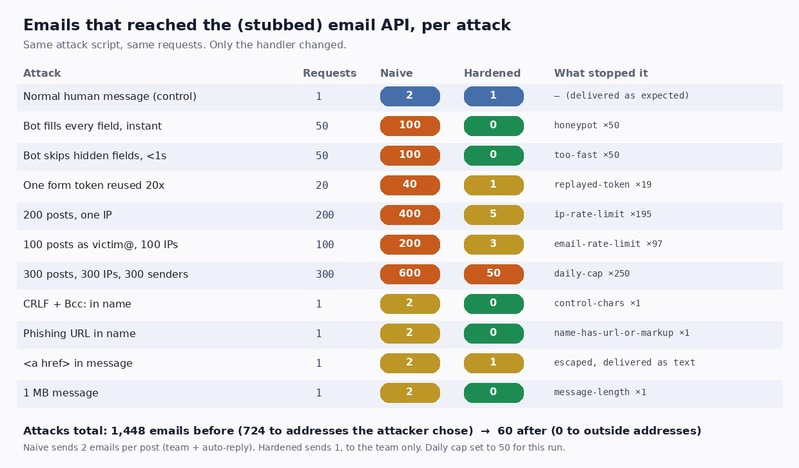
带原始 HTML 的留言在加固后仍能提交,团队收到的是经过转义的内容。超长留言、含控制字符的姓名和带链接的姓名都没有进入发件箱。按脚本对主题换行、URL 和原始 HTML 等特征的判定,异常邮件从 5 封降到 0 封。正常对照组也通过了,从发两封改为只发一封团队通知。这轮测试验证了发信目的地和调用量可以收住,团队邮箱仍会收到一部分滥用提交。
我的判断
我认同先取消自动回信。只加验证码,公开接口依然持有向访客指定地址发信的能力。只加 IP 限流,作者的分布式测试也说明为什么还要有总上限。反过来,如果邮件是产品流程的一环,双重确认的首封验证邮件本身仍是一次对外发送,也需要固定模板和发送预算。
限额的具体数字是实验配置。每邮箱每天 3 次会压低同一地址的发送量,但表单里的邮箱还未经核验。50 封的全局额度一旦耗尽,正常客户也会遇到 503。作者只跑了一条正常对照,没有给出真实流量下的误拦率,也没有拿这套规则和 CAPTCHA 做对照。蜜罐和 3 秒门槛拦住了这次测试里的两类机器人,实际能减少多少垃圾留言,原文没有数据。
还有个部署前提。作者在单进程里用 Map 和 Set 记录限流和已用令牌。部署到多实例 Serverless 环境时,各实例的内存独立,计数和令牌消费需要放到 Redis、KV 或数据库等共享存储中,并保证并发更新的原子性。示例还在响应里带了 _dropped,因此测试客户端能区分丢弃和真实成功。若上线时想让两种响应一致,可以把这个原因留在服务端日志里。
能拿来做什么
- 评审 AI 生成的
/api/contact时,逐个检查emails.send()的to、replyTo、subject和html来自哪里。普通联系表单可以用页面回执,邮件只发给固定的团队地址。 - 给 Node 接口明确写出字段类型、长度和 HTML 转义规则。前端保留
maxlength改善填写体验,服务端用模拟邮件客户端确认超长输入不会触发发信,合法留言仍能送达团队。 - 上线多实例版本时,从平台提供的可信信息获取
req.ip,把配额和令牌状态存到共享存储。监控同时记录提交响应和邮件调用数,页面的200可能只表示请求已被处理。