Agent 知识库为何越积累越容易失真
自动维护的 LLM Wiki 可能把有条件成立的结论改写成普遍事实,再通过后续引用持续放大偏差。文章指出,仅保留引用和持久记忆不足以防止语义漂移,共享知识还需要明确维护责任与审核机制。
AI 深度解读
LLM Wiki 最容易出问题的地方,是把「特定条件下成立」写成「普遍成立」,再让后续页面反复引用。最后,知识库链接齐全、语气笃定,结论却逐渐偏离原始证据。
作者讨论的就是这种「语义漂移」:个人用 AI 整理笔记尚能靠记忆补救,团队共享知识却需要有人维护事实依据。文章给出了一套三层结构和一周检查法,适合正在给编程 Agent 接入团队文档的人参考,但它提供的是治理建议,没有给出效果对照数据。
有引用,为什么还是会答错?
作者以 11 月 8 日一位开发者描述的问题切入:即使生成页面附带引用,结论也可能在多轮整理中变形。文章没有交代那位开发者的完整实验过程,因此这个案例更适合作为问题线索。
它描述的链条很具体:
原始评测记录写的是「8B 模型在我们的评测集上满足要求」;Wiki 整理成「8B 模型足够准确」;下一篇页面据此建议把模型交付给客户;Agent 最后引用这篇页面回答同事。
引用还在,适用范围却丢了。
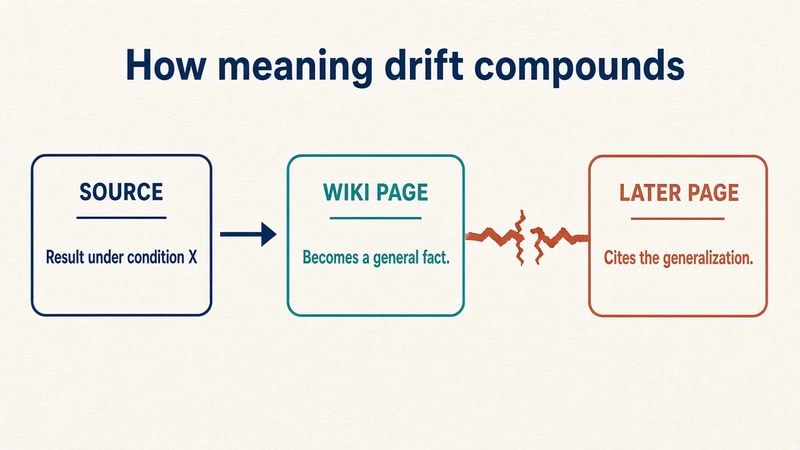
LLM Wiki 会读取资料生成页面,再把页面作为下一轮生成的上下文。这种循环让知识整理持续进行,也让早期的小偏差获得更多传播机会。后来者看到的是整理后的结论,未必会回到评测记录核对。
引用能告诉你答案来自哪里,却不能保证引用链保留了原始条件。
所以,持久化记忆解决了「下次还能读到什么」,没有自动解决「读到的东西是否可靠」。共享、由 git 管理的 Wiki 可以让同事的编程 Agent 少走重复路,也可能把同一处误解更快传给整个团队。
团队需要的不是选对笔记软件,而是明确谁负责事实
原文提到 Karpathy 的 LLM Wiki、个人记忆项目,以及 Claude 与 Obsidian 的连接方案。作者承认这些工具有用,但认为团队不该只围绕 Notion 与 Obsidian、云端共享与本地文件来做选择。
个人通常还记得笔记的来历,也可能保留原始 PDF。团队成员离职后,这些隐含信息就可能一起消失。接手的人和 Agent 只能依赖文档。
作者提出三层结构:
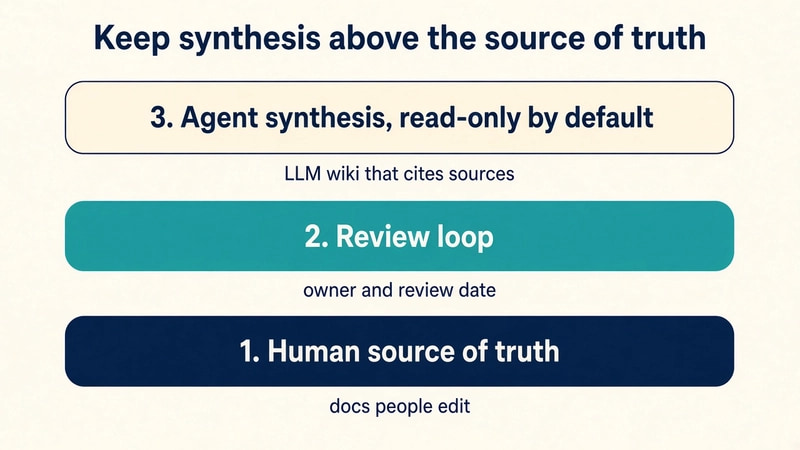
第一层是团队维护的事实依据,包括文档、规格、RFC 和运行日志。原始资料应与生成摘要分开保存,修正发生在这一层。如果选择自托管,资料可以留在团队控制的基础设施内;知识工作区、模型服务和聊天界面也应分开考虑,方便更换模型提供方。
第二层是审核。重要的生成页面需要负责人、复核日期和变更记录。新增事实应直接链接来源文档;如果依据仍是另一篇生成页面,就先作为草稿,等待人工接受。
第三层才是 Agent 综合:生成主题页、简报,以及团队对某个问题的当前认识。作者建议默认只读,通过限定访问范围的凭据读取工作区,文中将 MCP 列为当前常见模式。接入后先用真实问题测试,答案有误时优先修正文档。
这里的「修正文档」有明确目的:让下一位同事和下一个 Agent 都能读到修正后的依据,而不是只有某次对话获得补丁。
作者也披露自己参与 AFFiNE,并把它列为第一层的一种选择。据原文介绍,它是开源、local-first 的工作区,支持文档、白板和数据库,可选 BYOK AI 层,工作区 MCP server 默认只读。但作者同时承认:只需要以阅读为主的手册,或者今天就要求 Agent 通过稳定版写入工作区,AFFiNE 都可能不合适。
一周检查,先查最常被引用的三页
文章给出的检查不需要购买工具。先选一个 Agent 已经经常回答的主题,例如架构或值班手册,再取出它引用最多的三篇 Wiki 页面。
逐句检查事实陈述:引用指向原始文档,还是另一篇生成页面?然后找出被删掉的限定条件,例如「在预发布数据集上」「仅适用于企业租户」「截至 9 月」。
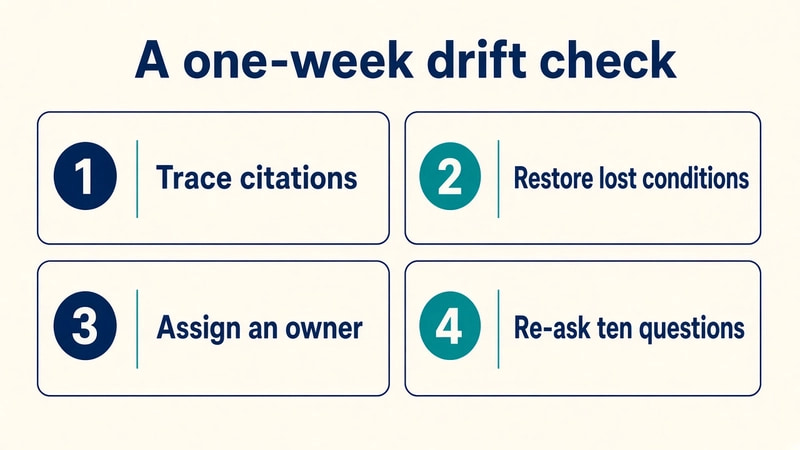
把修正后的结论放回事实依据文档,让 Wiki 保留摘要和来源链接,再给页面指定负责人及复核日期。最后重新提出同样的十个问题,检查每个答案是否引用正确来源;失败时继续修改文档。
这套检查把「回答看着不错」变成了可核对的项目。不过,原文只要求评估引用是否正确,没有给出完整的答案准确性评分标准,也没有报告执行前后的改善幅度。
如果检查发现大量 Wiki 引用 Wiki,作者判断应优先处理语义漂移。这个判断有道理,但正确引用仍需配合内容核对:指向原文,也可能误读原文。
我的判断
我赞同把原始证据、审核和生成摘要分开。尤其是架构约束、评测结论、故障处置条件,摘要少掉一句前提,就可能改变执行结果。负责人和复核日期能让纠错有明确落点。
但人工负责不等于人工逐句批准一切。原文没有给出维护成本,也没说明多人意见冲突如何处理。小团队若给所有页面都套上同样流程,审核可能跟不上生成速度。更合理的取舍是先覆盖会影响上线、客户承诺和故障处置的内容。
与单纯扩大上下文、改提示词相比,这套办法直接处理了证据被改写的问题;但检索和提示词仍可能出错,不能因为文档有问题就排除其他原因。文章的三层结构和默认只读策略属于经验建议,缺少对照数据,不能据此宣称已经验证优于所有替代方案。
另外,作者与 AFFiNE 有直接关系。文中的产品推荐应结合这个立场阅读,流程建议则可以独立采用。
能拿来做什么
- 给编程 Agent 接入架构文档前,先整理原始 RFC、决策记录与生成摘要的关系,让关键结论能直接追溯到来源。
- 检查前端兼容性、Node 服务容量等现有结论时,把测试环境、适用范围和记录日期一起保留,避免摘要把局部结果扩大成通用建议。
- 团队首次开放知识库访问时,可以从限定范围的只读权限开始,用同样的十个真实问题复查引用和答案,再决定是否开放写入。
- 从最常被引用的三页做起,为重要页面指定负责人和复核日期,把纠错结果写回团队持续维护的文档。