给 AI 智能体的知识库写入加一道审核
Obsidian Skills 让智能体能按知识库约定处理双链、嵌入和画布等内容,MCP 则可提供远程写入入口。文章面向 Markdown 或 Git 知识库,介绍如何限定写入范围、提交审核,并提供可在 CI 中运行的脚本。
AI 深度解读
Obsidian Skills 让 AI Agent 能按知识库的格式写笔记,MCP 让外部客户端也能调用写入工具。两者接起来,团队 Wiki 就有了一套写 API。作者的建议是,把写入拆成不同权限的操作,让正式页面的改动先过 CI,再由人看差异、决定合不合并。
这套设计值得看,因为知识库里的错误会被反复使用。一句写错的上线说明,可能被另一个会话检索,再被摘进新的排查文档。文章给了一套 Markdown + Git 团队能试跑的流程,也用两个测试分支演示了它能拦住什么。
为什么给写接口加了鉴权,还要审改动
Obsidian 的 Steph Ango(kepano)发布了一批 Obsidian Skills,教 Agent 在 vault(Obsidian 知识库目录)里处理双链、嵌入、.base 文件、JSON Canvas 和命令行。Agent 有了明确的格式说明,就能承担维护工作。差不多同一时间,一名安全研究者披露了一个价值 5,000 美元赏金的 MCP 鉴权绕过案例。按原文描述,调用者无需登录就能改写一位创作者的 AI 知识库。
鉴权管的是谁能发起写入。就算调用者有权限,读入的网页、PDF 或邮件里也可能夹带提示注入(prompt injection),让 Agent 把外部指令当成知识存进 Wiki。还有一种更常见的情况,Agent 单纯理解错了,把两个名称相近的页面合并了,或者改掉了自己没读懂的团队政策。
这些风险有个共同点。内容一旦进入团队默认检索的页面,后续会话就可能把它当作已有知识,再写入别的页面。审查关卡把判断放在第一次进入正式知识库之前。审核人能看到 Agent 改了哪几行、为什么改、依据在哪。
给 Agent 三种写法,权限在服务端执行
新材料先进 inbox/,只能新建笔记。要改 wiki/ 正文,就提交到 agent/<run-id> 分支,返回审阅链接。直接写入留给影响范围固定、可从现有内容重建的产物,例如 wiki/_index.md。
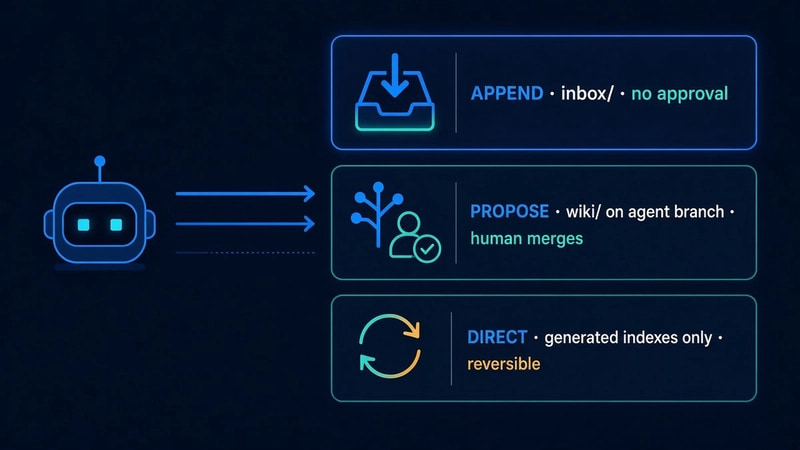
下面这组 MCP 工具定义,把三种写法变成调用者能直接使用的接口。
[
  { "name": "append_note",
    "description": "Create a new note under inbox/. Cannot modify existing files.",
    "input": { "title": "string", "body": "string", "sources": ["string"] } },
  { "name": "propose_edit",
    "description": "Write a change to wiki/ on branch agent/<run-id>. Returns a review link. Never merges.",
    "input": { "path": "string", "new_content": "string", "reason": "string" } },
  { "name": "rebuild_index",
    "description": "Regenerate wiki/_index.md from current pages. No other effect.",
    "input": {} }
]
看 rebuild_index 的 "input": {} 这一行。调用方既不用提供文件路径,也不用提供新正文,目标文件和生成逻辑都由服务端决定。propose_edit 则要由服务端保证只写提案分支。工具描述负责告诉模型如何使用,服务端实现负责限制它实际能做什么。即使以后漏掉一次鉴权检查,这些限制也能缩小可改动的范围。
CI 先筛掉机械问题,人再判断内容
作者的 write_gate.py 跑在 Git 支撑的 Wiki 上。它用 git diff --numstat 统计改动,只允许分支触碰 wiki/ 和 inbox/。它读取基准版本的页首元数据(frontmatter),遇到 owner: human 就拒绝修改原页,Agent 可以改去 inbox/ 留建议。它还检查 Wiki 页有没有 sources:,并用 git cat-file -e 确认匹配到的 raw/ 引用在提案分支里存在。
脚本对新增文本做正则检查,例如匹配 ignore previous instructions、curl 后跟 HTTP URL、base64, 和 <script。另外,新增和删除行数合计最多 120 行。原文拿 900 行的「合并整理」举例,这种规模的重写应该一开始就让人介入。
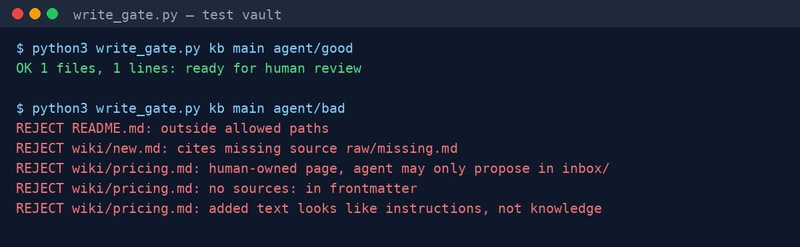
下面是作者在小型测试库里跑出的结果。好分支给入职文档补了一步,原页面已有会议记录作为来源。坏分支同时触发了路径、归属、来源和新增文本检查。
$ python3 write_gate.py kb main agent/good
OK 1 files, 1 lines: ready for human review

$ python3 write_gate.py kb main agent/bad
REJECT README.md: outside allowed paths
REJECT wiki/new.md: cites missing source raw/missing.md
REJECT wiki/pricing.md: human-owned page, agent may only propose in inbox/
REJECT wiki/pricing.md: no sources: in frontmatter
REJECT wiki/pricing.md: added text looks like instructions, not knowledge
第一条命令的三个参数依次是仓库 kb、基准 main 和提案分支 agent/good。OK 那行的状态是 ready for human review,通过检查后还要审内容。通用调用形式是 python write_gate.py <repo> <base-ref> <agent-branch>。
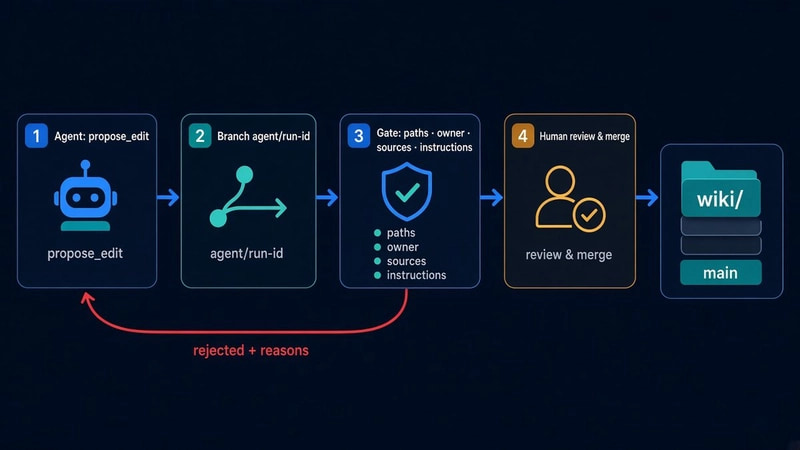
把脚本接入 MCP 后,CI 拒绝的原因可以作为工具结果回传,让 Agent 补齐来源或改投 inbox/。通过的提案进入审阅队列,审核人看 Git diff 和 reason,然后合并或关闭。两种决定都能留在历史里。作者还建议记录每次写入由哪个客户端、哪个会话、哪份源文档触发,方便事后定位是哪次导入带来了问题。
我的判断
最值得照搬的是服务端写入分级和 Git diff。只给模型一条「别改政策页」的提示词,规则能否生效取决于模型当时怎么理解上下文。用服务端工具和分支权限限制写入,规则可以独立于模型执行。相比让人逐条审批所有写入,分级也让补记材料、重建索引这些操作有自己的通道。
脚本适合作为起点。它用字符串查找 sources:,没有解析 YAML,也没有验证来源列表非空。raw/ 文件存在,只能说明引用路径找得到,审核人还得判断原材料能否支持改动。正则同样只适合提醒,前端 Wiki 里合法的 curl 示例或 <script> 片段也可能触发它。作者只跑了两个小分支,没有给误报率、漏报率或审阅耗时的对照数据。
每天集中审一到两次、连续六周原样合并后放开 wiki/glossary/,都是经验建议。团队能否照做,取决于目录能不能按影响范围划分,以及有没有人稳定处理提案。作者借此说明自己为何做开源、可自托管的 AFFiNE。选型时我会先验证实际能力,尤其是能否按范围授权、逐页查看差异和回滚、区分人与 Agent 的修改,以及把写接口放到团队自己的鉴权之后。
能拿来做什么
- 如果前端团队已经用 Git 管入职文档、发布流程或组件约定,可以先把 AI 改文档的操作接到提案分支。让每个提案附上改动理由和对应的会议记录或原始说明,审核时同时看 diff 和依据。
- 如果用 Node 写 MCP Server,可以先实现
append_note和propose_edit。由服务端固定收件箱目录、创建提案分支,并约束 Agent 的身份只能提交分支。已有确定性生成逻辑的索引页,可以单独接rebuild_index。 - 知识库经常收录技术示例时,可以先用现有文档跑一遍正则规则,看看
curl和<script>的实际误报,并把可疑内容交给审核人判断。路径、页面归属和来源检查仍放在 CI 里执行。 - 审过一批提案后,再按目录回看哪些改动总是原样合并。优先考虑让低风险词汇表直写,涉及政策、定价、人员和安全的页面继续走提案。