Claude Code 五款插件实测出现成本或耗时上升
文章引用 Chase AI 的对照测试,五款插件在输出质量相当时都增加了成本、耗时,或两者兼有。以节省 Token 为卖点的 Caveman 总成本高出基线 8%,在 CLAUDE.md 中只加一句简洁作答指令比它少用 23% 的 Token。
AI 深度解读
给 Claude Code 装上插件,账单可能先涨,任务通过率却原地踏步。作者引用的 Chase AI 基准把 Superpowers、ECC、Graphify、Caveman 和 Claude Mem 与裸跑的 Claude Code 做对比。在产出质量相当的条件下,五款插件都出现了成本上升、耗时增加,或两者同时发生。
这些测试给出了一种更实用的选插件方法。先看它为仓库里的任务解决了什么,再算每个通过验收的任务花了多少钱。尤其是标榜省 token 的插件,得问清楚它省的是回答里的字,还是执行过程中反复发生的模型调用和工具调用。
插件还没用上,为什么已经有开销?
Claude Code 需要知道当前有哪些技能、子代理、钩子和 MCP 服务可用。插件会把其中一部分描述放进会话的固定上下文。即使当前任务用不到这些能力,相关描述也可能随每一步请求发送。任务跑得越久,这部分上下文就出现得越多。
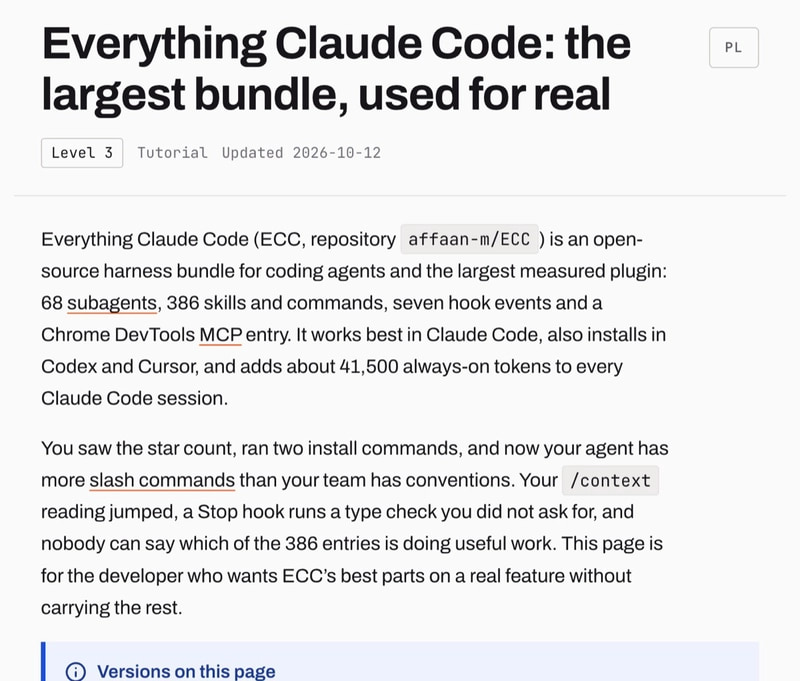
DeveloperToolkit.ai 在 2026 年 9 月测了五款插件。ECC 常驻约 41,515 个 token,约为 Superpowers 的 50 倍,后者是 838 个。原文还提到,SessionStart 钩子默认注入上限是 8,000 字符。作者把两部分合计为接近 50,000 token,再以 Opus 每百万输入 token 15 美元估算,得到每次会话约 0.75 美元、每天 20 次会话约 450 美元一个月。这是按输入单价推算的量级,实际账单还取决于缓存命中和计费方式,字符上限也不能直接当成 token 数。另有一次实践测试同时跑了 10 个插件,报告每轮多出约 20,000 输入 token。
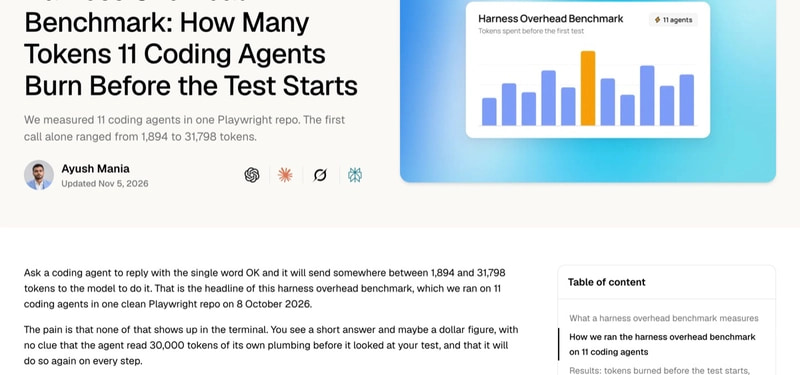
固定上下文也是 Claude Code 自身的成本。TestDino 在干净的 Playwright 仓库里测了 11 个编程代理,首轮开销最高和最低相差 16.8 倍。Claude Code 是 31,480 token,Pi 是 1,894 token。用 15 步任务来估算,Claude Code 会发送约 472K token 的框架上下文,叠加重型插件后可超过 700K。这个数字描述的是发送量,仍需结合实际账单判断成本。
Caveman 省下来的 token 去了哪里?
Caveman 的 README 宣称能少用 65% 的输出 token。JetBrains 在 SkillsBench 的 A/B 测试里测到 8.5% 的节省,原文把两者的数值差描述为 7.6 倍。Chase AI 则测得 Caveman 比基线贵 8%,而在 CLAUDE.md 加一句 answer concisely,token 用量比 Caveman 少 23%。这些数字来自不同测试,输出 token、总 token 和实际成本也各有自己的统计口径。
另一项独立评测更能解释差异。它覆盖 SWE-Bench、USACO、Terminal Bench 的 60 道任务,每种配置重复 3 次,共 900 次试验。在 Sonnet 5 上,Caveman 比裸跑 Claude Code 少用 18.4% 的总 token。研究者观察到,执行步骤少了 17%,工具调用少了 20%,而用户看得到的自然语言回答只占会话 token 的 0.05%。把 Claude Code 的推理强度设为 medium,也能以更低成本达到相同的 Pass@3,即三次尝试中至少一次通过的得分。
这组结果提示我们,判断插件是否省钱,要看它改变了哪些执行行为。回答变短很显眼,少跑几轮工具调用对这项测试的总用量影响更大。
为什么要按通过验收的任务算成本?
FrontierHarness Eval v1.1 用 5 个模型、22 种代理框架配置跑了 62 道终端任务,共 27,280 次运行,消耗 830 亿 token。64.5% 的支出花在未通过验证的试验上,其中直接失败占总支出的 52.7%,超时占 11.8%。同一个模型也有选择空间。v1.0 中,Kimi K3 在 9 种框架之间的每次通过成本相差 17 倍,v1.1 中,各模型内部的差距缩到 1.9 至 4.9 倍。这组分析里,模型选择解释了 92.8% 的成本差异,框架选择解释了 2.3%,两者约差 40 倍。
山东大学的研究(arXiv:2610.04433)用 5 个模型,在 492 道 SWE-bench Verified 任务上比较 Claude Code、OpenCode 和约 100 行 Python 的 mini-SWE-agent。Claude Code 和 mini-SWE-agent 的通过率相差不到 2 个百分点,同一模型换框架后,单任务成本最多能差 3 倍。两者的初始固定上下文分别是 16,581 和 829 token。换用更新的 Claude Code 后,通过数从 34 道升到 35 至 36 道,每次试验成本却从 0.73 美元升到 1.65 美元。
这些研究测的是整套代理框架,插件只是其中一层。可以借用它们的测量方法,在自己的任务里记下首轮上下文、每步增加的 token 和执行步数,再用总花费除以通过验收的任务数。失败的尝试和返工也就进了账。
我的判断
最有说服力的是这笔账的算法。GitHub 当周 15 个热门仓库里有 13 个属于代理框架、技能包或插件集合,但 Star 数衡量的是关注度,不能用来估算某个团队能省多少返工。作者把插件流行归因于 2025 年和 2026 年初的模型需要更多辅助,这有解释力,但原文没给出足够的跨版本对照,属于经验判断。终端基准也很难覆盖团队日常遇到的验收模糊、长周期改动和人工审查。
我会优先保留能提供环境信息的工具。比如,Playwright MCP 能让代理检查实际页面,数据库 schema 加载器能给它提供真实字段。至于要求提交前跑测试,pre-commit hook 可以直接执行检查,提示词则适合表达需要模型理解的约定。作者举例说,Superpowers 每周能阻止一次方向错误的重构就可能回本,20 人团队也可能靠统一插件降低协作成本。这两笔收益都没有对照数据。一个值得留在账本里的反例是,原文引用的另一次实验固定模型和任务,只改框架,就在一个下午提高了 15 个模型的编程得分。框架的价值仍然要看具体任务。
能拿来做什么
- 在全新 Claude Code 会话里运行
/cost记录基线,选一个有明确验收条件的日常任务,例如修好一条失败的 Playwright 测试。记录 token、费用、耗时和测试结果,再逐个启用插件做对照,尽量固定模型、初始代码和验收条件。 - 如果目标是减少解释,在
CLAUDE.md先加Answer concisely. Skip explanations unless asked.。如果主要开销来自执行步骤,再单独试medium推理强度。每次改一个变量,方便判断差异来自哪里。 - 选几类团队常做的任务,按通过验收的成本评估插件。每季度或每次模型大版本升级后复测,把仍能改善通过率、减少返工或提供必要环境信息的插件留下来。