给 Agent 加网页权限,可能打开数据外传通道
文章用一行 Claude Code 权限配置变更说明:数据库读取权限与免审批网页访问组合后,可能同时具备读取私有数据、接触不可信内容和向外发送数据的能力。作者据此强调,应把 Agent 权限配置纳入代码审查。
AI 深度解读
一个 PR 只给 Claude Code 增加了 WebFetch,看起来是在省掉访问文档时的反复确认。作者运行扫描器后发现,它把数据库读取、外部内容读取和免审批外传接到了一起。风险来自权限组合,单看新增工具很容易漏掉。
作者的主张是:Agent 权限应该像代码一样,写进文件、经过评审,并在每次工具调用时执行检查。文章给出了配置差异和本机运行示例,但没有证明这套方案能挡住所有攻击。对已经使用 AI 编程工具,或者正在给产品接入 Agent 的团队,它提供了一套值得检查的权限边界。
为什么新增一个 WebFetch 就改变了风险
原来的项目允许 Claude Code 通过 MCP 查询应用数据库的 staging 副本。为了让它打开文档网站时少问几次,有人提交了下面的改动:
- { "permissions": { "allow": ["mcp__postgres"] } }
+ { "permissions": { "allow": ["mcp__postgres", "WebFetch"] } }
关键是新增的 "WebFetch":它允许访问的目标没有被限制在文档站点。
作者用自己维护的扫描器检查这个差异,得到 CRITICAL AGC-TRI-001,位置是 .claude/settings.json:1。扫描器认为,该配置同时具备读取私有数据、读取不可信内容,以及免审批向外发送数据的能力。
这里容易误判的是第三项。请求网页也可能发送数据:只要 Agent 能决定 URL,就可能把数据库记录拼进查询参数。一段恶意网页内容可以诱导模型读取数据,再访问携带这些数据的地址。这个过程不需要一个名字叫「上传」的工具。
作者采用的修正是把规则缩到 WebFetch(domain:docs.python.org)。按照其扫描结果,向外发送数据重新需要审批,告警从 critical 降为 medium。风险没有消失,因为 Bash 仍可能提供外传路径,只是这条路径需要人确认。
这也是所谓的「致命三要素」(lethal trifecta):私有数据、不可信输入、对外发送能力同时存在。
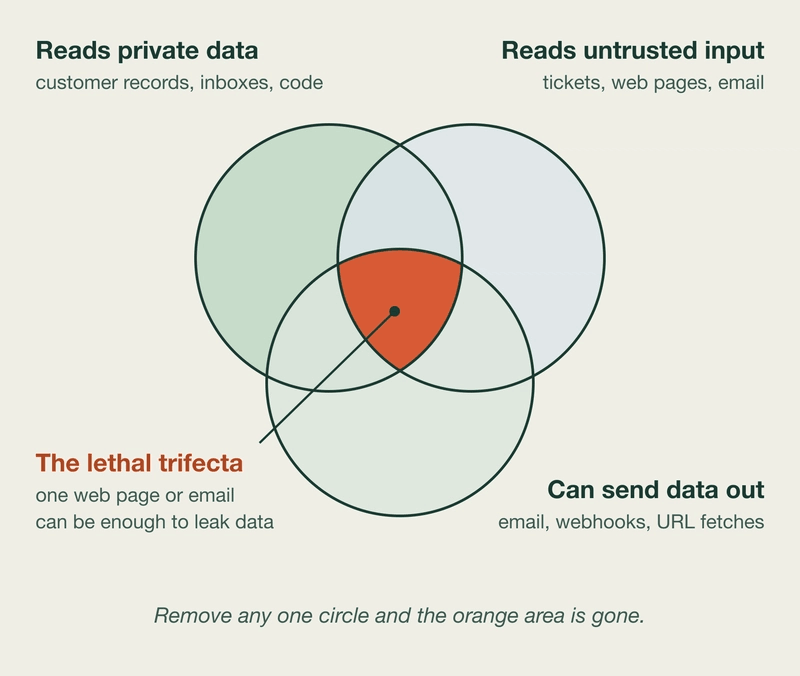
评审 Agent 配置时,应该检查新增权限与已有权限组合后能做什么。
不过,切断外传只针对泄露路径。不可信输入叠加写权限,仍然可能造成删除或篡改。
为什么提示词管不了权限边界
作者把 Agent 分成了两部分:提示词和上下文影响它「想做什么」,工具和凭据决定它「能做什么」。
提示注入(prompt injection)攻击前者。工单、网页、邮件、代码注释、工具返回值,都可能把恶意指令带进上下文。作者认为,当前没有可靠的方法彻底阻止这类攻击,过滤也会漏。
因此,他主张把能力约束放到模型读到的文本之外。即便模型被诱导去删错工单,执行层也应该拒绝越权调用。
这要求同时做好两件事:先用文件声明允许的工具、资源、数据去向和人工审批条件,再让每次工具调用检查这些声明。只有文件,约束可能落空;只有运行时检查,团队又难以通过 PR 看清策略变更。
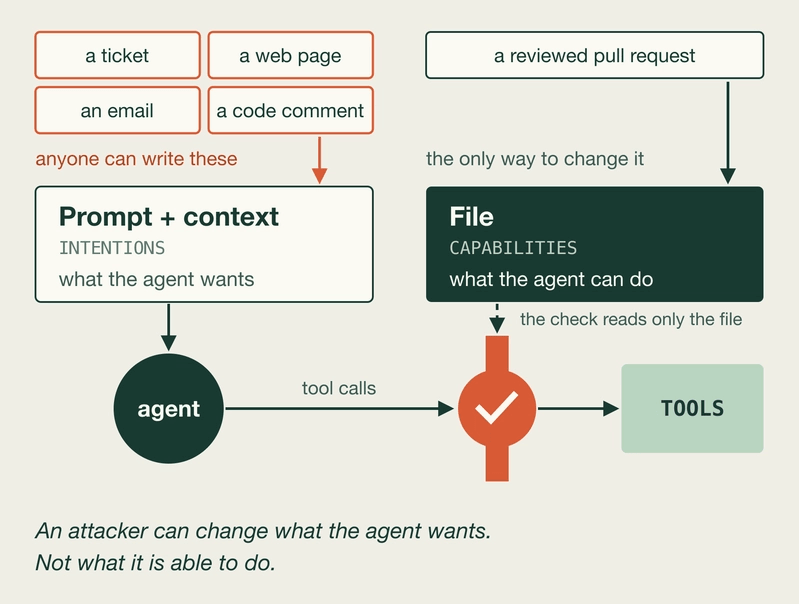
还有一个前提:Agent 不能随手修改自己的权限文件。作者建议禁止通过 Edit 修改 .claude/** 和 .mcp.json,让 Bash 保持询问,并将这些路径加入 CODEOWNERS。
这几项需要一起看。只限制 Edit,却保留能改写同一文件的 shell,权限边界仍有旁路;CODEOWNERS 负责让变更有人评审,运行时约束还需要另外执行。
把配置审查延伸到工具、任务和审批
对 Claude Code、Codex、Cursor、Copilot、Gemini CLI,以及运行它们的 GitHub workflows,作者首先建议检查仓库里的权限配置,包括 .claude/settings.json、.mcp.json、.codex/config.toml 和 .cursor/mcp.json。
他给出的命令是 npx @shieldaai/agent-guard-check --base origin/main。该扫描器只读取文件,不运行仓库代码,默认只因新增的 high 及以上问题而失败。它关注的是「这次是否扩大权限」,避免已有问题阻塞每个 PR。运行时则可以结合 permissions.deny、PreToolUse hooks,或带允许列表的 MCP gateway。
这里有个覆盖范围问题:用户级、本地配置还会与项目配置合并,仓库里的文件并不等于最终生效权限。
工具定义也需要审查。MCP 工具描述会进入模型上下文,服务端更新描述,可能影响模型如何选择工具。作者建议固定已批准的版本或定义摘要;定义变化后,先拒绝调用,等人审核。至少应在 .mcp.json 里使用 pkg@1.4.2,避免 @latest。无法解析的配置、无法追踪的 hook、无法识别的工具,则采用默认拒绝(fail closed)。
对团队自己交付的 Agent,权限文件还应包含负责人和 review_by,并把授权缩到具体任务和资源。例如:
grants: [{ tool: 'delete-ticket', resources: ['ticket:42'] }]
这条授权只允许当前任务操作 ticket:42。模型即便请求删除 ticket 7,执行层也应在调用前拒绝。
人工审批同样需要精确。下面的示例解决的是一次批准被反复使用的问题,原文省略了工具注册部分:
const prepared = await guard.prepare(task, { tool: 'delete-ticket', args: { id: '42' } });
const approvalId = guard.approve(prepared, { approverId: 'alice', expiresAt: Date.now() + 30_000 });
await guard.execute(prepared, { approvalId }); // runs
await guard.execute(prepared, { approvalId }); // throws ACTION_USED
要看的是 30_000 的有效期和最后一次 execute:同一个审批只能执行一次,重放会抛出 ACTION_USED。guard.approve 必须由已登录用户点击确认后的业务代码调用,不能交给模型。
最后,凭据也要匹配这些约束。文件声明只能读工单,实际 token 却有 admin 权限,一旦存在绕过检查的客户端,声明就限制不了它。
我的判断
这篇最有价值的地方,是把权限评审从「配置格式对不对」推进到「组合后新增了什么能力」。域名限制、资源授权、一次性审批,各自处理不同层次的问题,比单靠提示词提醒模型谨慎更容易验证。
但开头展示的是扫描器对权限组合的判定,并没有展示完整的数据窃取攻击。告警从 critical 降到 medium,也属于该工具的风险分级,不能直接读成真实攻击概率下降了多少。
作者维护了 Agent Guard 和扫描器,称二者免费、开源,采用 Apache-2.0;示例和扫描输出来自其本机运行。文章没有提供与其他方案的对照数据,因此「外传通常最容易切断」等建议,应当视为经验之谈。
方案的效果还取决于执行入口是否完整受控。独立数据库连接、备用 shell、持有相同 token 的第二个客户端,都可能成为旁路。文件也无法把过宽授权变安全:如果允许退还任意订单,执行层照规则放行,业务损失仍然可能发生。
仓库配置、用户配置与运行时真实权限如何完整对齐,原文没有说清。
能拿来做什么
- 如果团队已经使用 AI 编程工具,可以先把相关配置纳入 PR 审查,重点检查读取内部数据的 MCP 与网页访问、Bash 等能力的组合,同时核对用户级和本地配置。
- 如果 Agent 只是查某个站点的文档,可以从限定域名开始收窄权限,再检查 shell 和其他工具是否仍能任意外传数据,避免只改了一条表面规则。
- 如果正在用 Node 编写工单或内部业务 Agent,可以在工具执行入口校验任务与资源,把「能删除工单」缩成「本次任务能删除这张工单」,并让真实凭据配合限制。
- 如果工具已经接入人工确认,可以检查审批是否绑定具体参数、具体资源、有效期和单次使用状态,确认模型无法自行批准,也无法重复消费同一次批准。