给编程 Agent 写清结果、证据与裁决者
文章将 Agent 验收标准拆成三个问题:最终可观察到什么结果、用什么证据验证、由哪个检查或具体人员裁决。通过在任务开始前补齐这些信息,减少 Agent 对模糊需求自行猜测造成的返工。
AI 深度解读
给 AI Agent 一张「优化搜索」「清理代码」的工单,它可能很快交回修改,并告诉你已经验证完成。问题是,它完成的任务,未必是你心里那件事。没有写清的标准,会在实现过程中变成模型自己的判断。
作者给出的办法很具体:开工前,把验收标准写成可观察的结果,指定证据,再明确由谁判定。文章值得读的地方,是它把「怎么描述需求」推进到了「凭什么认定完成」,还专门处理了 Agent 自己写代码、自己写测试时的验证漏洞。
验收标准要回答三个问题,少一个都容易跑偏
作者认为,每条验收标准都应该回答:最终什么状态成立,拿什么证明,以及谁来决定通过。
「添加测试」只描述动作。Agent 写出一个测试文件,就能宣称做完了。「重复使用同一邮箱注册会被拒绝」描述结果,才给实现划出终点。证据可以是测试结果、命令输出,也可以是某个页面;判定方则应该是具体的 CI check,或者具体的人,不能笼统写「团队」「QA」。
验收标准的价值,是把完成与否变成有证据、有人负责的判断。
「快」「健壮」「正确处理」「用户友好」也需要换成数字、实例或指定评审人。原文把「让搜索更快」改成:在预置的 50,000 条订单数据上,搜索结果第一页的返回耗时,第 95 百分位低于 300 ms,由 search-perf check 判定。第 95 百分位可以粗略理解为,至少 95% 的测量结果不超过这个门槛。
这比「更快」具体,但原文没有交代运行环境、并发量,以及计时是否包含网络传输。拿到自己项目里,还得补齐这些条件,否则同一个数字仍可能有不同解释。
移动端结算页的例子则把「友好」拆成可检查的表现:375 px 宽度下,表单没有横向滚动,每个按钮至少高 44 px,由 Priya 查看 375 px 截图判定。数字让检查有依据,具体的人负责处理视觉判断。
作者还建议每条标准只表达一件事,每个任务保留 2-5 条。前者避免一条要求只完成一半,却无法标记状态;后者提醒你,标准太多时,任务可能需要拆分。这是组织工作的经验建议,原文没有给出证明这个数量最优的对照数据。
限定边界,才能让修改保持可审查
清楚地描述正常流程还不够,作者要求把最关心的边界情况写出来。
例如密码重置链接,要明确覆盖「已过期」和「已经使用」两种状态,并要求展示 This link has expired,提供重新发送链接的按钮,由 e2e check 判定。不能只交代一句「正确处理过期链接」,再等评审时补充遗漏。
另一个容易失控的地方是重构。「清理账单代码」没有停止条件,Agent 可能顺手重命名、调整结构,把两行修复扩成涉及四十个文件的 diff。作者为此写了三道边界:已有账单测试全部通过,由 test check 判定;InvoiceService 只能通过 PaymentClient 访问支付提供商,由 Priya 检查 diff;本次不重命名任何被其他代码调用的名称。
这里既有行为约束,也有依赖关系约束,还有明确的范围排除。评审者因此知道该检查什么,也知道哪些变化不该出现。
同时,所有改动都适用的要求,应该放到统一机制里。比如 lint 通过、第二位工程师完成评审、覆盖率维持要求,可以由 CI 和分支保护执行,不必每张工单重复抄写。工单里的空间留给本次任务特有的结果。
作者提供了一个可以直接套用的模板,用来同时记录结果、判定方和范围:
**Done when**
1. <What will be true>. Decided by the `<check>` check.
2. <What will be true>. <Name> decides, from <evidence>.
3. <What will be true>. Met when the approved <email or post> is sent.

**Not in this job:** <what to leave alone>
最后一行尤其值得保留,它让「哪些东西别动」成为明确约定。第三条用于邮件、帖子等发送类任务,普通代码工单不必凑齐这三种形式。
Agent 写的测试通过了,为什么还不够
作者最有价值的提醒,是测试本身也可能没有验证能力。
重复邮箱注册的例子中,要求不仅包括拒绝大小写不同的已有地址,并返回 That email is already registered,还包括:新测试必须在 main 上失败。前者由 test check 判定,后者由 Sam 根据 Agent 在 main 上的运行记录确认。
原因很直接:当实现和测试都由 Agent 编写时,两者可能共享同一个错误理解。一个测试即使通过,也可能根本没有触及缺陷。
因此,交付报告应该说明执行了什么、观察到了什么。原文给出的报告示例如下:
Ran npm test -- signup on main: "refuses an address that differs only in case" fails (expected 409, got 201). On this branch it passes, along with the other 212 tests.
重点是它同时交代了 main 上预期 409、实际 201 的失败,以及当前分支通过、另外 212 个测试也通过的结果。这是原文的示例报告,文章没有提供可复核的仓库或运行记录,不能把它当成作者公开展示的实验结论。
判定机制也要写准。CI check 名称应与 PR 中显示的一致,包括矩阵任务产生的 test (20) 这类名称;措辞、设计、是否解决客户问题等判断,则交给具名的人。发送类任务另有终点:经过批准的消息实际发出,草稿完成还不算交付。
作者开发的 Arbituro 把这些规则做进了流程:Agent 先提出标准,人逐条接受、编辑或拒绝,确认后才开工。
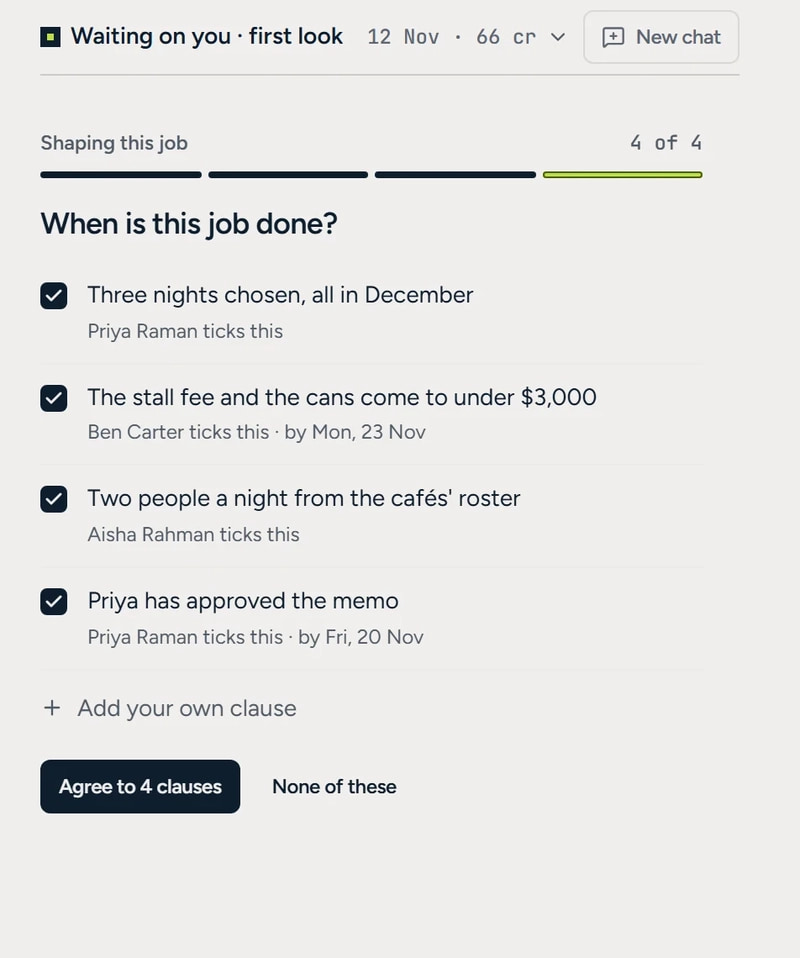
据作者介绍,Arbituro 内置 Agent 和通过 MCP 接入的 coding agent 都会先读取标准。CI 类标准取决于关联 PR 最新提交上的 check 结果;人工类标准中,Agent 只能记录检查证据,由指定的人决定。Agent 不能自行勾选、修改或删除标准;判定人或任务负责人可以说明理由后豁免。
作者还提到通过 MCP 让 Claude Code 处理此类工单的另一篇文章,但本文没有展开接入细节。文末给出的 Arbituro 免费额度是最多三人,这属于产品介绍,也解释了作者为什么特别强调把判定过程结构化。
我的判断
我认同「结果、证据、判定方」这套拆法。相比给 Agent 一段很长的需求描述,它让评审者更容易找到争议所在:是实现不符,证据不足,还是验收标准本来就没写完整。
「新测试在 main 上失败」尤其适合缺陷修复。它比单纯要求增加测试,多检查了一层测试是否能暴露原问题。但它不能证明测试覆盖全面,也不适合机械套到每个新功能上。
文章有些说法需要收窄。比如 Agent 不会提问、会覆盖写明的情况,更适合作为风险提醒。Agent 可以追问,也可能漏掉明确要求;写好标准能减少歧义,不能保证执行可靠。
另外,原文自己的移动端示例把「没有横向滚动」和「按钮至少高 44 px」放在一条里,与「一条只写一件事」并不完全一致。实际采用时,可以把它们拆开,避免部分通过。
作者没有提供采用前后的返工率、评审耗时等对照数据,因此这是一套有说服力的实践建议,还不能据此判断 Arbituro 比现有工单系统更有效。用普通 issue 模板、CI 和明确的评审责任人,也能执行大部分规则;产品额外提供的是判定与变更记录的串联。
能拿来做什么
- 修前端或 Node 缺陷时,先写清触发输入和预期结果,再让 Agent 给出旧代码失败、修复后通过的证据。别只验收「增加了测试」。
- 做页面适配或性能优化时,把「体验好」「速度快」换成视口、尺寸、测试数据和测量口径,并指定由自动检查还是具体评审人判定。
- 让 Agent 重构前,写明本次保留的行为、需要调整的依赖关系,以及禁止触碰的调用名称,给 diff 一个可审查的边界。
- 开工前让 Agent 阅读工单和代码、草拟验收标准,由人确认后再执行。中途发现标准有误时,要求它说明问题并暂停相关工作,由人记录修改理由。