给Agent记忆保留可核查的执行记录
WikiTrace 将每条可复用经验关联到原始执行中的动作和观察记录,供智能体在行动前核查。论文报告,在五个基准的八组测试中,平均得分由仅提供经验时的 87.0 升至 90.2,记忆导致的回归率由 6.5% 降至 4.5%。
AI 深度解读
AI Agent 会把过去任务里学到的经验留给下一次用,但一条看似合理的经验,也可能把原本能做对的任务带偏。WikiTrace 的做法是给每条经验附上出处,让 Agent 在照做之前,回看当时执行了什么、观察到了什么。
作者在 5 个基准的 8 套测试中发现,能查出处的版本平均得分更高,也更少做错原本能做对的任务。如果你在给编程 Agent 加跨任务记忆,这篇研究提供了一个值得借鉴的设计和一套评估办法。
为什么一条有用的经验也会把任务带偏
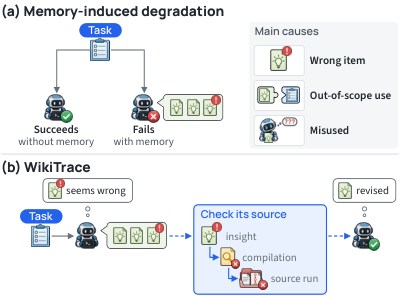
经验是从某次任务里提炼出来的,提炼时容易丢掉适用条件。比如,编程 Agent 记住了「遇到构建失败就清缓存」,下次碰到相似报错,很可能直接照做。但上次真正解决问题的动作,也许是切回了项目要求的 Node 版本。只有一句结论时,Agent 很难看出这两件事的区别。
WikiTrace 给每条可复用经验关联两份材料:来源运行的简短摘要,以及原始的行动与观察记录。摘要交代当时发生了什么,原始记录则保留 Agent 做了什么、每一步返回了什么。Agent 可以在采取行动前回看证据,发现旧经验和当前任务对不上时,再修正判断。
平均分涨了,原本会做的题丢了多少
在 5 个基准的 8 套测试里,WikiTrace 平均得分 90.2,无记忆组是 79.5,Insights Only 是 87.0。Insights Only 拿到同样的经验,但无法查阅来源。WikiTrace 是参评记忆方法中唯一在每套测试上都达到或超过无记忆组的方法。
作者还单独算了回退率(Regression),也就是无记忆时能做对、换一种设置后却做错的任务比例。WikiTrace 的回退率是 4.5%,Insights Only 是 6.5%。无记忆设置自己再跑一遍,回退率也有 9.7%,说明重复运行本身就可能做丢一些任务。相较于这个无记忆重跑基线,WikiTrace 的收益(Gain)高出 35 个百分点。这衡量的是另一面:原先没做对的任务,有多少后来做对了。
我的判断
最有说服力的是 WikiTrace 和 Insights Only 的对照。两边拿到同样的经验,但能查来源的一组得分更高、回退更少。这比单看有记忆组和无记忆组的分差,更能回答「出处有没有用」。回退率也值得单独看,平均分上涨时,仍可能有一批旧任务被做坏。
工程上,只存经验摘要更轻,维护和检索都更简单。加上来源记录后,实际收益取决于记录是否完整、Agent 能否找到相关步骤,以及回查要花多少时间和上下文。原文摘要没交代这些成本,也没给出不同模型或日志质量下的对照。实验支持这套方法在所测任务里有效,应用到日常编程工作流,收益还要用自己的任务验证。
能拿来做什么
- 给编程 Agent 保存构建排障经验时,顺手关联来源运行的摘要、实际执行过的命令和对应输出。下次遇到相似报错,可以先确认上次是哪一步之后结果才变了。
- 把团队里反复出现的构建、测试失败做成一小组评估任务。用同一批任务比较无记忆、只给经验摘要、允许回查来源三种设置,分别记录新做对和原本做对却失败的任务。
- 无记忆组也重复跑一遍。这样遇到任务回退时,手里有一组参照,可以先看同一设置重复运行会波动到什么程度。