AI 编程项目失控的十二类常见问题
文章整理 202 项公开研究材料,归纳出理解债务、交付停滞、上下文丢失、回归反复和安全遗漏等十二类问题。这是针对公开案例的目的性综述,各类来源的覆盖数量不能当作故障发生率。
AI 深度解读
AI 能把界面和基本流程很快搭出来,却未必能让项目顺利上线、持续迭代。这篇文章梳理了 202 项公开研究材料,归纳出 12 类反复出现的问题:上下文丢失、修复引发回归、权限缺失,以及代码能运行却没人敢改。
作者的核心判断是:生成代码变容易了,工程决策的责任还在。对前端和全栈开发者,这份材料最有用的地方,是提醒我们把验收重点从「页面做出来了」,提前转向「后续能否安全修改、可靠交付」。
为什么能跑的项目,反而越来越难改
作者把「理解债」放在了突出位置:项目今天运行正常,但开发者已经无法可靠解释各部分为什么这样连接,也无法预测一次修改会影响哪里。
它通常不是某次生成造成的。每次让 AI 加功能,看起来都完成了任务;积累下来,命名逐渐分叉,相似逻辑重复出现,依赖不断增加,却没人记录引入理由。等到调整数据结构或重构公共模块,原先隐藏的耦合才一起暴露。
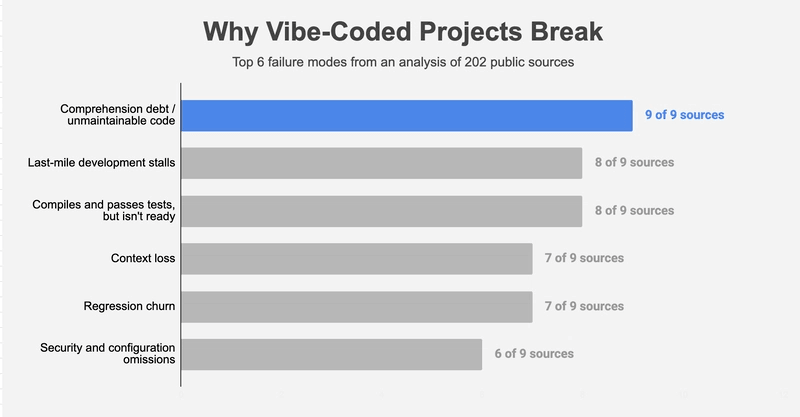
这里还有一个放大器:AI 编程助手掌握的项目上下文有限。它能检索文件、读取片段,但未必知道上周为什么保留某个兼容分支,也未必看到了所有调用方。上下文压缩还可能丢掉这些决策。
于是,修复当前错误的改动,可能覆盖之前的修复;局部正确的字段调整,也可能破坏其他服务。作者引用的 Claude Code issue 10727,就涉及自动压缩后上下文丢失和循环问题。
项目能运行,只证明当前路径走通了,不能证明下一次修改仍然可控。
作者认为,大范围改动、未记录的依赖关系和缺失的测试,会让这种回归循环更容易发生。这是合理的机制解释,但原文没有给出这些因素分别增加多少风险的对照数据。
最后的 20%,为什么不能留到最后
文章所说的「80% 墙」,指的是原型阶段进展很快,临近上线却发现剩余工作越来越难估算。
界面和基本流程很适合快速生成。真正投入业务使用后,权限、支付、数据迁移、错误处理、部署、恢复和安全测试才开始决定系统是否可靠。并非每个原型都需要全部能力,但需要时,它们往往会影响整个设计。
例如,权限模型如果一直没有确定,后补时就可能同时修改查询、接口和界面交互。此时所谓的最后 20%,包含了对前面实现的返工。原文的 80% 和 20% 是阶段性描述,不能当成经过测量的工时比例。
安全问题更能说明这个差别。原文引用 CVE-2025-48757:研究者检查的 1,645 个 Lovable 生成应用中,有 170 个存在数据库行级安全策略(Row Level Security,RLS)不足的问题。RLS 用来约束不同用户可以读取或修改哪些数据;按钮是否隐藏,不能替代数据库里的访问限制。
另一项 UpGuard 调查发现,超过 16,000 个使用 Supabase 的站点暴露了可读取的数据表。作者明确说明,这些站点并非全部由 AI 构建,因此不能把它们都算成 AI 事故。
Replit 的数据库删除事件则指向操作边界:Agent 一旦能够接触生产数据,错误就可能直接变成数据损失。原文将开发与生产环境隔离不足列为相关问题,但没有提供足够细节来复盘完整原因。
这些案例支持的是一个具体结论:界面验收之外,还必须单独验证数据访问权限、密钥保护和 Agent 的操作范围。
写得更快,为什么未必交付得更快
原文引用的几组数据,需要分开理解。
2025 Stack Overflow Developer Survey 中,84% 的受访者已经使用或计划使用 AI 工具,但 46% 主动不信任输出的准确性。Harness 的另一项调查里,67% 的开发者表示,调试 AI 代码花费的时间超过预期。使用意愿、信任程度和实际效率,回答的是不同问题。
交付指标也没有自动跟上生成速度。Google 的 2024 DORA 报告发现,AI 采用程度增加 25%,与交付吞吐量估计下降 1.5%、稳定性下降 7.2% 存在相关关系。这里是相关性,不能直接推导为 AI 导致交付变差。
GitClear 分析了 2.11 亿行代码,发现复制代码增加、重构相对减少。这个结果提示了维护压力,却不能单独证明每份新增重复代码都由 AI 造成。
更直接的证据来自 METR 的 2025 年受控研究:16 名有经验的开源开发者,在熟悉的仓库完成 246 项任务,使用 2025 年初的 AI 工具后,平均耗时增加 19%,尽管他们原本预期会提速。原文同时提醒,2026 年 2 月的更新提示新工具可能表现更好,不能把旧实验直接套到所有当前工具和任务。
作者还引用 Fastly 的 2025 年调查:拥有 10 年以上经验的资深开发者,让 AI 生成超过一半已交付代码的可能性,是初级开发者的两倍以上。但「因为他们更善于审查和纠偏」是作者的解释,调查比例本身并没有证明原因。
AI 缩短了部分代码的编写时间,审查、验证和承担结果的工作仍然需要有人完成。
我的判断
这篇文章最有价值的地方,是把失败放回了完整交付流程。开发者遇到的麻烦,可能来自需求模糊、边界缺失,也可能来自模型出错、平台故障。只换模型,未必能解决前一类问题。
它的证据边界也很清楚:作者经过 10 轮检索,从 9 类来源收集 202 项材料,这是有目的地寻找公开经验,并非随机抽样。不同报道可能讨论同一事件,个人吐槽、受控实验和安全披露的证据强度也不同。「覆盖 9 类来源」只能说明问题出现在多类材料中,不能解释为所有项目都会遇到。
审计完整性还有缺口。正文直接引用 14 个来源,附录所指向的研究报告列出 95 个链接,剩余材料没有逐项公开。读者无法仅凭这份附录独立复核整个材料集合。
因此,我会把它当作风险地图,不会用它估算 vibe coding 的失败率。作者提出的小步修改、频繁提交、行为测试、生产隔离,都有清楚的工程理由;但文章没有对比不同工作流的效果,具体收益仍属经验之谈。
作者也提到自己正在开发规划工具 Zalcro。提前明确约束值得采纳,是否需要专门产品承载,原文没有提供比较证据。对一般团队,一份简短的设计说明、清晰的任务范围和必要的自动化检查,就可以先开始。
能拿来做什么
- 在让 AI 开始实现前,先写清数据模型、角色权限、服务依赖和完成标准。涉及登录、支付或多用户数据时,把访问规则放进任务要求,避免等界面完成后再补。
- 给 Cursor 或 Claude 的任务限定修改范围和验收行为,每完成一个可验证的小改动就提交版本。让 Git 保存可靠的回退点,别把连续聊天记录当成唯一的项目记忆。
- 验证前端与接口时,把失败路径一起列出来,例如越权读取、请求失败和异常输入。按照原文「测试行为」的原则检查结果,页面外观正常只能完成部分验收。
- 将规划、实现、审查分成独立步骤,并隔离开发与生产环境。Agent 接触线上数据前保留人工审查,把误操作的影响限制在可恢复范围内。