Agent 跨服务失败后,如何补偿已完成操作
文章用离职流程说明:Agent 调用多个微服务时,后续步骤超时可能留下部分完成状态,整体重试又可能造成重复扣款。作者据此引出开源 SAGA 补偿代理,强调进程内校验无法解决外部服务的状态一致性。
AI 深度解读
AI Agent 把离职流程跑到第三步,邮件服务超时退出,前两步的账号停用和财务扣款却已经生效。此时再让它重试,可能把故障变成重复扣款。问题出在跨服务操作缺少统一的失败收尾机制。
作者为此开发了 AgentSaga-Gateway:把请求校验、风险拦截和补偿执行移到独立网关,用持久化日志记录每一步。它提供了一套可运行的 REST 示例和 2,800 次工作流测试,但距离证明生产环境中的事务可靠性,还有几个关键问题需要回答。
为什么参数合法,业务还是会跑坏
原文用员工 EMP-00104 的离职说明问题:HR Service 先将其设为 INACTIVE 并撤销登录权限,Payroll Service 再记录 25,000 LKR 的设备结算扣款,Notification Service 最后发送离职确认邮件。
假设第三步的 SMTP 中继返回 HTTP 504 Gateway Timeout,Python 或 TypeScript 进程捕获异常并退出,前两个服务已经提交的数据不会自动恢复。重新执行整项任务,还可能重复记账。
Pydantic、Guardrails AI、NeMo Guardrails 所承担的参数校验或运行时约束,不能单独解决这个问题。判断请求字段是否正确,与知道哪些远端操作已经提交、应该调用什么接口撤销,是两件事。
作者选择了 SAGA:每个服务先提交自己的操作,后续失败时,再执行对应的补偿操作。例如冲销结算记录、恢复员工状态。
补偿是新的业务操作,不是把所有数据库恢复到同一个历史瞬间。
这也决定了适用范围:停用账号可以恢复,邮件发出后却无法收回。流程必须明确哪些操作允许补偿,哪些操作一旦执行就难以撤销。
网关怎样知道该撤销哪笔扣款
AgentSaga-Gateway 使用 TypeScript / NestJS,结合 OpenAPI 3.1、Ajv 和 PostgreSQL 16,采用 Apache 2.0 许可证。Agent 的工具请求统一经过 /proxy/...,携带三个关联头:x-saga-workflow-id 标识流程,x-saga-step-index 标识步骤,x-agent-id 标识调用方。
补偿规则放进 OpenAPI 的 x-agentsaga-* 扩展。下面这段声明解决的是「结算成功后,应该怎样撤销」:
/api/v1/payroll/settlement:
  post:
    summary: Execute employee settlement deduction or payout
    operationId: executeSettlement
    x-agentsaga-action-type: compensatable
    x-agentsaga-risk-level: high
    x-agentsaga-compensating-action:
      path: /api/v1/payroll/settlement/{settlementId}/reversal
      method: POST
      mapping:
        settlementId: "$.response.body.settlementId"
        reason: "Automated SAGA rollback due to downstream workflow abort"
关键是 settlementId: "$.response.body.settlementId":这个 ID 在调用前不存在,要等 Payroll 返回 HTTP 201 Created 才能拿到。
网关保存 forwardPathParams 和 forwardResponseBody。第三步失败后,它通过 JSONPath 绑定提取结算 ID,先调用 POST /api/v1/payroll/settlement/{settlementId}/reversal,再调用 POST /api/v1/hr/employees/EMP-00104/status,提交 {"status":"ACTIVE"},最后返回包含补偿明细的 HTTP 502 审计报告。
网关还会保护被标记为 pivot 的操作,也就是流程中难以撤销的关键动作。转发前必须满足两个条件:工作流不处于 FAILED、COMPENSATING、COMPENSATED 状态;所有更早步骤都已在日志中标为 EXECUTED。否则返回 HTTP 409 Conflict,阻止失败流程继续发邮件。
原文声称共有三类动作语义,但给出的正文只明确展开了 compensatable 和 pivot,第三类没有说清。另外,这两个条件也不足以单独证明重复邮件或重复扣款已被全面防住,仍要看幂等控制和并发处理。
拦截很快,持久化成本也要算进去
请求到达上游前,要依次通过契约校验、风险策略、流程状态检查和追加式 SAGA 日志。
ContractRegistryService 在启动时预编译路径参数与请求体的 Ajv 校验器,并设置 coerceTypes: false。因此,字符串 "5000" 不会自动变成数字;虚构枚举 "BITCOIN"、非法路径 ID BAD_ID 会被拦截并返回 HTTP 400。
接着由 PolicyEvaluatorService 执行策略:拒绝 untrusted-、blocked- 前缀的身份;金额超过 POLICY_MAX_AMOUNT,默认 500000,必须携带 x-agentsaga-approval-token;标为 x-agentsaga-risk-level: critical 的接口也需要该令牌,否则返回 HTTP 403。
作者提供了 docker compose up -d --build 启动方式,包含 PostgreSQL 16、三个 Express 微服务和 NestJS 网关,宿主机端口为 5433、3010、8090。可用 curl http://127.0.0.1:8090/health 检查状态,再通过 x-simulate-failure: notification 注入第三步故障。
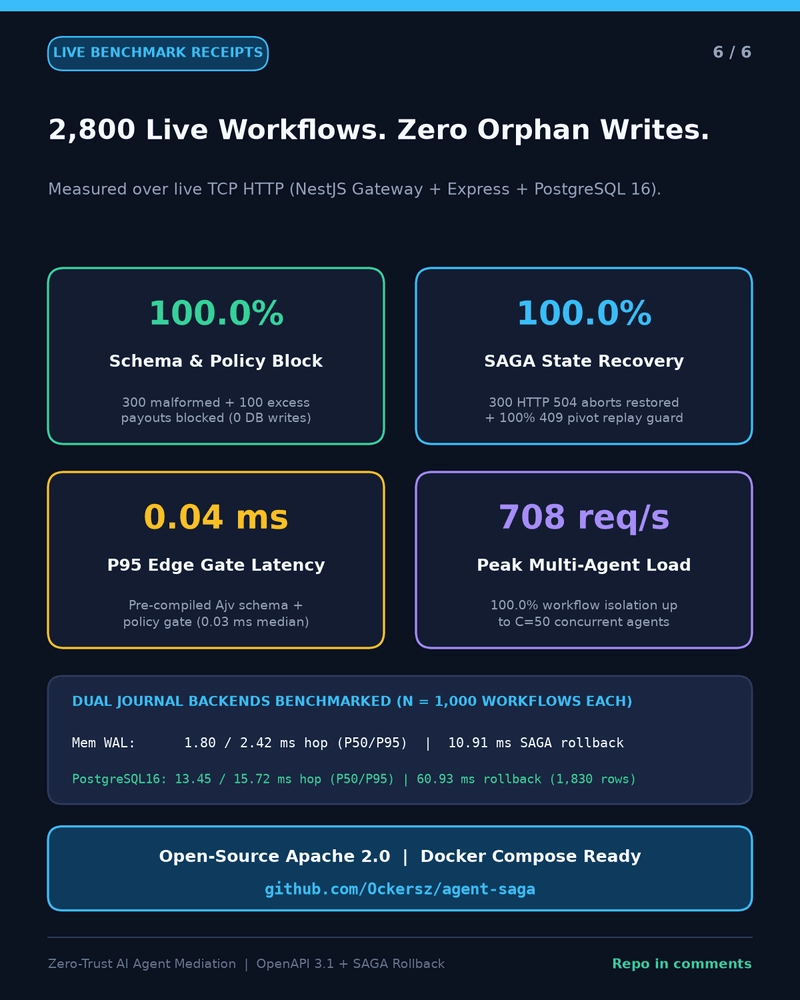
测试使用真实回环 TCP,并通过 GET /api/v1/state 审计下游状态。两个后端各执行 1,000 条流程,每组包括 300 条正常流程、300 条类型或契约错误、100 条金额越限,以及 300 条第三步 504 中止和 pivot 重放尝试。越限样本是 750,000,大于阈值 500,000。
作者报告,两种模式的校验与策略拦截 P95 均为 0.04 ms,因为无效请求不写 PostgreSQL;单节点 PostgreSQL 16 的同步 ACID 持久化,为每个正向步骤带来约 11.6 ms 的 P50 成本。原文用 1.5–4 秒的 LLM 单轮耗时作比较,认为这一成本较小。
SQL 审计还记录了含预热在内的 310 条已提交流程、300 条已补偿流程和 1,830 条步骤记录。另有 800 条并发测试,在每个 worker 档位执行 200 条,正常与故障各占 50%,涉及 EMP-10000..EMP-10199;作者报告没有跨流程数据串扰,也没有多发确认邮件。但正文没有列出具体 worker 数量和吞吐曲线。
我的判断
我认可把补偿执行放到独立基础设施里的方向。业务接口的撤销语义由服务方声明,Agent 不必每次临场决定如何收尾;持久化日志也比进程内变量更适合追踪跨服务状态。
不过,日志持久化不等于已经消除了跨服务故障窗口。
如果 Payroll 已经提交扣款,响应却在途中丢失,网关可能连 settlementId 都没拿到。此时如何查询结果、判断是否重试,通常需要业务幂等键、状态查询或可靠消息等机制配合。原文没有解释这个窗口,也没有说明补偿接口再次失败时怎样恢复和告警。
第三步超时同样不代表邮件一定没发出。测试中的故障注入是否覆盖「邮件已发、响应丢失」,原文没有交代。PostgreSQL 日志有助于崩溃恢复,但网关重启后由谁扫描未完成流程、怎样避免重复补偿,也不能只靠 WAL 推导出来。
身份与审批也有前提:x-agent-id 的前缀过滤无法代替身份认证,审批令牌如何签发、验证、绑定金额和请求,正文没有展开。网关还必须确实处于调用必经路径上。
相比在每个 Agent 里散写 try/catch,这套方案更集中、更容易审计;相比已有的持久化工作流引擎,它的长期恢复、重试和人工接管能力仍需核查。作者没有给出替代方案对照数据,2,800 次测试支持的是给定 REST 场景下的演示结果,尚不能覆盖生产可靠性。
Kafka、gRPC、MCP Bridge 和关键操作的影子沙箱路由都还在路线图中,不能当作现有能力。
能拿来做什么
- 给 Node 或全栈 Agent 接业务 API 前,先列出每个写操作的补偿接口、所需返回字段,以及补偿失败后的处理方式,特别检查扣款和权限变更。
- 测试时加入「上游已提交但响应超时」「同一步重复调用」「补偿调用失败」「网关中途重启」,并查询最终业务状态,不能只检查 HTTP 返回码。
- 把发邮件等难以撤销的动作放到已满足前置条件的位置,同时核查业务幂等机制;步骤编号只能说明顺序,不能直接代替防重。
- 评估现有 Node 编排服务时,先检查是否已有持久化执行、恢复和审计能力,再决定复用原有设施还是引入独立网关,减少两套流程状态并存的维护成本。