AI 写码变快后,架构维护为何更难
作者结合日常使用编程 Agent 的经验,指出功能交付的主要成本并非敲代码,生成量增加还可能加重维护负担。文章以绕过统一门面直接调用外部 API 为例,讨论如何通过检查约束架构偏移。
AI 深度解读
原本排期一个月的功能,用上 AI 就该两天交付吗?作者每天使用 coding agents,却认为这个预期算错了账:代码输入变快了,数据建模、架构约束、设计统一和验收并没有同步提速,生成的代码越多,审核工作还可能越重。
这篇值得读的地方,是作者给出了具体做法:把团队约定变成 lint、类型和 CI 能检查的规则,再把交付时间拆开估算。它提供的是一套管理 AI 产出的方法,并没有证明所有团队都能获得某个固定倍数的提效。
为什么功能能跑,代码库却越来越难维护
让 agent 开发一个需要外部数据的功能,它可能直接调用接口,绕过项目已有的 API client。多做几个需求,就多出几套 HTTP 请求、重试逻辑和错误格式。单看每个功能都能工作,放在一起却难维护。
作者先在 AGENTS.md 或 CLAUDE.md 中列出已有客户端,并要求 agent 在 plan mode 里先说明准备复用哪个,再开始改代码。但他也发现,长会话中的文字约束会逐渐失效。原文引用的社区案例甚至出现了「找过现有代码,仍然选错函数」的情况。
因此,规则需要落到工具上。例如,约定外部 HTTP 请求只能经过 src/services/clients/,在其他位置使用 fetch 或导入 axios 就报错。
下面是原文的 ESLint 配置草图,用来限制请求入口:
// eslint.config.js
export default [
  {
    rules: {
      "no-restricted-globals": ["error", { name: "fetch", message: "Use the API client in src/services/clients." }],
      "no-restricted-imports": ["error", { paths: [{ name: "axios", message: "Use the API client in src/services/clients." }] }],
    },
  },
  {
    files: ["src/services/clients/**"],
    rules: { "no-restricted-globals": "off", "no-restricted-imports": "off" },
  },
];
要看第二个配置对象:它给客户端目录开放了例外,否则真正负责请求的代码也会被拦住。要让违规阻断交付,还得把 lint 接进构建或 CI。
这份配置只是草图,不能自动识别所有请求方式,也无法判断某个业务封装是否重复。作者因此把代码审查的第一个问题改成了「这个能力是不是已经存在」。
功能测试通过,不代表项目没有长出第二套相同的基础设施。
数据库里的默认约定,不能只存在于团队脑子里
建表时,agent 往往只添加需求明确提到的字段。团队习惯每张表都带的标准列,如果没有写进上下文,就可能被遗漏。
原文引用 Claude Code 仓库在 2026 年 7 月的 issue #75333:模型根据可推断的信息生成 CREATE TABLE,部署后才暴露字段缺失,同一数据类型甚至反复出现 4-6 次问题。这是一个问题报告,不能据此推断所有 agent 的出错频率。
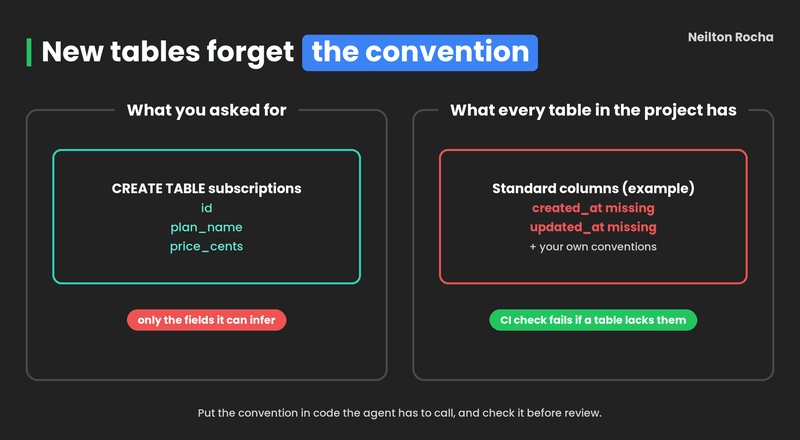
作者的处理分两层。执行前,提供字段约定和一张已有表作为样例,并人工阅读每份 migration。长期则把公共字段放进基础模型或迁移辅助函数,让 agent 复用,再用 CI 检查结果。
下面的 Postgres 查询会找出 public schema 中缺少 created_at 的普通表:
-- 如果 public schema 中有表缺少 created_at 列,则检查失败
SELECT t.table_name
FROM information_schema.tables t
WHERE t.table_schema = 'public'
  AND t.table_type = 'BASE TABLE'
  AND NOT EXISTS (
    SELECT 1 FROM information_schema.columns c
    WHERE c.table_schema = t.table_schema
      AND c.table_name = t.table_name
      AND c.column_name = 'created_at'
  );
要注意 c.column_name = 'created_at':它只验证这一列是否存在,不检查类型、默认值或其他标准列。查询本身也不会让 CI 失败,需要执行脚本在返回记录时判定失败,并把表名反馈给 agent。
这里的价值是让遗漏尽早暴露。约定从「记得遵守」变成「漏了就过不了检查」,才更容易持续执行。
页面风格为什么不能靠一份说明书统一
设计一致性是作者认为最难处理的部分。原文引用一位开发者的反馈:已经做了 skill,多次修改 CLAUDE.md,Claude Code 仍然无法稳定遵守 Figma 规范。
作者采用的办法,是给 agent 一张已经完成的页面作参照,每个新页面都和它比较。原因很直接:agent 会模仿附近的实现,一个具体样例比一页抽象要求更容易照着做。
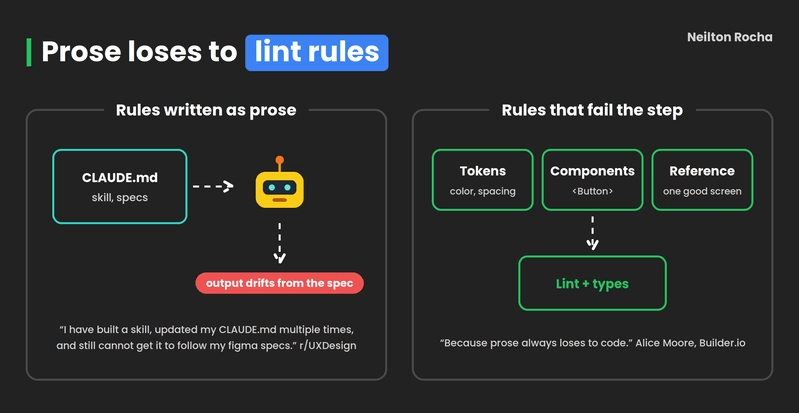
能机械检查的部分则交给工具:颜色、间距使用具名设计令牌(design tokens),组件内出现十六进制色值就报错;功能目录使用项目的 <Button>,限制直接使用原生 <button>。
但检查能力有边界。作者曾把自己的文章写作规则做成检查脚本,发现它能检查形式,却判断不了事实真假。同样,页面全部使用正确 token,也不能保证信息层级、交互和视觉效果就合理。
规则能守住一部分一致性,参考页面和人工验收仍然有用。原文没有给出这套方法对 Figma 还原度的量化结果。
一个月能缩到多久,要把时间拆开算
作者引用的 r/cscareerquestions 讨论有超过 50 条回复,参与者对提效幅度没有一致答案。有人质疑管理层期待的 2x、5x、10x;Sean Goedecke 在 2025 年 7 月 17 日的文章中,则把管理层期待的稳定 10x 与自己获得的 1.5x 作了对比。
另一条社区回复称,简单功能可以感觉像 10x 提效,碰到 AI 处理不了的问题,却可能比自己完成多花约 50% 时间。这些都是个人经验,不是可直接用于项目排期的统计结果。
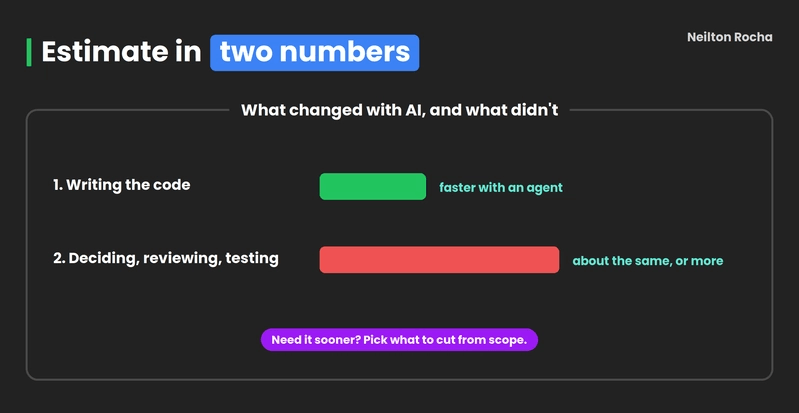
作者建议把排期拆成三部分:代码编写是 [X days],数据模型、API 边界和页面决策是 [Y days],审查与测试是 [Z days],总计 [X + Y + Z]。
这样讨论,才能看清 AI 到底压缩了哪一段。如果交付日期必须提前,就进一步列出可以删减的范围,让需求方在时间与范围之间选择。
原文结尾又将估算概括成「编写与决策」两个数字,和前面的三项模板略有区别。实际沟通时保留审查与测试这一项更清楚,尤其作者自己就认为它可能增加。
我的判断
我赞同把约定写进可执行检查。它给 agent 提供了明确的错误反馈,也让人工审查能够把精力放到工具判断不了的问题上。相比反复加长提示词,这套方法的结果更容易验证。
但它有前提:团队得先知道自己要守什么规则,代码库里也要有值得复用的客户端、迁移工具和参考页面。已有实现如果混乱,要求 agent 照着复用,并不会自动改善质量。
规则也需要控制范围。比如上面的 ESLint 草图直接关闭了客户端目录中的两项限制;项目原本若有其他导入约束,照抄就可能影响它们,需要结合现有配置调整。
这篇给出的是有操作价值的工程经验,不是 AI 提效倍数的证明。
作者没有提供前后交付周期、缺陷率或审查耗时的对照数据。我们可以采用他的检查方法,却不能据此断言「一个月绝对做不到两天」,也不能承诺加入 lint 后就能获得固定收益。
能拿来做什么
- 下一个涉及外部接口的前端或 Node 需求开始前,先把现有 API client 的位置告诉 agent,要求它在计划里说明复用对象,再把明确的目录边界接入 lint。
- 让 agent 修改数据库前,提供一份合格 migration 和标准字段约定;执行前阅读变更,对能机械判断的遗漏补上 CI 检查。
- 生成新页面时,指定一个已验收页面作为参照,并明确 token 和组件入口;验收时继续检查交互与视觉效果。
- 估算 AI 参与的需求时,分别报出编写、决策、审查与测试的时间;如果期限压不下来,同时给出具体可删减的功能范围。