财务 AI 如何让每个数字都能追溯
OfinTech Desk 将财务计算交给确定性代码,要求每个展示数字都能关联计算过程、账本记录及原始文档页码。无法提供完整来源链的数字不会出现,计算逻辑也可按普通函数进行测试。
AI 深度解读
OfinTech Desk 给财务 AI 划了一条边界:数字交给确定性代码计算,有限选项交给小分类器判断,LLM 只负责解释。作者想解决的不是报表写得好不好,而是每一个数字被追问时,都能找到计算过程和原始凭证。
这套分工对做 AI 应用的程序员很有参考价值:先确定哪些结果必须可验证,再决定模型能参与哪一步。不过,文中的速度和准确性说法,也需要区分架构设计与实验依据。
数字可信,靠的是能一路查回原件
作者接触过的财务团队,总会问同一个问题:这个数字从哪里来?
LLM 可以流畅地写出月末总结,但如果里面的金额也是它生成的,解释再自然,也无法替代计算依据。OfinTech Desk 因此要求,用户点击任意数字,都能沿着一条链往回查:生成数字的计算、参与计算的账本行,以及原始文档里的准确页码。无法展示这条链的数字,就不出现。
这就是数据溯源(provenance)。大白话解释,它要求系统既交付答案,也保留足够的证据,让人重新检查答案。
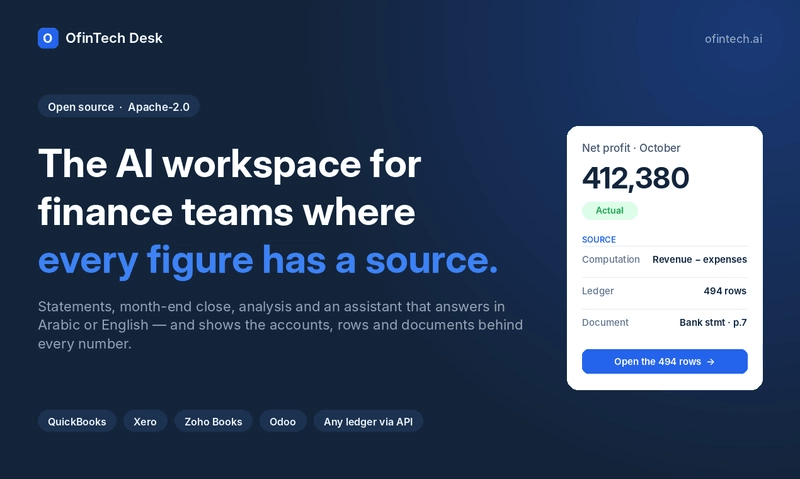
这个要求会反过来约束产品设计。前端不能只拿到一段总结文本,还需要能够呈现计算依据和来源位置。后端也不能算完一个总额就丢掉中间关联,否则「点击查看来源」只能停留在界面上。
三层各管一件事,LLM 放在最后
第一层是确定性代码,负责报表、月末结账、关键绩效指标(KPI)和增值税(VAT)申报数字。相同输入得到相同结果,不涉及采样或 temperature。作者强调,KPI 可以写成函数,再用单元测试验证。
确定性保证的是结果可重复。账本录错了、计算规则写错了,代码仍会稳定地给出错误答案,因此来源校验和业务规则测试依然必要。
第二层处理有限选项里的判断,例如将银行流水匹配到支付服务商的结算款。团队为此训练了一个小分类器,称为 Ofin model。它输出选项及概率,由人工设置自动接受匹配的阈值。
这类任务的候选答案事先确定,不必让生成模型自由发挥。分类器还会利用团队接受、拒绝匹配的记录继续学习。作者称第二个月会比第一个月更准确,但没有给出准确率、样本量或对照结果。
第三层才是 LLM。它读取数字及来源,用 Arabic 或 English 解释结果,不负责生成数值。按作者的设计,更换 LLM provider、使用本地模型,甚至完全不用模型,计算结果都保持一致。
值得借鉴的是,计算结果的正确性不依赖解释模型的选择。
不过,原文没说明怎样防止 LLM 在解释时抄错数字、补出新数字,或写出来源不支持的因果关系。「只允许解释」是一条职责约定,还需要输出校验来落实。
小模型和只读接入,让部署边界更清楚
作者希望系统运行在企业现有的普通服务器上,因此刻意缩小分类器。文中给出的性能是:在 2 核 CPU 上,标注一条银行流水约需 0.03 ms,处理 500 页银行对账单不到 1 秒,利用团队决策记录重新训练约需 0.3 秒,全程不需要 GPU。
这些是作者报告的数据,但没有交代硬件型号、测试集、每页记录量,也没说明 500 页处理是否包含文件解析或 OCR。不能把它直接理解为任意银行 PDF 的完整处理耗时。
OfinTech Desk 还选择与现有记账系统并存:只读连接 QuickBooks Online、Xero、Zoho Books 和 Odoo,或者从 Excel、CSV 导入总账。它不能修改账本,也不能转账。这样既减少了误操作的影响,也让权限范围更容易被审查。
作者称系统运行在自有服务器,数据不离开企业网络;同时又允许选择任意 LLM provider。若采用外部模型服务,哪些数字和来源会被发送出去,原文没有说明。数据留在内网的承诺,需要结合实际部署方式判断。
项目核心以 Apache-2.0 免费开源,支付结算对账属于付费层,用于支持项目运营。
我的判断
我认同它把可验证的计算与语言解释分开。相比让 LLM 直接读取账本并生成整份报表,这种设计更容易复算、测试和定位问题,也让替换模型的成本更可控。
小分类器则有适用前提:候选集合要清楚,团队要持续提供可靠的接受、拒绝记录。模型输出概率,也不等于概率已经校准;一个标成高置信度的匹配到底有多可靠,还需要验证集检验。
对于规则稳定、选项很少的任务,规则匹配可能已经够用。对于例外较多的流水匹配,小分类器有吸引力,但作者没有提供它与规则系统或大模型的对照数据。「更快、更便宜、更易审计」目前主要是作者的经验判断。
能拿来做什么
- 做财务报表或对账页面时,让数字关联计算依据、账本记录和文档页码,使用户能够从结果继续查证。
- 在 Node 服务中,把金额、税额和 KPI 计算封装为可独立测试的函数,再把结果与来源交给 LLM 生成说明。
- 做银行流水匹配时,为低置信度结果保留人工审核入口,并积累接受、拒绝记录,再评估分类器是否优于现有规则。
- 接入 AI 助手时,先采用只读权限;若要求数据留在内网,同时检查解释模型的调用路径和实际发送内容。