桌游评分扎堆五五开,换模型后恢复区分度
作者用 Python 采集桌游资料和评论,再用模型提取评分并生成静态站点。首批约 80 个页面里,本地 Qwen 3.5 9B 几乎总把运气和技巧各打 50 分,改用 Gemini 3.5 Flash-Lite 后解决了这个问题。
AI 深度解读
桌游对比站 Tabletop Dev Labs 用本地 Qwen 3.5:9B 跑了约 80 个页面,发现重策略桌游和轻量掷骰游戏几乎都被评成「50% 运气 / 50% 技巧」。作者改用 Gemini 3.5 Flash-Lite,把库里的 99 款游戏全部重评,分数终于拉开了。
这个案例适合做 AI 数据管线的前端和全栈开发者看。JSON 能过校验,页面也能正常构建,但如果模型总把分数打在中间,下游的对比条、FAQ 和简短结论都会跟着失去区分度。
为什么一个 50 分会拖垮对比页
为了把托管成本维持在 $0,作者把整站做成由 JSON 驱动的静态站。Python 抓取桌游元数据和社区评论,模型按严格的 JSON schema 提取优缺点、适合谁玩、雷达图评分,以及一个 0–100 的整数 luck_vs_skill。雷达图有 5 个维度,分别是烧脑程度、准备麻烦程度、伤友情程度、聚会氛围和重玩价值。
Astro 在构建时生成 /games/[slug]/ 单品页和 /compare/[game-a]-vs-[game-b]/ 对比页。代码推到 GitHub 后,Cloudflare Pages 自动构建。对比页靠两款游戏的分差画图、生成结论,因此单页上看似合理的中间分,成批出现时就会让对比条看起来一模一样。
作者在桌面 GPU 上跑 Qwen 3.5:9B 时,优缺点摘要和 JSON 格式都能交差。问题出在打分上。几乎没有随机性的重度德式桌游拿到 50/50 或 45/55,掷骰和赌运气的轻量游戏也在 50/50 附近。作者把这种反复往量表中点打分的现象称为「中心趋向偏差」。
换模型后,评论里的哪些线索用上了
作者把推理后端切到 Gemini API,使用 Gemini 3.5 Flash-Lite 重评全部 99 款游戏。据他观察,新模型更能结合评论语境判断随机性和玩家决策各占多少。随机抽牌会引入不确定性,「骰运可缓解」则要看玩家有哪些手段应对坏结果。评论提到「确定性优化」或「没有隐藏信息」时,分数会明显向技巧一侧移动。
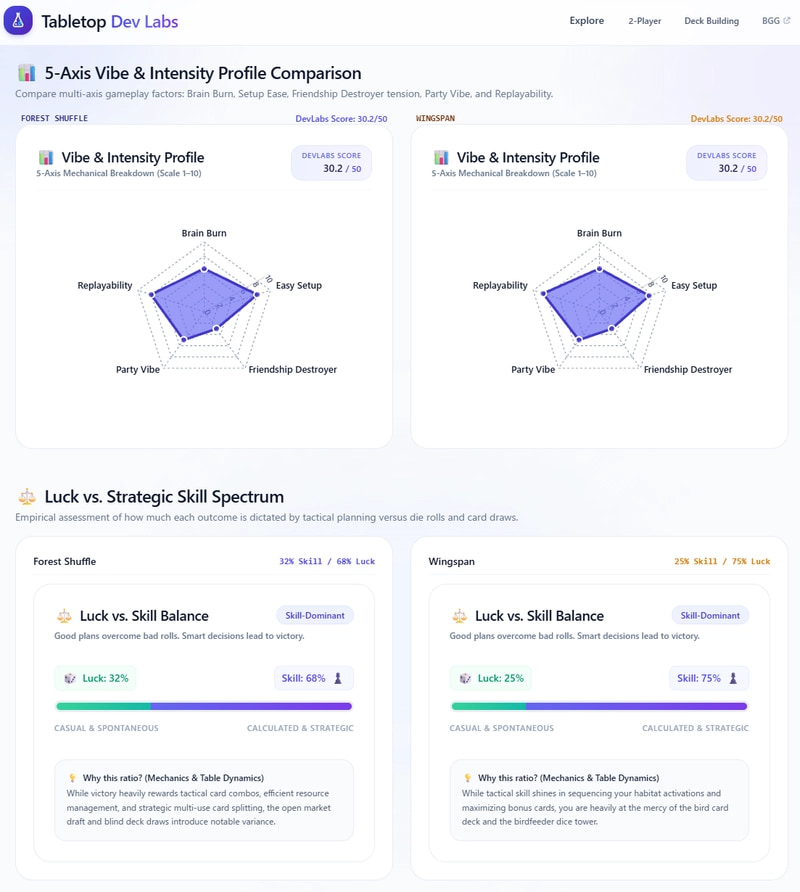
按作者的描述,拉开分差后,Astro 模板生成的 FAQ 和「Quick Verdict」也更能体现具体差异,例如 The Crew: Mission Deep Sea 与 Planet Nine 的对比页。评分 JSON 独立于前端生成,所以这次全量换分只用了一次批处理和一次 git push。
我的判断
作者实际跑过两套后端,观察到换模型后分数更分散,对比页也有了更多可写的差异。但原文没给出 99 款游戏的完整分布、人工评分基准、重复运行结果或 API 账单。分数拉开说明页面有了区分度,离证明每个分数更准确还有一步。FAQ 变得更具体,也只能说明页面内容变了,搜索排名和流量有没有变化,原文没交代。
作者提出本地 8B–9B 模型适合抽取发售年份、人数和标签,这可以当作选型经验。少样本校准和成对排序同样是原文提到的备选,但作者没有给出对照数据。如果产品只关心「A 比 B 更吃运气」,可以直接测成对排序。如果每个单品页都要展示可横向比较的 0–100 分,就得进一步检查同一套评分标准能否跨样本、跨批次保持一致。
能拿来做什么
- 给 Astro 的构建前检查加一项评分分布统计,跑完批次就看 50 分占比、分数直方图,以及对比页里有多少组分差为零。
- 从现有数据里挑出几款低随机性、强随机性和处于中间的桌游,由人工先标相对顺序。用同一批评论试跑换模型、少样本校准和成对排序,看看哪种方案更接近人工判断。
- 把模型调用留在独立的批处理步骤,让 Astro 只读通过 schema 校验的 JSON。更换模型时,先核对新旧分数和几张代表性对比页,再用新 JSON 构建全站。