本地模型评分波动该如何测量
文章以 M1 Mac 上的量化 Qwen2.5-3B 为例,利用评分 token 的概率研究重复评分的波动。内容对照 MLX 实验环境与 llama-server 采样默认值,讨论温度设为零仍需检查的问题。
AI 深度解读
同一份简历交给本地模型评分,第一次 7 分,第二次却变成 6 分,问题可能出在采样设置。作者用 Qwen2.5-3B-Instruct 做了一组实验:默认设置会让分数波动,temperature 0 能消除这组实验中的重复运行差异,却挡不住改一句提示词带来的分数变化。
这件事值得程序员关心,因为让模型打分、排序、做质量评估,都可能遇到同样的问题。一个稳定输出的数字,离一个可靠的判断还有距离。
默认设置下,分数为什么会变
作者的实验环境是 8 GB M1 Mac,模型为 Qwen2.5-3B-Instruct,采用 4-bit 量化和 MLX,推理库是 mlx-lm 0.32.2。输入是一份六行的初级数据分析师简历,要求模型先给出 1 到 10 分,再说一个理由。
提示词来自 osFoundry 的 Models → Playground。这个应用实际通过 llama.cpp 的 llama-server 运行本地模型,因此作者参考了应用所带 version 10358 的服务端默认值。
下面这段 --help 输出解释了请求不传参数时,服务端会采用什么设置:
--temp, --temperature N    temperature (default: 0.80)
--top-k N                  top-k sampling (default: 40, 0 = disabled)
--top-p N                  top-p sampling (default: 0.95, 1.0 = disabled)
--min-p N                  min-p sampling (default: 0.05, 0.0 = disabled)
-s, --seed SEED            RNG seed (default: -1, use random seed for -1)
要看最后一行:seed 默认是 -1,也就是使用随机种子。应用的 local_inference.rs 只有在配置了服务端温度时才会添加 --temp,所以省略 temperature,并不等于关闭随机性。
在作者分析的默认采样链中,模型依次经过 top-k 40、top-p 0.95、min-p 0.05,最后应用 temperature 0.8。可以把它理解为:先筛掉一部分候选 token,再调整剩下候选的抽中概率。
英文简历的分布经过这条链后,只剩 7 和 6,概率分别为 0.8093、0.1907。作者随后用 make_sampler(temp=0.8, top_p=0.95, min_p=0.05, top_k=40) 生成了 200 次,得到的结论是约五次中有一次会打出 6 分。
如果两个候选人只各评一次,6 分和 7 分的差距就可能混入抽样运气。
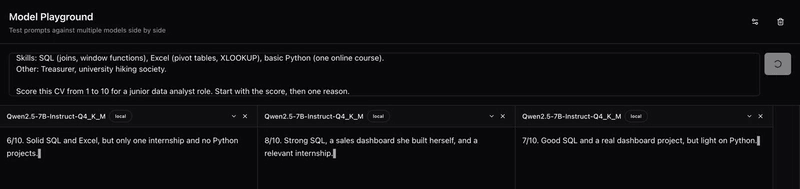
这张图是应用中的示例展示,不能拿它替代那组 200 次生成的统计结果。
先让分数成为下一个 token,才能看见分布
自由生成的回答可能以 Score: 7 开头,也可能先写一整句话。作者采用回复预填充(prefill):提前放好 Score: ,让模型接下来生成的 token 尽量直接对应分数。
下面这段代码解决的是「定位评分位置,并读取候选数字概率」:
import mlx.core as mx
from mlx_lm import load, generate
from mlx_lm.sample_utils import make_sampler

model, tok = load("mlx-community/Qwen2.5-3B-Instruct-4bit")
DIGITS = {d: tok.encode(str(d))[0] for d in range(1, 10)}

def ids_for(cv, question, prefill="Score: "):
    msgs = [{"role": "user", "content": cv + "\n\n" + question}]
    text = tok.apply_chat_template(msgs, add_generation_prompt=True, tokenize=False)
    return tok.encode(text + prefill)

def digit_probs(ids, T=1.0):
    logits = model(mx.array([ids]))[0, -1].astype(mx.float32)
    p = mx.softmax(logits / T)
    return {d: float(p[t]) for d, t in DIGITS.items()}
要留意 range(1, 10):这里只检查 1 到 9。Qwen 的 tokenizer 会把数字拆成单个数字 token,因此 10 的第一个 token 也是 1。首 token 概率不能完整代表 1 到 10 的评分分布。
对于英文输入,173-token 提示只需一次前向计算,就能读取这个位置的概率。T=1.0 对应原始 softmax 分布;温度通过缩放 logits,让分布更集中或更平坦。它和经过整条默认采样链后的概率需要分开看。
同一份简历和问题换成日语后,输入为 222 tokens,预填充改为「点数:」。作者进行了另外 200 次生成,出现四种分数,最高概率的分数也只占约一半。
所以,评分波动多大取决于具体输入。不能测一次英文提示,就认定这个模型在所有语言、所有简历上都差不多稳定。
temperature 0 稳住了重复运行,为什么仍会改分
temperature 0 在这里采用贪心解码,每一步都选概率最高的 token。作者对两种语言分别生成完整的 40-token 回答,各重复 20 次,每种语言都只有一份逐字相同的文本:英文为 7 分及相同理由,日文为「8点」。
固定随机种子也能复现抽样结果。每次生成前重置 mx.random.seed(42),重复 10 次,同样只得到一份文本。但作者提醒,固定 seed 不能当作公平性保证,不同输入依然可能受到不同抽样路径的影响。
这些结果还有一个边界:全部来自空闲模型上的单请求。服务端合并多个请求进行批处理时,微小的浮点差异可能影响接近并列的 token,作者没有测量这种情况。
更关键的变化发生在提示词上。作者做了四种按其判断不该影响评分的编辑。其中,仅把英文问题改成:
「Rate this CV for a junior data analyst role on a 1 to 10 scale. Give the score first, then one reason.」
同一份简历的贪心分数就从 7 降到了 6。原问题是「Score this CV from 1 to 10 for a junior data analyst role. Start with the score, then one reason.」
日语原版加四种编辑共五个版本,temperature 0 下都保持 8 分,但最高概率始终没有超过 44%,第二候选还会在 9 和 7 之间切换。
重复得到同一个答案,只证明它在这些运行条件下可复现。
我的判断
这篇最有用的地方,是把三件容易混淆的事拆开了:采样随机性、提示词敏感性、评分是否可信。temperature 0 对第一件事有效,后两件事还需要单独验证。
但实验范围很小:一个 3B 模型、一份简历、两种语言,而且通过 MLX 分析并模拟 llama-server 的默认采样设置。它不足以证明其他模型、运行后端和任务也有相同的波动幅度。输入没有给出全部概率表和四种编辑的完整内容,不能替作者补齐结果。
保留概率是好建议,但 token 概率不是评分正确率。一个 7 的概率为 74%,不代表它有 74% 的机会符合招聘标准;一个 8 的概率为 40%,也不能直接据此判定评分更差。
作者建议把低置信度的一分差距视为平局,这可以作为保守的工程策略,但没有对照数据证明它能改善筛选质量。相较于继续调温度,明确评分标准、拆分评分维度、用人工标注样本检验排序,才更接近验证「分数有没有用」。原文没有比较这些做法。
能拿来做什么
- 给本地模型接评分功能时,显式记录 temperature、top-k、top-p、min-p 和 seed,并保存模型与服务端版本,方便排查分数变化。
- 批量比较输入时,使用 temperature 0 和逐字一致的评分问题;提示词改版后重新评估全部条目,避免混用两套标准。
- 使用 llama-server 时,可以通过
/completion的n_probs获取 token 概率,结合预填充检查首个评分位置,同时处理 10 分需要多个 token 的情况。 - 在日常 AI 评估脚本中,加入同义改写和重复运行检查;对一分之差且候选概率接近的结果安排复核,并检查理由是否符合评分标准。