首字延迟排查:把模型请求拆成可观测阶段
文章拆解模型请求从网关、分词、排队、预填充到流式传输的处理链路,说明首字延迟可能来自多个环节。建议以同一单调时钟记录各阶段时间,先定位瓶颈再优化。
AI 深度解读
用户等了 3 秒才看到模型吐出第一个字,问题就出在模型算得慢吗?作者提醒:一次模型 API 调用背后,还有网关、路由、排队、输入准备和流式传输。任何一段卡住,用户看到的都是同一个症状。
这篇短文给出的办法很直接:先把首 token 时间拆开测,再决定优化哪里。对接入模型 API、维护 Node 服务或开发 AI 对话界面的程序员,它提供了一套比盲目换模型、加机器更有依据的排查顺序。
首个 token 慢,可能连模型都还没开始跑
一次请求进入系统后,网关先验证身份、检查配额和生成参数,再选择路由。文本需要转换成 token ID;推理引擎还要预留内存,把请求与兼容的任务组成批次。
随后才进入预填充(prefill):模型对整个提示词执行前向计算,并保存注意力的键和值,也就是 KV cache。接下来逐步生成 token,采样器执行解码规则,反分词器还原文本,传输层把事件流送到用户面前。
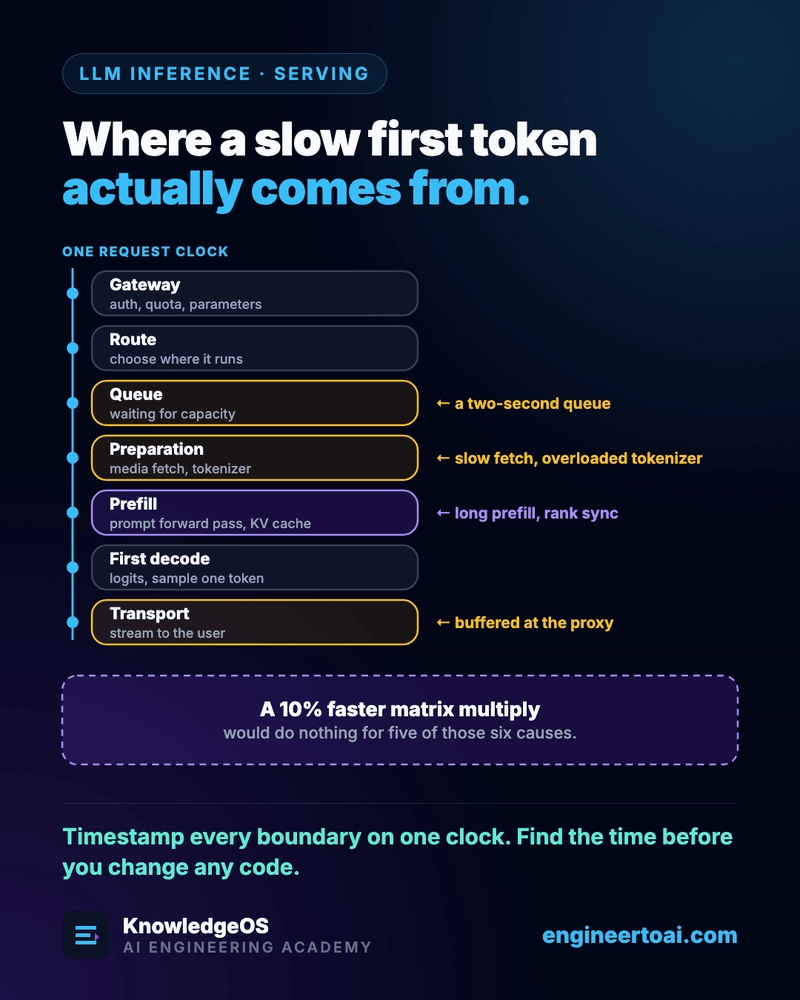
因此,同样是等了 3 秒,原因可能完全不同:
- 请求先排队 2 秒,此时计算内核还没启动。
- 请求附带的媒体资源拉取过慢。
- tokenizer 过载,甚至阻塞事件循环。
- 分布式计算节点之间等待同步。
- 代理缓冲了流,结果没能及时到达客户端。
- prefill 本身耗时较长,这一点出现在原文配图中。
用户看到的首 token 延迟,是整条链路的结果。
作者用一个假设说明优化错位:矩阵乘法快 10%,对上述六类原因中的五类都没有帮助。这是用来解释问题的例子,并非文中给出的实测收益。
怎么知道时间到底花在哪里
作者建议给每个阶段边界记录时间戳,并统一使用同一个单调请求时钟。单调时钟不会因系统校时而倒退,适合计算耗时;关键是各段测量必须能放在同一条请求时间线上。
下面这个拆分式用于核对首 token 时间(TTFT):
TTFT = gateway + route + queue + preparation + prefill + first decode + transport
要注意最后的 transport:引擎生成了第一个 token,不代表用户已经收到了它。各段时间相加,应该接近用户实际观察到的等待时间;如果对不上,就继续找尚未埋点的边界。
仅记录耗时还不够。生产追踪还需要关联请求、路由、模型产物、引擎配置、队列、prefill、decode、token、取消和响应等信息。否则,即使发现某批请求变慢,也可能无法判断它们是否经过同一路由、使用同一套引擎配置。
请求为什么结束,也要单独记录:自然停止、长度限制、策略拦截、客户端取消、超时期限、工作进程失败,以及上游断连。
这能区分两类看起来相似的问题:模型总是耗尽输出额度,还是网络提前丢弃了正常请求。它还能暴露一种浪费:客户端已经断开,服务端仍在执行昂贵的 decode。
我的判断
我认同作者把测量放在扩容和改代码之前。尤其在流式应用里,后端日志显示已开始输出,前端却迟迟没有内容,检查代理和传输环节比直接调整模型参数更有依据。
但原文是一套诊断方法,没有提供真实请求的阶段分布、优化前后数据或对照实验。3 秒、2 秒和 10% 都是说明性数字,不能拿来推断自己系统的主要瓶颈。
它还有一个落地前提:团队能观测推理引擎内部。使用托管模型 API 时,通常只能直接测量自己掌握的网关、调用和客户端接收环节;供应商内部的排队、prefill 和 decode,仍需要对方提供遥测支持。原文没有说明跨机器时钟如何统一,这部分也需要补足。
总耗时指标适合发现变慢,分阶段追踪才适合定位原因。两者应当配合使用。
能拿来做什么
- 在前端记录用户发起请求、收到首个流事件和首次展示内容的时间,在 Node 服务关联同一请求标识,先核对用户等待与服务端观测是否一致。
- 对能够控制的网关、媒体拉取、tokenizer 和代理分别埋点;接入托管 API 时,把不可见的内部耗时保留为待确认区间。
- 给请求结束原因设置明确分类,并检查客户端断开后,取消信号是否传递到上游生成任务。
- 每次优化先选择占时明显的阶段,再比较改动前后的 TTFT,避免用计算性能提升代替用户实际体验的验证。