智能体部署超时后先核实执行状态
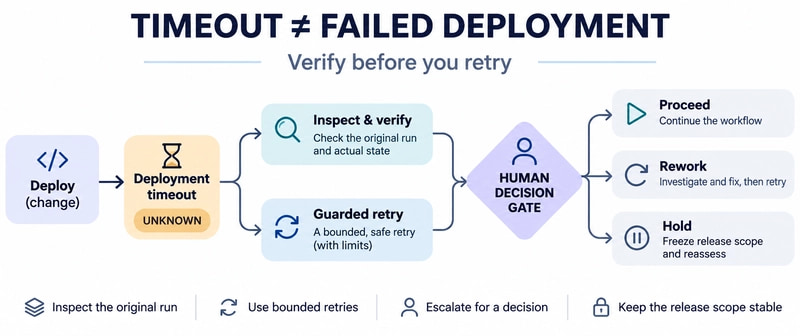
文章把部署拆成任务是否已下发、执行是否结束、上线验证是否通过三个检查阶段。案例中,等待超时会升级处理,因为前一次部署可能仍在运行,直接重试可能造成并发冲突。
AI 深度解读
AI 编程代理等部署结果等到超时,第一反应可能是再发一次。但原来的部署也许还在跑。第二次下发可能让两个任务同时修改同一个环境,把一个观察不到结果的问题变成发布冲突。
作者用 IssueFlow 里的 AOP 部署配置说明,恢复流程应该先查清上一次动作发生了什么,再决定继续核验、限次重试、修代码还是升级处理。写 CI/CD 脚本或给编码代理接部署工具时,这个例子最值得借鉴的是每条分支需要什么证据。
观察超时后,先查原来的部署
一次发布有三个问题需要分别回答。部署请求发出去了吗?部署任务跑完了吗,结果是什么?上线后的应用通过了要求的检查吗?监听器超时,只说明它没在期限内拿到结果。原任务可能还在运行,也可能已经结束,只是结果没传回来。
作者检查的配置里,deploy-dev 负责发起部署并等待结果。等待超时后,流程进入升级处理。遇到临时的源码管理故障,配置则会先等 5 分钟,最多重试 3 次,仍未解决再升级。两条分支的区别在于,前者连上一次部署的结果都还没查清,后者已有具体的故障类别,可以按配置尝试恢复。
部署平台如果返回了运行 ID、目标仓库、提交和环境,就把这些信息留在任务记录里。结果不明时,用运行 ID 查同一次部署。直接创建新任务之前,先确认旧任务是否仍可能改动目标环境。
等待结束后,为什么还要进 verify
在 AOP 的配置里,等待步骤正常结束,即使拿到的部署结果是失败,也可以进入 verify。验证阶段会读取实际结果,再决定往哪里走。设计流程时,每个阶段只应为自己掌握的事实负责。「等到了结果」「部署成功」「应用通过检查」分别需要不同的证据。PR 合并只能证明代码进了目标分支,部署平台报告成功也还需要应用检查来支撑发布结论。
verify 配了四种去向。允许立即重新部署时,回到部署阶段,最多重试 2 次。允许延后重新部署时,等 15 分钟,最多重试 3 次,之后升级。确认是本次改动破坏了部署,就回到发布范围阶段,把修复纳入新的范围。需要人判断时,走升级路径。
最容易出错的一步是判断故障归因。把代码问题归成基础设施抖动,会反复发布同一份坏提交。把平台故障归成代码问题,又可能让代理去改原本正常的代码。记录失败的检查、涉及的提交、用于对比的基线和仍未查清的疑点,后续接手的人才能复核这个决定。
发布标记为什么要用冻结的批次
假设这次选中提交 A 和 B,部署期间提交 C 合并进来。如果最后一步重新查询当前已合并的提交,C 就可能被记成已上线,尽管这次部署根本没带上它。
AOP 把确定范围的 release-scope 和记录结果的 release-mark 分开。后者使用前面冻结的范围。可直接验证的条件是,每条标记为已部署的事项,都能在实际通过验证的批次里找到。即使分支在验证期间继续前进,发布记录也应沿用当时确定的范围。
我的判断
按故障原因决定下一步,比给整个流水线套一个统一的重试配置更贴合发布现场。统一重试容易配置,适合失败已确认、重复执行安全的操作。部署监听超时应先看能否查回原任务。平台是否提供可查询的运行 ID、任务状态能否及时反映实际执行情况,会直接影响团队能做到哪一步。证据不足时,应保留结果未定的状态。需要人工介入时,把待决定的问题和后果交给值班人,例如这次发布是继续等,还是调整范围后再发。
原文展示的是作者检查过的配置,没有报告某次发布成功,也没有给出节省时间或减少事故的对照数据。文中的沙箱用例也只是测试提案。5 分钟、15 分钟和对应的重试上限都是该工作流的具体设置,能否照搬要看团队自己的故障类型和部署平台。这篇最扎实的部分,是把每条恢复路径写成可以断言的行为。
能拿来做什么
- 给前端或 Node 项目的部署步骤留一份运行记录,写入平台返回的运行 ID、仓库、提交和目标环境。监听超时后,先沿这份记录查询原任务,再决定是否允许重新部署。
- 在 CI 或代理编排里区分等待超时、临时平台故障和本次改动导致的验证失败。给允许重试的分支设置等待时间、次数上限和耗尽后的去向。
- 发版前固定本次提交和事项清单,让验证与发布标记都引用这份批次。在沙箱里模拟验证期间有新提交合并,检查新提交是否被误记为已发布。
- 在受控环境模拟监听断开、原部署继续运行的情况,检查代理有没有重复发起部署。记录初始状态、故障原因、选中的路径、尝试次数和最终证据,把不符合预期的跳转当作流程缺陷。