自动搜索结果正常返回也可能失真
SerpApi 观察到,部分自动化搜索返回外观正常、内容却偏离人工搜索的结果,涉及 Google 搜索、购物及 Bing。此类异常可能悄然影响排名监控和依赖搜索来源的 AI 智能体。
AI 深度解读
自动搜索拿到一张正常的结果页,不代表拿到了可信的结果。SerpApi 观察到,一些 Google 自动化搜索返回的链接,与人工搜索同一关键词时明显不同。他们把这类现象称为「被投毒的搜索结果」。
麻烦在于,页面仍然可用,程序可能照常解析、继续执行。排名监控会因此误报,依赖搜索的 AI agent 也可能引用异常来源。这篇文章值得读的地方,是提醒我们区分「请求成功」和「结果可靠」;至于异常原因,作者没有给出定论。
「被投毒」的结果,可能看起来很正常
这里的「投毒」描述的是搜索结果异常,并不能据此认定有人主动实施了攻击。
文章引用 Semrush 报告的两种表现:一种是第一页就出现明显不相关的链接;另一种更隐蔽,顶部结果看起来正常,同一页靠后的位置却混入了关联较弱的链接。
SerpApi 表示,他们在 Google Search API 的第一页和后续页面都观察到了类似问题。
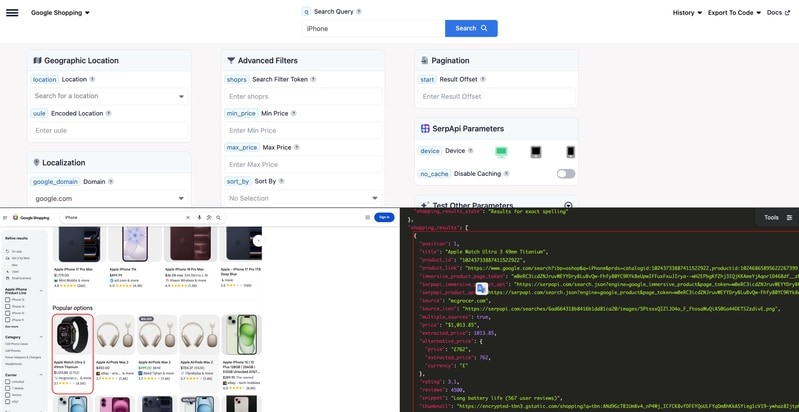
问题也不限于普通网页搜索。在作者提供的 Google Shopping API 案例中,搜索 iPhone,前四个位置却出现了其他产品。
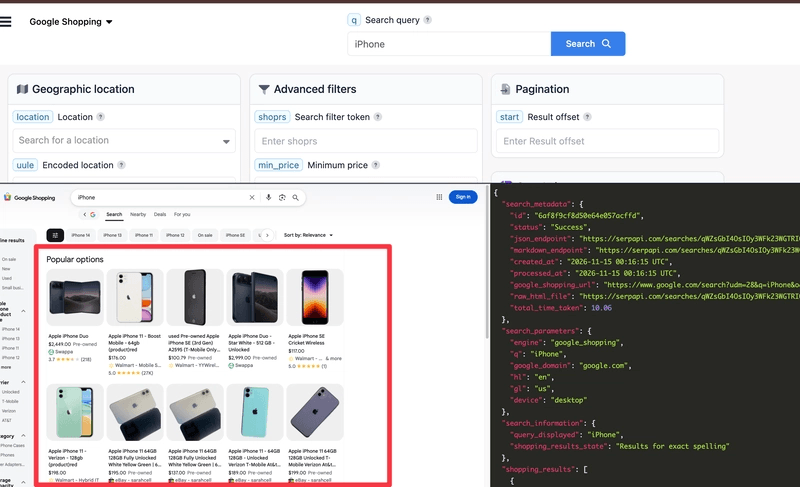
作为对照,作者展示的正常结果应当在顶部呈现 iPhone:
作者还提到,他们在 Bing 上观察到了类似行为。不过,原文没有提供 Bing 的具体案例或发生频率。
为什么不能靠一次请求判断结果是否可信
请求成功,只能证明程序拿到了页面,不能证明页面符合这次搜索的预期。
对于排名追踪工具,历史记录还能提供一点参照。如果一个长期稳定的关键词突然大幅变动,系统可以把它标为异常,再进一步核查。
实时搜索 API 的处境更难:它可能第一次遇到这个查询,没有历史结果可以比较。即使有历史记录,排名也可能因正常原因发生变化。作者表示,目前没有可靠的页面内信号,能直接区分正常变动和这类异常。
而且,问题会随关键词变化。一个查询返回准确结果,并不能证明下一个查询也准确。因此,用少数成功请求判断整个搜索服务正常,容易漏掉问题。
对 AI agent 来说,这种错误尤其容易继续传递。结果页能被读取,链接能被提取,后续回答便可能建立在一组本不该出现在该搜索中的来源上。流程没有中断,信息质量却已经偏离。
SerpApi 做了什么,还没有解决什么
SerpApi 当前的做法,是持续监控一组顶部结果通常比较稳定的查询。它们可以充当参照,帮助团队发现异常变化,也用于观察调整是否有效。
他们还修改了结果采集方式,以降低问题出现的频率。但文章没有披露具体改动,也没有给出调整前后的对照数据。作者明确表示,异常仍会间歇出现,团队还在根据 Google 响应的变化继续调整。
如果用户遇到异常,作者建议提交对应的 search ID,便于支持团队调查;后续进展则通过状态页中的事件更新。
这是一份问题观察和处理进展说明,还不是一套可以复现的检测方案。
我的判断
我认同文章对搜索依赖风险的提醒:对于排名监控和 AI 检索,页面能解析只是最基础的一关,结果与查询是否匹配同样需要检查。
但「poisoned」这个词容易让人提前接受某种因果解释。原文展示了异常现象,没有说明其机制,也没有交代人工搜索与 API 搜索的对照条件是否完全一致。因此,目前更适合把它理解为自动搜索中的结果异常。
稳定查询监控有实用价值,但只能覆盖被监控的样本。作者自己也指出,异常会因关键词而异,所以这套办法不能替每个实时查询担保。
和单纯依赖历史排名相比,检查结果相关性可以补充一个观察角度;但相关性偏低也未必就是这里描述的问题。作者没有给出检测准确率、误报率或优化收益,我们不能把处理经验当成已经验证的通用方案。
能拿来做什么
- 如果你的 Node 服务接入搜索 API,可以参照作者的做法,维护一组顶部结果通常稳定的查询,用来观察采集链路是否出现异常。
- 如果你在做排名监控,遇到突发下降时先保留对应结果并核查,避免直接把一次异常响应当成真实排名变化。
- 如果 AI 编程助手或 agent 依赖实时搜索,不要仅凭顶部几条结果相关就接受整页来源,靠后的链接也需要检查。
- 如果使用 SerpApi,发现异常时记录对应的 search ID,提交调查时便能定位到具体搜索。