开源 AI 审查器如何处理代码与密钥
Apache-2.0 开源项目 Owlet Lens 在发送代码差异等内容前扫描并脱敏常见密钥,支持自带模型密钥或连接自托管模型,同时明确模式匹配可能漏检。它还支持避免重复评论,并将团队拒绝的建议转成规则变更 PR,交由人工审核。
AI 深度解读
让 AI 审查 PR,绕不开三个问题:代码会发到哪里,机器人会不会反复刷屏,尚未准备好的改动能不能先别审。Owlet Lens 的作者给出的答案,是在发送前脱敏、控制重复评论,再把启动审查的时机交给团队。
这款采用 Apache-2.0 许可证的开源工具,值得关注的是这些流程设计。至于审查能力,作者只做了自设缺陷的小测试,还不足以证明它比其他工具更准。
代码发给模型之前,究竟拦了什么
Owlet Lens 会在内容离开 CI 之前,扫描 diff、代码导入的文件,以及开发者的回复。API keys、tokens、连接字符串里的密码和 PEM 私钥会被替换成 [REDACTED],脱敏次数也会记入日志,方便检查扫描是否生效。
这里的脱敏依赖模式匹配,也就是按已知格式找疑似密钥。作者明确承认:长得不像密钥的秘密可能漏过;开发者主动添加为上下文的文件,则会原样发送。
发送前有扫描,不等于发出去的内容一定没有秘密。
数据路径上,Owlet Lens 没有自家的中间服务器。用户自行提供 Anthropic、Gemini、DeepSeek、OpenRouter 或其他兼容 OpenAI 的服务密钥,也可以连接自己部署的模型。不过,没有 Owlet Lens 中转,只能说明少经过一个服务方,不能据此推断模型服务商如何保存和使用数据,原文没有说明这些政策。
降低审查噪声,先从少发重复评论开始
同一个问题如果在下一次 push 时仍未关闭,机器人不会再次发布。这解决的是很具体的协作摩擦:开发者还没处理,评论区却又多了一份相同提醒。
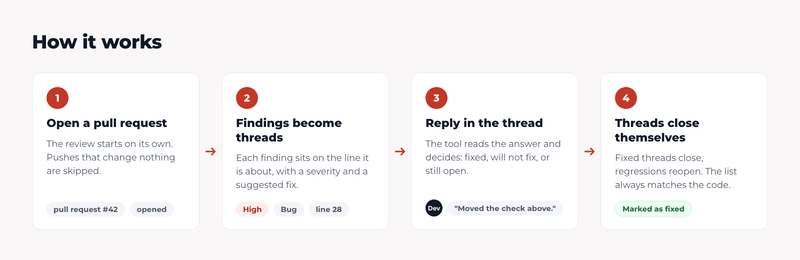
可选的 learn mode 还会收集团队拒绝采纳的问题。当开发者回复「这里这样写没问题,因为……」,这类反馈可以成为规则来源;之后再次出现相同模式时,工具会创建一个 PR,向编码规范添加规则。
关键是,这个 PR 仍然需要人审阅,不会自动合并。它把团队反馈变成可检查的规范变更,但规则是否准确、适用范围是否过宽,仍要由团队判断。原文没有给出这套机制降低误报的对照数据。
草稿什么时候开始审,由团队决定
开启 TL gate 后,机器人会等待团队负责人放行。等待期间不会调用 LLM,因此不会产生模型调用费用。负责人点击 GitHub 自带的 Re-run all jobs 后,该 PR 才进入每次 push 都审查的状态。
下面这段配置用于开启门控,并指定负责人:
review:
  tlGate:
    enabled: true
    leads: ["12345", "67890"]   # numeric user IDs
要看清 leads 这一行:这里填写的是数字用户 ID,不是用户名。
开关配置从目标分支读取,因此 PR 不能靠修改自己的配置来关闭门控。但 PR 仍然可以修改 workflow 文件,所以作者把它定位为团队协作约定,而非安全边界。
Owlet Lens 支持 GitHub、GitLab、Bitbucket Cloud 和 Azure DevOps,可作为 GitHub Action 使用,也能通过命令行运行。安装命令是:
npm i -g @openwt-vn/owlet-lens
注意 -g 表示全局安装;这条命令完成的是安装,具体怎样运行审查,原文没有展开。
我的判断
我认同作者优先处理数据、噪声和启动时机。与每次 push 都直接触发审查相比,门控给了团队一个明确的准备阶段;与拒绝一次、下次继续提醒相比,把拒绝理由整理成规则也更便于维护。
但这几项能力都有前提:脱敏需要持续验证,规则需要有人审核,门控需要负责人参与。团队是否愿意承担这些维护工作,会直接影响使用效果。
准确率和成本尤其需要克制解读。作者在一个 PR 里主动埋了 4 个 bug,工具全部找到了。这只能证明它通过了作者设计的友好测试。两次小 PR 的费用约为 $0.006 和 $0.009,但原文没有交代模型、diff 规模及上下文长度,不能拿来估算一般团队的成本,也没有与其他工具的基准比较。
能拿来做什么
- 接入前,先核对前端或 Node 仓库中会发送哪些上下文,尤其检查主动添加的文件,因为它们不经过上述脱敏处理。
- 用团队已有的真实 PR 试跑,记录有效发现、误报和遗漏;不要只用人为埋入的 bug 判断审查质量。
- 如果草稿 PR 更新频繁,可以尝试 TL gate,把开始审查设为明确动作,并记录放行后的实际调用费用。
- 启用 learn mode 时,让熟悉代码规范的人审核规则 PR,确认一次拒绝理由是否适合推广到其他代码。