直接修改模型权重能否修复推理循环
文章解读一项权重编辑实验:据其介绍,GPT-6 Astra 修改 Qwen3.5-0.8B 的少量权重后,MATH-500 得分由 7.9% 升至 48.1%。内容追踪修改逻辑、运行日志及检查点,并用 NumPy 重建核心操作,讨论其在 Gemma 上失败的差异。
AI 深度解读
改动约 0.016% 的参数,就能让一个小模型的 MATH-500 成绩从 7.9% 升到 48.1%?原文给出的解释是:GPT-6 Astra 找到了 Qwen3.5-0.8B 反复思考却迟迟不作答的行为方向,并直接修改权重,减少了这种循环。
这项工作的看点,在于大模型开始承担模型内部的诊断与修补。不过,漂亮数字背后还有 50 次前向评估、20.3 小时的排查,以及尚未解决的循环。对程序员而言,它更像一次模型层面的故障定位,值得连同实验条件一起看。
分数涨了六倍,究竟修好了什么
据原文,MIT CSAIL 团队于 2026 年 11 月 2 日发布了「Sparks of Weight-Space Programming」。它当时是博客和 alphaXiv 预印本,尚未经过同行评审。所有实验都使用未经专项训练的 GPT-6 Astra 作为编辑者。
所谓权重空间编程(Weight-Space Programming),就是让一个模型读取另一个神经网络的权重,提出解释,再通过代码写入修改。编辑过程不使用优化器、梯度下降或训练循环。
Qwen3.5-0.8B 的问题尤其适合这种尝试。开启 thinking mode 后,它会反复检查、怀疑和重述已有步骤。在最多生成 32,768 个 token 的评估设置下,原始模型有 93.0% 的回答耗尽额度,MATH-500 得分只有 7.9%。
这次提升首先说明模型更容易完成作答,不能直接解释成它学会了更多数学。
证据不只来自数学题。修改后,GSM8K 从 13.8% 升至 67.1%,指令遵循测试 IFEval 从 21.0% 升至 62.3%;AMC23、Minerva Math、OlympiadBench 和 GPQA Diamond 也有提升。作者据此认为,修补针对的是跨任务的循环问题。回答较短的 MMLU-Pro 变化很小,也与这个解释相符。
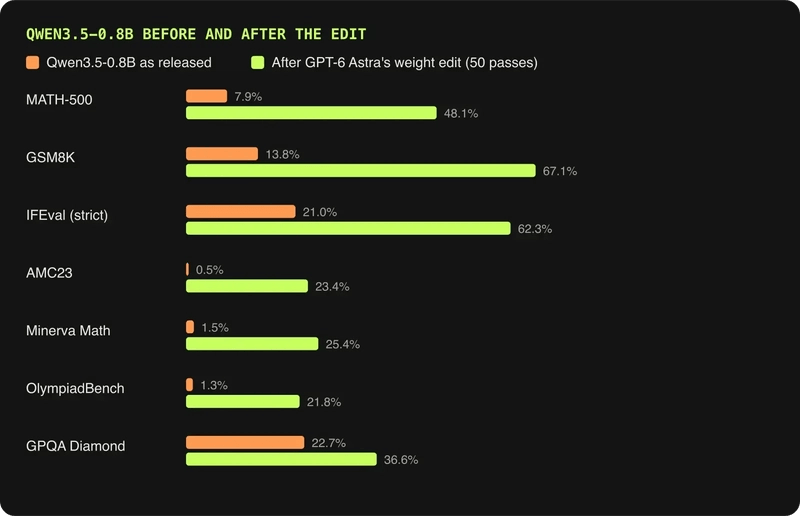
但循环没有消失。最佳版本仍有 33.1% 的回答触及 token 上限。它修复了相当一部分失败路径,还谈不上彻底解决。
只动两层,为什么能影响整个回答
理解修改方法,需要先认识残差流(residual stream):它是模型各层不断读取、更新的一组中间状态。在这个 Qwen 模型里,每个 token 对应 1,024 个数,依次经过 24 层处理。
每层的 MLP 通过最后一个矩阵 down_proj,把计算结果写回残差流。矩阵的一列,可以理解为某个神经元激活时,向中间状态添加的一组变化。
Astra 找到了一个与循环行为相关的方向 u,并认为第 15、19 层的 MLP 是主要写入者。它按各列沿 u 方向的写入强度排序,每层只处理最强的 64 列。
下面这段公式说明了补丁的范围和操作:
W' = W - u (u^T W)        applied to the 64 selected columns only

2 layers x 64 columns x 1,024 rows = 131,072 weights
131,072 / ~0.8B parameters        = about 0.016%
要注意第一行:它减去的是选中列沿 u 的分量,并没有把这些神经元全部关闭。这个投影公式还依赖 u 已归一化,原文的 numpy 演示做了这一步。
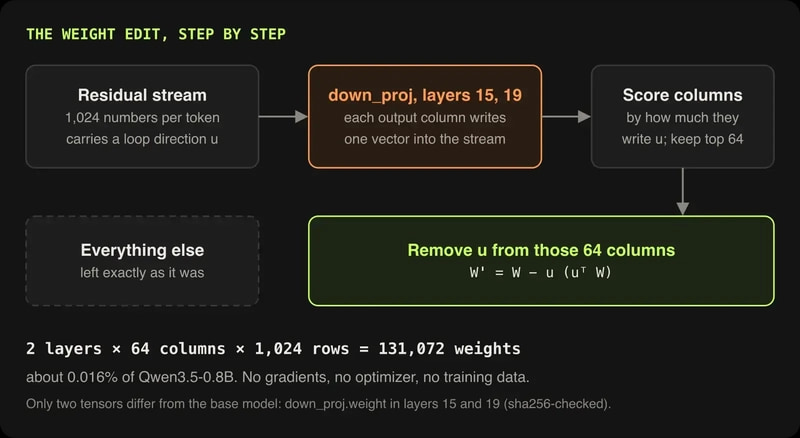
模型卡称,基础模型与修改版只有两个张量不同,分别是这两层的 down_proj.weight,并通过 sha256 校验。补丁先以 float32 写入,再转成 bfloat16 评估;舍入后,真正不同的权重数是 130,188,而非全部 131,072 个。
难点也就在这里:投影计算很简单,找到哪个方向、哪两层、哪些列才困难。
原文的 numpy 示例会先在随机矩阵中人为植入方向,再把它移除。它能解释数学操作,却不能复现真实模型里发现 u 的过程。把这段演示跑通,距离自动诊断一个模型仍有很大差距。
没有训练,不代表没有搜索和评估成本
Astra 得到的是一个已加载权重的 Python kernel,没有 GPU,并且只能在有限预算内调用真实模型。
一次前向调用按一批练习题计,平均约 64 题,最多 512 题。可用数据包括 GSM8K 的 7,469 道训练题和 MATH 的 7,275 道训练题,不使用测试集。这里的「不训练」不等于不接触数据,系统仍然依靠练习题判断补丁好坏。
三档预算是独立运行,结果很能说明问题:
| 前向调用预算 | 找到的修改 | MATH-500 | 触及生成上限 |
|---|---|---|---|
| 10 次 | 第 8 至 22 层共 30 个矩阵做秩一修改,系数为 1.5 | 12.3% | 87.2% |
| 25 次 | 清零第 15 层注意力头 7 的 256 个输出列 | 14.1% | 86.4% |
| 50 次 | 修改第 15、19 层各 64 个 down_proj 列 |
48.1% | 33.1% |
前两个补丁范围更粗,收益也小。证据更多后,Astra 找到了范围更窄、效果更好的改法。但只有这三次运行,尚不足以证明增加预算总能得到更精准的补丁。
最佳运行经历了 158 轮对话、80 次 Python 执行,总耗时 20.3 小时,其中 4.7 小时在等待服务故障恢复。它是一次长时间的工具调查,不能理解成一句提示词完成模型升级。
复现时,采样设置同样不能省略。下面是原文加载公开检查点的代码:
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer

model_id = "RikiyaT/Qwen3.5-0.8B-weight-space-programming"
tok = AutoTokenizer.from_pretrained(model_id)
llm = LLM(model=model_id, dtype="bfloat16", max_model_len=34816)

question = "What is 2^10 + 24?\nPlease reason step by step, and put your final answer within \\boxed{}."
prompt = tok.apply_chat_template(
    [{"role": "user", "content": question}],
    tokenize=False, add_generation_prompt=True, enable_thinking=True,
)

params = SamplingParams(
    temperature=0.6, top_p=0.95, top_k=20,
    presence_penalty=1.5, max_tokens=32768, seed=0,
)
print(llm.generate([prompt], params)[0].outputs[0].text)
重点看 enable_thinking=True 和 SamplingParams:关闭思考模式或改变采样参数,就已经换了比较条件。原评估提取最后一个 \boxed{} 答案,用 math-verify 判分;MATH-500 等任务每题生成 4 次,不能拿一道题的一次输出对照论文成绩。
原文还转述了第三方复跑:使用 vLLM、math-verify 0.9.0,完成 2,000 次生成后得到 51.0%,仍有 31.6% 触顶。这支持改善方向,但属于原文报告的结果,具体数值受采样设置影响。
我的判断
我认可这项工作对「模型为什么失败」的拆解。它提醒我们:最终正确率下降,可能来自无法结束、无法输出答案,而不只是知识或推理能力不足。对于自部署模型,这种区分会直接影响排查路线。
但「LLM 能像读源码一样读权重」仍是过强的概括。原文里,两种 Gemma 3 270M 微调模型分别表现诚实和迎合用户,Astra 仅看权重时四次全部失败;补充自行选择的 16 段文本的注意力模式后,才在三对模型中全部识别成功。这是识别实验,并非同一循环补丁在 Gemma 上失败。
其他结果也有明确边界。MinAtar Breakout 中,一次回复写出的网络得到 517.4 分,超过 PPO 训练 500M 步的 25.3 分;但 Seaquest 上,53.1 分仍低于 PPO 的 88.9 分。规则容易写成控制策略的任务,更适合把已有知识直接编码进网络。
它展示了一种值得研究的修补方式,还没有证明能够普遍替代微调。
原文将它与 fine-tuning、ROME、MEMIT 并列比较,但没有提供同预算、同任务的充分对照。维护一个行为补丁,也需要检查回归、模型版本变化和量化影响。不能只凭改动比例小,就认定风险和成本都小。
能拿来做什么
- 自部署 Qwen3.5-0.8B 时,可以用同一批题、同一套采样设置比较基础版与公开补丁版,同时记录正确率、输出长度和触及
max_tokens的比例,判断收益是否来自减少循环。 - 排查 AI 编程助手长时间反复推理的问题时,可以先区分模型输出循环、工具调用循环和 Agent 调度错误。原文处理的是模型内部行为,不能直接套用到所有重复执行问题。
- 研究权重编辑时,可以从日志目录
runs/p50c/和code/apply_edit.py入手;复建需要基础版本2fc06364715b967f1860aea9cf38778875588b17,再通过code/build_ckpt.py转换检查点。先核对张量和哈希,再谈效果复现。