有损推测解码提速,质量该如何验收
据文中介绍,vLLM 0.33 的可选 FLy 验证器通过接受部分原本会被拒绝的草稿 token 提速,但不保证保持目标分布。作者复核发布方数据,指出单次准确率比较难以区分质量损失与随机波动,建议采用逐题配对评估并扩大样本。
AI 深度解读
vLLM 0.33.0 加入了一个用输出质量换吞吐的可选开关:FLy 会放行一部分原本该被目标模型拒绝的草稿 token。PR 报告它在 48 组配置中都带来了提速,但准确率表格还不足以证明质量没有下降。
这篇分析值得读的地方,是作者把「跑得更快」「测不出退化」「可以上线」拆开讨论了。同一版本还有一个调度修复,单次报告吞吐提升到 2.47 倍,提醒我们:推理服务的瓶颈,也可能藏在 token 预算怎么算。
FLy 为什么能提速,又放弃了什么
标准推测解码(Speculative Decoding)先让小模型提出 K 个 token,再由目标模型一次前向计算完成验证。遇到第一个被拒绝的位置就停止,接受规则保证最终输出分布与目标模型单独生成一致。
FLy 放宽了停止条件。某个草稿 token 被拒绝后,只要同时满足三个条件,就有机会继续接受:它没有被目标约束屏蔽;目标模型在该位置的熵达到阈值,也就是自己也不够确定;后续 W 个草稿 token 全部通过普通验证。后续窗口再出现拒绝,原来的拒绝仍然生效;末尾不足窗口长度的部分也不会延后判定。
它不需要额外 checkpoint,也不增加目标模型前向计算,但FLy 不再保证目标模型的输出分布,PR 明确提示可能降低输出质量。
vLLM 0.33.0 于 2026-11-02 发布到 PyPI,标准验证仍是默认选项。下面这段配置展示了如何主动开启 FLy:
from vllm import LLM

llm = LLM(
    model="Qwen/Qwen3-8B",
    speculative_config={
        "method": "draft_model",
        "model": "Qwen/Qwen3-0.6B",
        "num_speculative_tokens": 8,
        "rejection_sample_method": "fly",   # 默认采用标准验证
        "fly_window_size": 6,
        "fly_entropy_threshold": 0.3,
        "fly_entropy_top_k": 3,
    },
)
要盯住 fly_window_size:默认是 min(6, num_speculative_tokens - 1),至少需要两个推测 token,但 PR 的 ModelRunner V2 测量使用 window=2。例如 K=7 的配置默认窗口是 6,直接启用默认值并没有复现测试条件。
另一个实现差别是,熵只用 top-k 目标概率计算,默认 k=3,而且不重新归一化;论文 arXiv 2511.22972 使用的是完整词表。
速度测试覆盖 AMD MI355X、NVIDIA B300,batch size 为 1、4、8、16、32、64,每个请求生成 1,024 token,使用固定的 64 条 prompt。四个模型组合包括 DeepSeek-V4-Flash+DSpark(K=7),以及使用 MTP 的 Qwen3.8-27B(K=3)、GLM-5.2-FP8(K=5)、Qwen3.5-122B-A10B-FP8(K=8)。
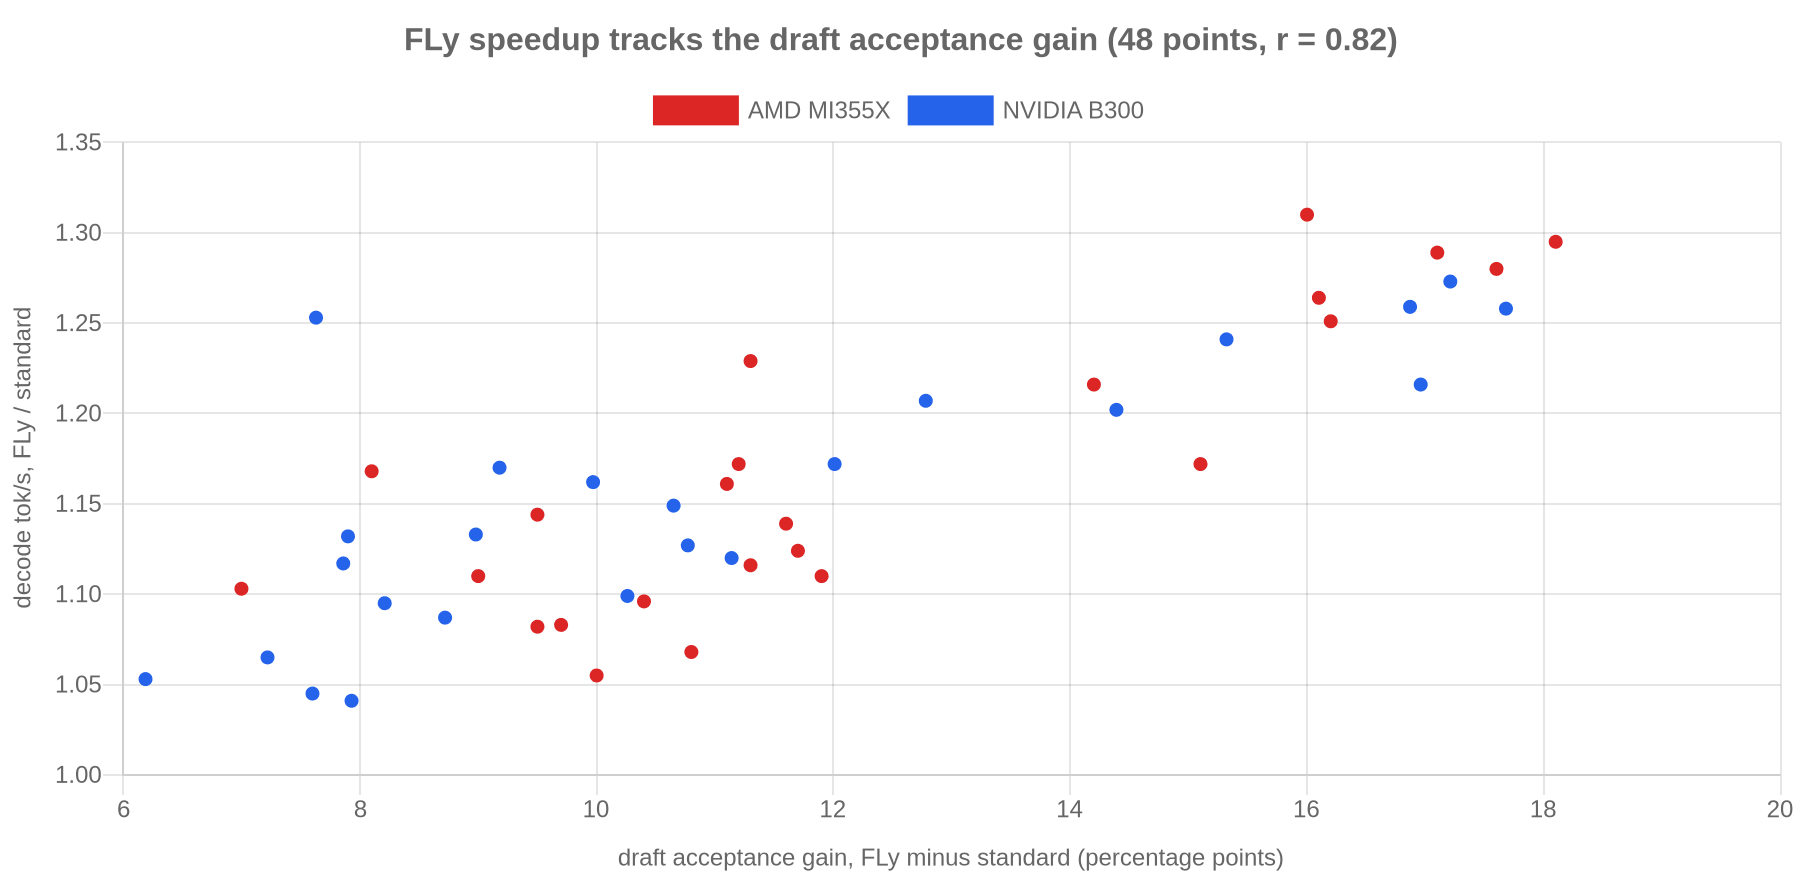
PR 报告相对标准推测解码提速 1.041x 至 1.310x,作者解析表格得到中位数 1.147x,接受率增益与提速的相关系数为 r=0.82。Qwen3.8 接受率增加约 7.6 至 10 个百分点,提速约 6% 至 8%;Qwen3.5-122B 增加约 16 至 17 个百分点,提速约 24% 至 28%。容量规划不能直接套一个固定的 1.2x。
准确率没掉,为什么还不能算通过
质量评估为每个模型和平台准备了 428 道题:GSM8K 前 100 题、MATH-500 前 100 题、AIME25 的 30 题,以及 GPQA-Diamond 的 198 题。两种平台、四个模型、四个数据集,共 32 个准确率单元。
作者没有亲自运行 FLy,只重新计算了 PR 表格。结果是:标准推测解码相对 target-only 的平均绝对偏差为 1.68 个百分点,FLy 为 1.80 个百分点。
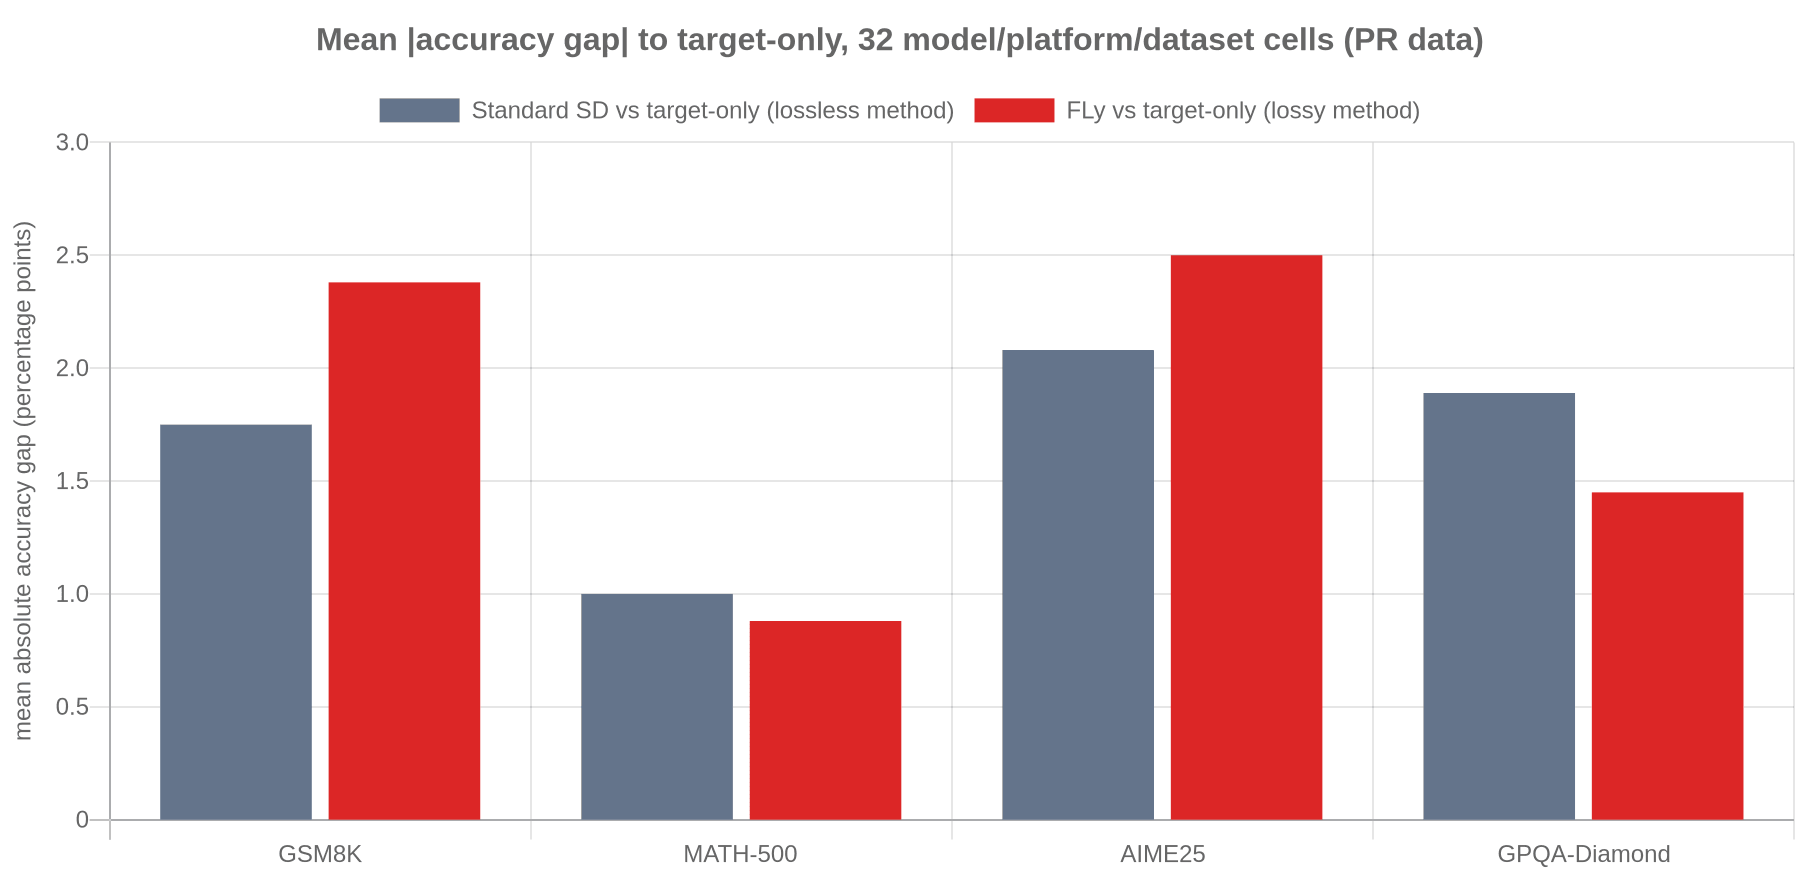
标准方法按设计保留分布,却同样出现分数波动。例如 DeepSeek-V4-Flash 在 B300 的 AIME25 上,target-only 答对 26/30,标准方法答对 28/30;Qwen3.5-122B 在 MI355X 的 GSM8K 上,FLy 甚至从 82/100 升到 92/100。这些结果不能直接归因于验证器优劣,单次采样、批处理浮点差异等因素都可能参与其中。
汇总八个模型与平台组合,每种模式有 3,424 个答案,FLy 比 target-only 多答对 19 道,标准方法多 27 道。标准方法约 0.8 个百分点的正向偏移,已经显示出这套测量的噪声尺度。
在准确率约 90% 时,两个非配对准确率之差的粗略 95% 区间,428 题约为 ±4.0 个百分点,198 题约 ±5.9,100 题约 ±8.3,30 题约 ±15;最后一种正态近似尤其粗糙。真实的 1 至 2 个百分点损失,很容易被盖住。
因此,AMD 的最低保持率 96.43%、NVIDIA 的 96.30% 不能当质量承诺。这两个数字对应 AIME25 只差一道题,每题就占约 3.3 个百分点。
更合理的办法是配对评估:同一批问题、相同 seeds,逐题记录谁从对变错、谁从错变对,再做 McNemar 精确检验。下面的原文代码同时给出了检验与样本量估算:
import math

def paired_gate(base, cand):
    """base, cand:相同问题和 seeds 下逐题记录的 0/1 正确性。"""
    lost = sum(1 for x, y in zip(base, cand) if x and not y)
    gained = sum(1 for x, y in zip(base, cand) if y and not x)
    n, k = lost + gained, min(lost, gained)
    p = min(1.0, 2 * sum(math.comb(n, i) for i in range(k + 1)) / 2 ** n) if n else 1.0
    return {"lost": lost, "gained": gained, "net": gained - lost, "exact_p": round(p, 4)}

def questions_needed(net_loss, discordant, z_a=1.96, z_b=0.8416):
    # 双侧 alpha 0.05,检验功效 0.80;discordant 为任一方向发生翻转的题目比例
    return math.ceil((z_a * math.sqrt(discordant)
                      + z_b * math.sqrt(discordant - net_loss ** 2)) ** 2 / net_loss ** 2)
关键是 discordant,它需要通过预实验估计。翻转率为 6% 时,以 80% 检验功效检测 2 个百分点净损失约需 1,175 题,检测 1 个百分点约需 4,700 题;翻转率升至 8%,前者约需 1,570 题。
作者实际运行的是合成示例:428 题、基准准确率 89%、随机翻转约 5%,得到 lost=25、gained=2,p<0.0001。这说明代码能识别故意制造的明显退化,不是 FLy 的实测质量证据。
同版 2.47 倍吞吐,为什么来自预算记账
PR #59468 修复了 DFlash、DSpark 的调度预算。它们在目标 batch 之外单独执行草稿计算,却仍在每个请求的 max_num_batched_tokens 份额里预留草稿槽位。DSpark 在 K=5 时,一个解码请求被计为 10 token,修复后是 6。
新实现把预留槽位设为 0,另用 max_num_batched_tokens // num_lookahead_tokens 限制活跃请求数,确保独立草稿缓冲区仍能容纳。
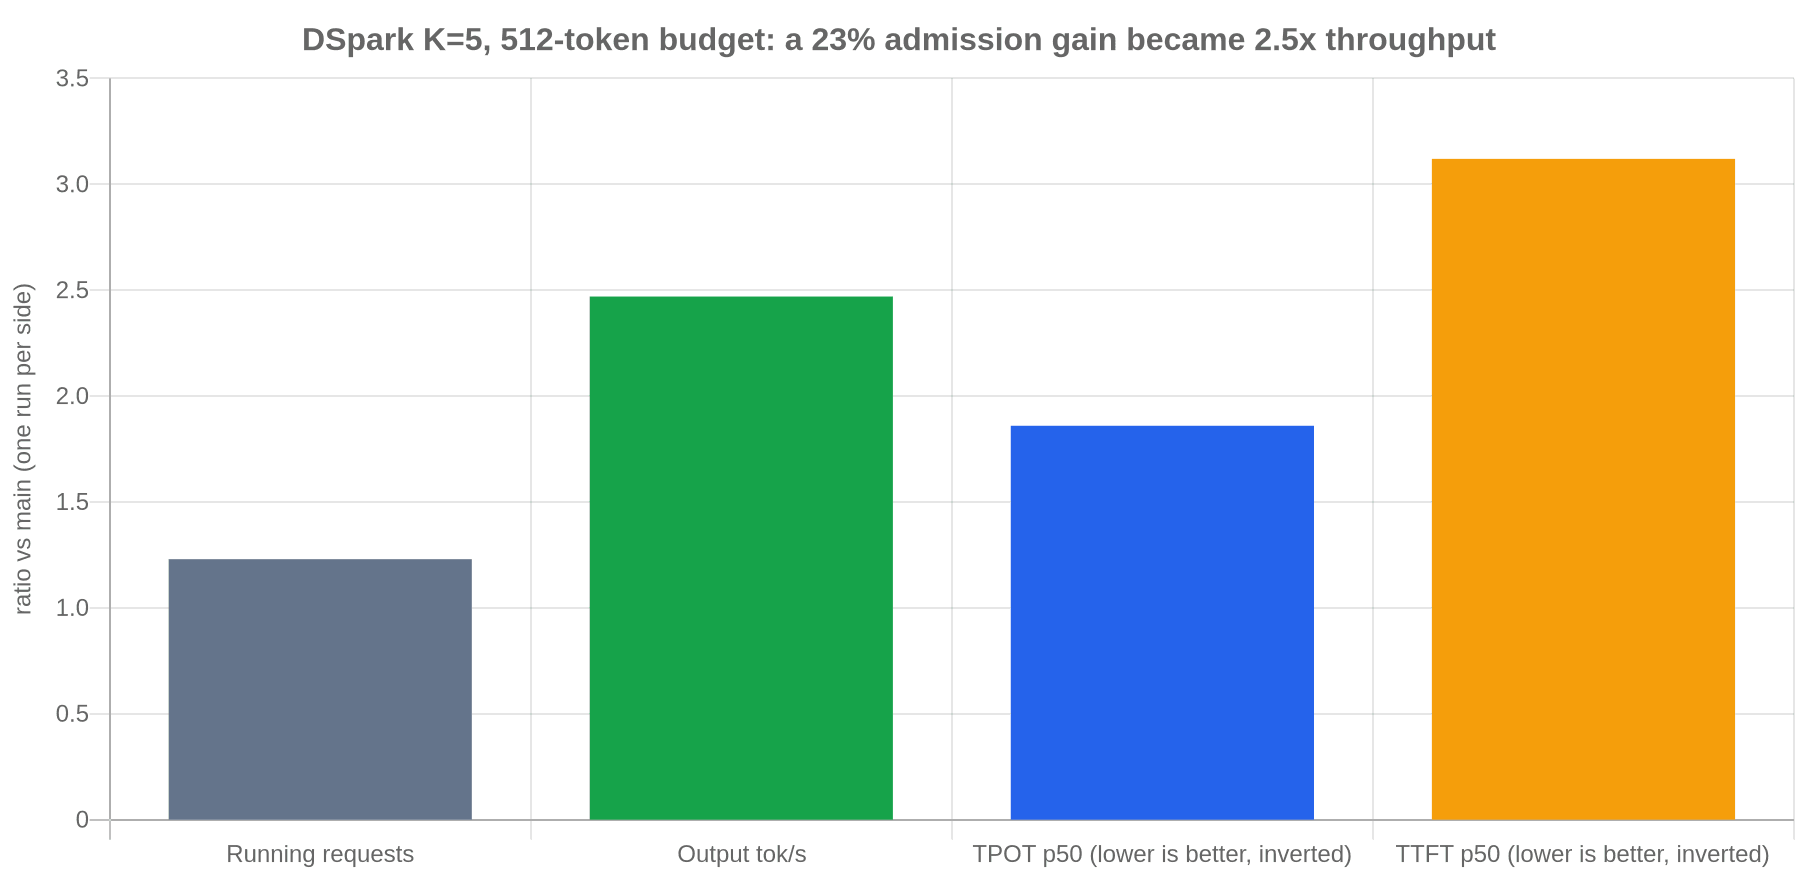
报告配置是 DeepSeek-V4.1-Flash+DSpark,单台 GB300、TP4、--max-num-batched-tokens 512。输出吞吐从 1,373 升到 3,390 tokens/s,即 2.47x,而准入请求只增加到 1.23x。
差距来自调度连锁反应:旧实现剩余的 2 至 32 个 token 预算把新请求 prefill 切碎,频繁混入 decode batch,无法命中完整 decode CUDA graph。修复后,ITL p50 从 169 ms 降至 30 ms,接受长度基本不变,为 4.72 与 4.73。
这组结果每侧只测一次;PR 作者称,更早修订版每侧交错测两次,结果相差在 2% 内。20 条固定 prompt 的贪心输出逐字节相同,共 3,197 个 completion token,但 DFlash 没有端到端实测。
预算为 512 时,旧计费算出 51 个请求,PR 观察到 52,作者没有追查这一余数差异。新计费在 --max-num-seqs 128 时算出 85,与报告一致;独立草稿上限为 512 // 5 = 102,此时没有卡住请求。
我的判断
我赞同作者把「短测没发现损失」和「足以证明可接受」分开。没有显著差异,不等于已经证明质量等价。 McNemar 检验适合比较逐题正确性,但上线门槛还要预先规定能容忍多大退化;p 值不能代替业务取舍。
样本量也有前提。1,175 题依赖 6% 翻转率、2 个百分点损失和 80% 功效,不能泛化成「凑够一千题就安全」。开放生成缺少现成的二元正确答案,数学题结果也不能直接覆盖真实流量。
相较 FLy,调度修复保留了验证规则,证据更支持优先检查这一类瓶颈。不过,2.47x 仍是特定硬件与参数下的报告结果,不能外推到所有服务。作者建议未经人工复核的下游决策保留标准验证,这是其风险取舍,并非 PR 的强制要求。
能拿来做什么
- 如果 Node 服务调用的是自建 vLLM,先按真实任务建立配对评估,固定 seeds,保存逐题结果;FLy 的窗口参数也要与测试配置一起留档。
- 如果准备开启 FLy,同时观察草稿接受率、吞吐和质量。接受率原本就高的组合,收益可能有限,并应监控那条一次性的有损验证警告。
- 如果满载时运行请求数明显低于
--max-num-seqs,可用curl -s localhost:8000/metrics | grep '^vllm:num_requests_running'查看,再核对 token 预算与启动日志中的活跃请求上限。 - 升级前检查依赖变动:Medusa 和 MLP speculator 已移除(#61701),EAGLE、MTP 的 lookahead block hashes 默认开启(#61589),CUDA 12.9 镜像停止发布,NIXL connector 要求 NIXL 1.5 或更新版本。