微软预览用 USB4 串联电脑跑大模型
微软预览在 Windows 11 上通过 USB4 实现远程直接内存访问,兼容的推理框架可利用多台电脑的内存和 GPU 协同推理。微软实测用三台各配 128GB 统一内存的迷你电脑运行 4 位量化 Qwen3-235B,生成速度约为每秒 18.5 个词元。
AI 深度解读
微软把 USB4 线缆变成了 Windows 11 电脑之间的推理通道。11 月 19 日公布的开发者预览允许两台或更多符合要求的电脑直连,由兼容的推理框架调度各机的内存和 GPU,共同运行一个本地模型。
这套方案最实在的用途,是让单机装不下的模型有机会在手头几台机器上跑起来。微软、AMD 和英特尔都给出了实测数字,但要判断它是否适合自己的工作流,得先分清跨机通信延迟、模型能否装下和生成速度这三件事。
一根 USB4 线怎么让几台电脑合跑模型?
预览版用的是远程直接内存访问(RDMA)。一台电脑可以向另一台电脑获授权的内存区域读写数据,减少 CPU 和操作系统参与搬运的次数。两台或更多符合要求的 Windows 11 电脑用 USB4 线缆连接即可搭建这条链路,省去了专用 RDMA 网卡和交换机。
可以把 RDMA 理解成更省周转的跨机搬运通道。模型怎么分到不同机器、什么时候交换中间结果,仍由兼容的推理框架负责。模型拆开以后,如果每生成一个词元都要多次等远端数据,通信时间就会进入生成路径。链路延迟越低,这部分等待越短。
微软用同一条 USB4 链路做了对照。在单次传输数据量较小的情况下,RDMA 的往返延迟约为 28 至 50 微秒,约为传统以太网 UDP 方式的四分之一。这个数字衡量的是小数据往返,对频繁交换小块数据的场景有参考价值。
三台和四台电脑分别跑出了什么结果?
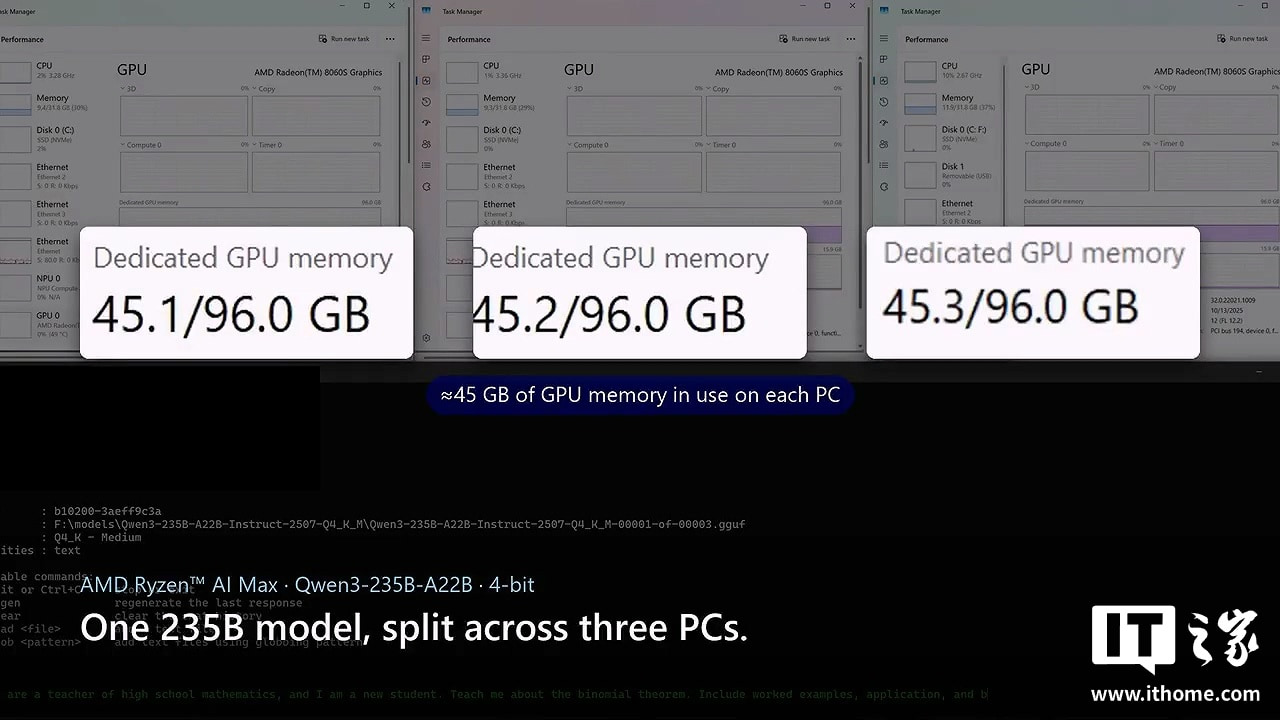
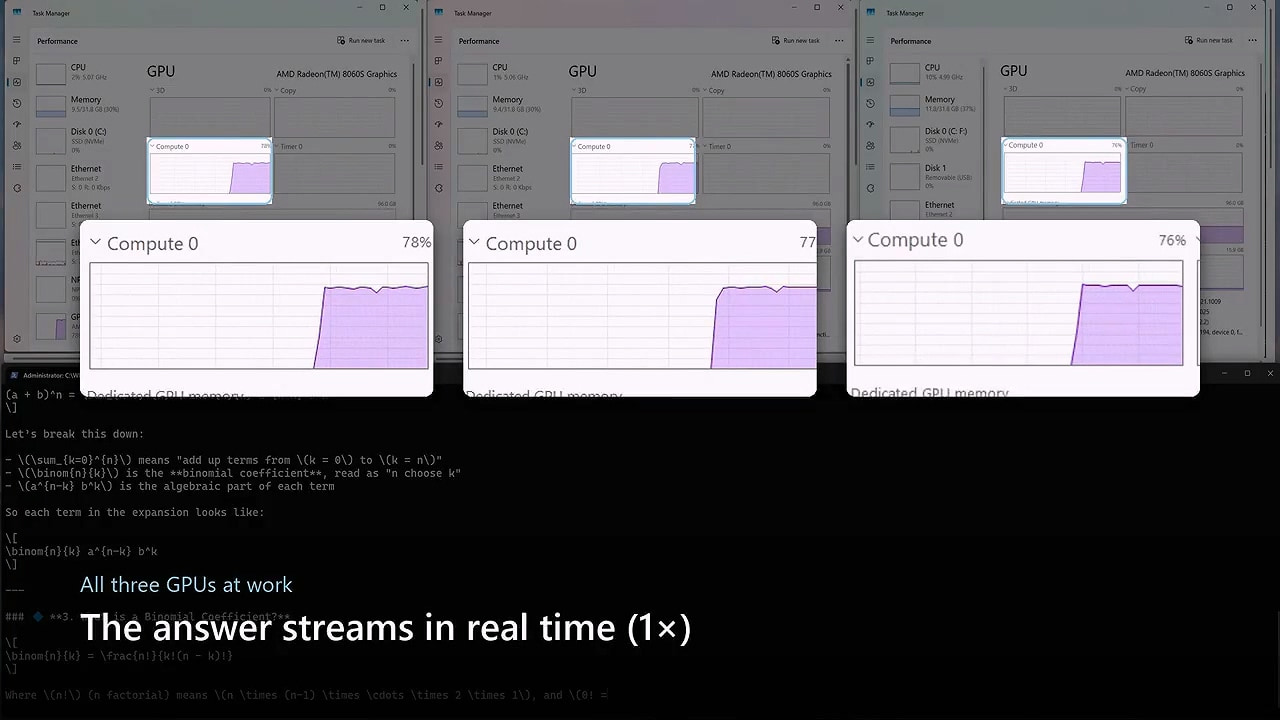
微软用三台搭载 AMD Ryzen AI Max+ 395 的迷你电脑,每台配有 128GB 统一内存,通过 40Gbps USB4 连接,跑了一个 4 位量化的 2350 亿参数 Qwen3 模型。微软测得约 18.5 词元/秒,AMD 自测约 22 词元/秒。原文没有交代两次测试的设置是否一致。
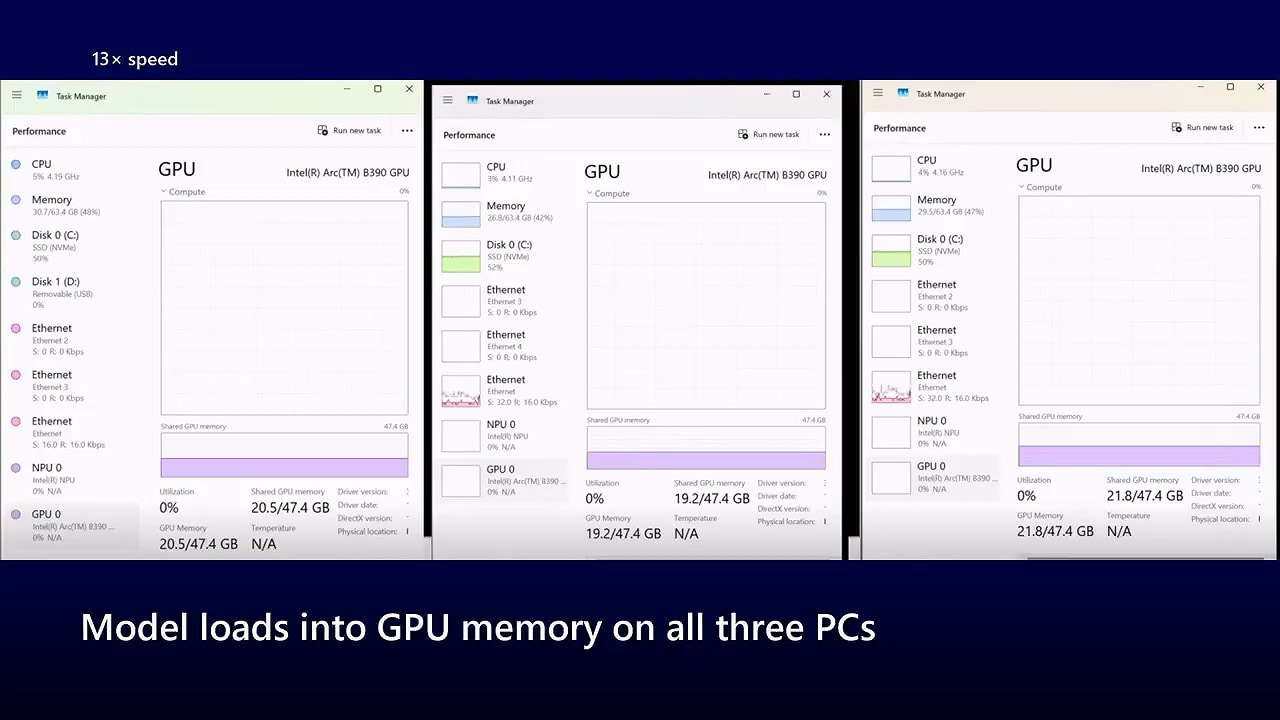
英特尔用四台各配 64GB 内存的酷睿 Ultra Series 3 电脑运行 GPT-OSS-120B,在约 1000 词元的上下文下测得 54.2 词元/秒。这组测试换了模型,也换了机器数量和平台,因此两组结果各自能说明对应配置跑到了什么速度,无法用来给两套硬件排高低。
我的判断
我会优先把这个方案当成扩充模型容量的办法。手头已经有几台满足条件的电脑,又确实需要运行单机装不下的大模型,USB4 直连就值得试。日常代码补全或仓库问答如果用单机上的较小量化模型就能做好,单机方案更容易部署,也省去了跨机同步。
报道给出了同一链路上的小数据延迟对照。端到端推理则缺少同一模型、同一上下文下的单机和多机对照,也没有把首词元等待时间和长上下文表现交代清楚。生成速度可以作为复现时的参照。至于加一台机器究竟能快多少、编辑器里用起来是否更顺,现有数字还回答不了。
能拿来做什么
- 盘点手头的 Windows 11 设备,先确认它们满足 USB4 RDMA 预览版要求,再确认所用推理框架支持跨机运行目标模型。原文没有列出完整的兼容范围。
- 给本地 AI 编程助手选模型时,用同一批仓库问答或代码修改任务,比较单机小模型与多机大模型的回答质量、首词元等待时间和生成速度,再判断多机部署的成本值不值。
- 如果 Node 服务要把模型输出流式传给前端,用接近真实工作流的上下文长度测首次出字和后续生成速度。英特尔的 54.2 词元/秒对应约 1000 词元上下文,长文件和多文件输入要另外测。